








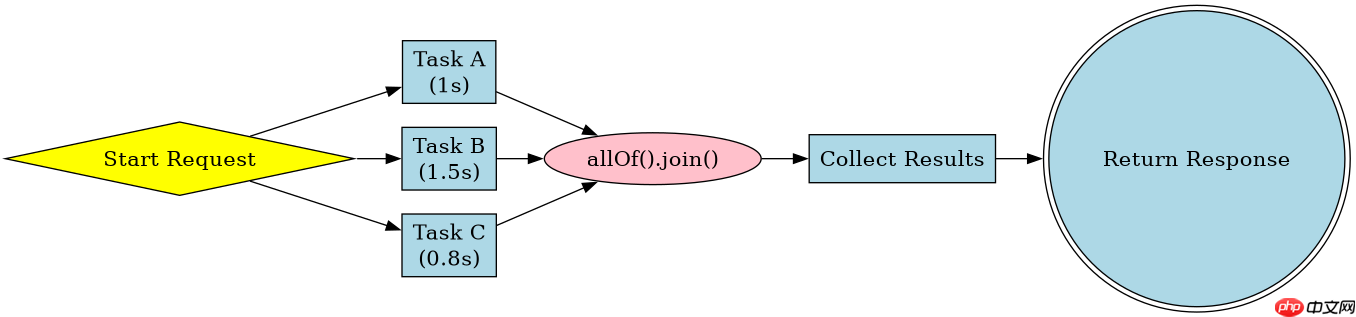
使用 completablefuture 并行调用提升响应速度的核心做法是:将多个独立的耗时任务(如远程 http 请求、数据库查询)从串行执行改为并发执行,并通过 allof() 等待所有任务完成,最后统一收集结果。具体实现时,先创建多个异步任务并绑定到自定义线程池,然后调用 completablefuture.allof(tasks).join() 阻塞直到全部完成,再遍历 future 获取各自的结果。这样做可以将总耗时从各任务耗时之和降低到接近最慢那个任务的耗时,从而显著提升整体响应速度。
如何正确配置线程池以避免资源耗尽
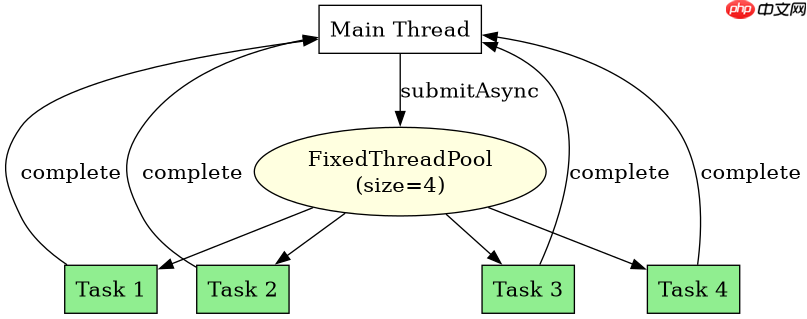
在并行调用中,必须为 supplyAsync 指定自定义的 Executor,严禁直接使用默认公共线程池,以防止阻塞关键系统线程或导致线程饥饿。最佳实践是使用 ThreadPoolExecutor 创建一个固定大小的线程池,其大小通常根据 CPU 核心数或 I/O 密集型特性设定,例如设置为 CPU 核心数的两倍或更多,以平衡上下文切换开销和并发度。
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

public class ParallelExample {
    // 定义一个固定大小的线程池,避免使用默认的 ForkJoinPool.commonPool()
    private static final ExecutorService executor = Executors.newFixedThreadPool(4);

    public static void main(String[] args) throws Exception {
        long start = System.currentTimeMillis();

        // 模拟三个独立的耗时任务
        CompletableFuture<String> task1 = CompletableFuture.supplyAsync(() -> {
            sleep(1000); // 模拟耗时操作
            return "Result 1";
        }, executor);

        CompletableFuture<String> task2 = CompletableFuture.supplyAsync(() -> {
            sleep(1500); // 模拟更长的耗时操作
            return "Result 2";
        }, executor);

        CompletableFuture<String> task3 = CompletableFuture.supplyAsync(() -> {
            sleep(800); // 模拟较短的耗时操作
            return "Result 3";
        }, executor);

        // 并行等待所有任务完成
        CompletableFuture.allOf(task1, task2, task3).join();

        // 收集结果
        String r1 = task1.get();
        String r2 = task2.get();
        String r3 = task3.get();

        long end = System.currentTimeMillis();
        System.out.println("Total Time: " + (end - start) + "ms");
        System.out.println("Results: " + r1 + ", " + r2 + ", " + r3);

        executor.shutdown();
    }

    private static void sleep(long ms) {
        try { TimeUnit.MILLISECONDS.sleep(ms); } catch (InterruptedException e) { Thread.currentThread().interrupt(); }
    }
}
上述代码展示了标准的并行调用模式。通过 Executors.newFixedThreadPool(4) 创建了四个工作线程。当调用 supplyAsync 时,任务被提交到该线程池。由于三个任务是独立且无依赖关系的,它们几乎同时开始执行。主线程在 allOf(...).join() 处挂起,直到所有三个任务都完成。最终总耗时约为 1500ms(即最长的那个任务耗时),而不是串行的 1000+1500+800=3300ms。这直接体现了并行调用的加速效果。
立即学习“Java免费学习笔记(深入)”;

Biome 是一个基于 Rust 的高性能工具链,适用于 JavaScript、TypeScript、JSX、JSON、CSS 和 GraphQL,它将格式化和 linting 统一到一个工具中。具有 97% 的 Prettier 兼容性以及超过 450 条 lint 规则,Biome 以显著更快的执行速度取代了 ESLint 和 Prettier。
如何处理单个任务失败导致的整体异常
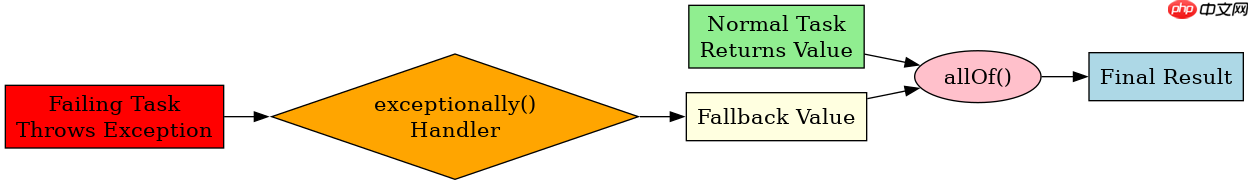
在使用 allOf() 进行并行聚合时,如果其中任何一个任务抛出异常,join() 方法会抛出 CompletionException,导致整个流程中断。为了提升系统的健壮性,需要在每个任务内部捕获异常或使用 exceptionally() 提供降级策略,确保单个任务的失败不会污染其他成功任务的结果,或者允许程序优雅地处理部分失败的情况。
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

public class FaultTolerantExample {
    private static final ExecutorService executor = Executors.newFixedThreadPool(4);

    public static void main(String[] args) {
        // 任务1:正常
        CompletableFuture<String> task1 = CompletableFuture.supplyAsync(() -> {
            sleep(500);
            return "Success 1";
        }, executor);

        // 任务2:故意抛出异常
        CompletableFuture<String> task2 = CompletableFuture.supplyAsync(() -> {
            sleep(500);
            throw new RuntimeException("Task 2 Failed");
        }, executor);

        // 任务3:正常
        CompletableFuture<String> task3 = CompletableFuture.supplyAsync(() -> {
            sleep(500);
            return "Success 3";
        }, executor);

        // 为每个任务添加异常处理,返回默认值而非抛出异常
        CompletableFuture<String> safeTask1 = task1.exceptionally(ex -> "Fallback 1");
        CompletableFuture<String> safeTask2 = task2.exceptionally(ex -> "Fallback 2");
        CompletableFuture<String> safeTask3 = task3.exceptionally(ex -> "Fallback 3");

        try {
            // 等待所有安全任务完成
            CompletableFuture.allOf(safeTask1, safeTask2, safeTask3).join();

            System.out.println("R1: " + safeTask1.get());
            System.out.println("R2: " + safeTask2.get());
            System.out.println("R3: " + safeTask3.get());
        } catch (Exception e) {
            System.err.println("Unexpected error: " + e.getMessage());
        }

        executor.shutdown();
    }

    private static void sleep(long ms) {
        try { TimeUnit.MILLISECONDS.sleep(ms); } catch (InterruptedException e) { Thread.currentThread().interrupt(); }
    }
}
这段代码演示了如何通过 exceptionally() 增强并行调用的容错能力。在之前的例子中,如果 task2 失败,allOf().join() 会直接抛出异常,程序可能崩溃或需要复杂的 try-catch 包裹。而在本例中,每个任务都绑定了 exceptionally 处理器。当 task2 抛出 RuntimeException 时,safeTask2 的状态变为完成,其值为 "Fallback 2",而不是异常状态。这样,allOf() 能够顺利等待所有三个“安全”任务完成,最终输出三个结果,其中一个是降级后的默认值。这种模式在处理外部不可靠服务(如第三方 API)时非常有效,避免了因单一依赖故障导致整个请求失败。
基于输入参数动态调整并行度
在实际业务场景中,并行调用的任务数量可能随输入数据量动态变化。例如,用户传入一个 ID 列表,需要并行查询每个 ID 对应的详情。此时,不能硬编码线程池大小或任务数量,而应根据输入列表的大小动态生成 CompletableFuture 数组,并使用 allOf 接收可变数量的参数。此外,还需注意控制并发度,防止瞬间发起过多请求导致下游服务过载。
import java.util.Arrays;
import java.util.List;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.stream.Collectors;

public class DynamicParallelExample {
    private static final ExecutorService executor = Executors.newFixedThreadPool(10);

    public static void main(String[] args) {
        List<String> ids = Arrays.asList("id1", "id2", "id3", "id4", "id5");

        // 根据输入列表动态生成并行任务
        List<CompletableFuture<String>> futures = ids.stream()
                .map(id -> CompletableFuture.supplyAsync(() -> {
                    // 模拟根据ID查询数据库
                    return "Data for " + id;
                }, executor))
                .collect(Collectors.toList());

        // 转换为数组传递给 allOf
        CompletableFuture<?>[] array = futures.toArray(new CompletableFuture[0]);

        // 等待所有动态生成的任务完成
        CompletableFuture.allOf(array).join();

        // 收集结果
        List<String> results = futures.stream()
                .map(f -> {
                    try { return f.get(); } catch (Exception e) { return null; }
                })
                .collect(Collectors.toList());

        System.out.println("Results: " + results);
        executor.shutdown();
    }
}
该示例展示了如何处理动态数量的并行任务。首先,将输入的 ID 列表通过 Stream API 映射为 CompletableFuture 对象列表。接着,将这个列表转换为 CompletableFuture>[] 数组,因为 allOf 方法接受的是可变参数(实际上是数组)。调用 allOf(array).join() 后,程序会等待所有与输入 ID 数量对应的任务完成。最后,再次遍历原始的未来列表来获取结果。这种方式灵活适配了不同规模的输入,只要线程池足够大,就能充分利用并行能力。需要注意的是,如果输入量极大(如成千上万个 ID),应引入信号量或分批处理机制,避免一次性提交过多任务压垮线程池或下游服务。



















