








java 中的 stackoverflowerror 通常由无限递归或过深的调用栈引起,处理的核心思路是消除无终止条件的递归并优化调用逻辑。具体做法包括为递归函数添加明确的退出条件、将递归改写为迭代循环,或者在必要时通过 jvm 参数调整栈内存大小。针对代码层面的修复,应优先检查是否存在未正确更新的递归状态变量,确保每次调用都能向基准情况收敛。
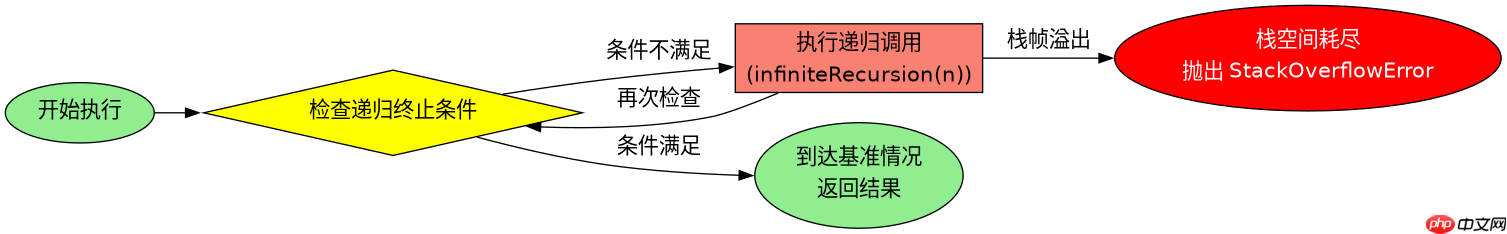
如何识别导致栈溢出的递归模式
识别此类问题的关键在于定位那些没有正确终止条件的自我调用结构。当程序陷入死循环式的递归时,栈帧会不断累积直至耗尽空间。开发者需要审查代码中所有自引用的方法,确认其是否具备基于输入变化的终止路径。若发现递归深度随时间线性增长且无边界限制,即可判定为该错误的主要诱因。
public class StackOverflowDemo {
    // 错误的递归:缺少终止条件
    public void infiniteRecursion(int n) {
        // 永远无法到达这里,因为 n 始终不变
        if (n == 0) {
            return;
        }
        // 错误:没有改变 n 的值,导致无限递归
        infiniteRecursion(n);
    }

    // 正确的递归:包含终止条件和状态更新
    public void correctRecursion(int n) {
        if (n <= 0) {
            System.out.println("Base case reached");
            return;
        }
        System.out.println("Processing: " + n);
        // 正确:n 递减,最终会达到基准情况
        correctRecursion(n - 1);
    }

    public static void main(String[] args) {
        StackOverflowDemo demo = new StackOverflowDemo();
        try {
            // 演示错误行为(实际运行会抛出异常)
            // demo.infiniteRecursion(5);

            // 演示正确行为
            demo.correctRecursion(3);
        } catch (StackOverflowError e) {
            System.err.println("Caught StackOverflowError: " + e.getMessage());
        }
    }
}
上述代码展示了两种典型的递归实现。第一种 infiniteRecursion 方法虽然包含了看似合理的 if (n == 0) 判断,但由于递归调用时传递的仍然是原始参数 n,导致条件永远无法满足,从而引发栈溢出。第二种 correctRecursion 方法则正确地递减了参数 n,确保递归最终能触及基准情况并返回。在实际开发中,应仔细检查递归调用的参数变化,确保其单调趋向于终止条件。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何将递归重构为迭代以避免栈溢出
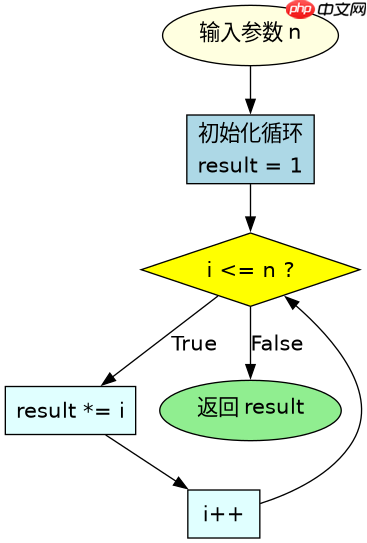
将递归算法转换为迭代形式是解决栈溢出问题的最有效手段之一。通过引入显式的栈数据结构或使用循环计数器,可以完全避免 JVM 调用栈的深度限制。这种转换特别适用于尾递归场景,其中编译器或手动优化可以将递归步骤转化为简单的循环跳转。对于非尾递归,可能需要模拟调用栈的行为来保存中间状态。
import java.util.Stack;

public class RecursionToIteration {
    // 使用显式栈模拟递归过程
    public int iterativeFactorial(int n) {
        if (n < 0) {
            throw new IllegalArgumentException("Negative input not allowed");
        }

        Stack<Integer> stack = new Stack<>();
        int result = 1;

        // 将所有待处理的数字压入栈
        for (int i = n; i > 1; i--) {
            stack.push(i);
        }

        // 依次弹出并计算
        while (!stack.isEmpty()) {
            result *= stack.pop();
        }

        return result;
    }

    // 更简洁的迭代实现(针对阶乘)
    public int simpleIterativeFactorial(int n) {
        int result = 1;
        for (int i = 2; i <= n; i++) {
            result *= i;
        }
        return result;
    }

    public static void main(String[] args) {
        RecursionToIteration converter = new RecursionToIteration();
        System.out.println("Iterative factorial of 5: " + converter.iterativeFactorial(5));
        System.out.println("Simple iterative factorial of 5: " + converter.simpleIterativeFactorial(5));
    }
}
以上代码提供了将递归转换为迭代的两种策略。第一种 iterativeFactorial 使用 java.util.Stack 显式管理调用状态,适用于复杂递归逻辑的通用转换。第二种 simpleIterativeFactorial 则针对特定算法(如阶乘)进行了简化,直接使用循环变量替代栈操作。在实际应用中,应根据算法复杂度选择适当的转换方式,优先考虑简单循环以实现最佳性能。
当递归深度较大时如何调整JVM栈内存
在某些必须使用深层递归的场景下,可以通过调整 JVM 启动参数 -Xss 来增加每个线程的栈内存大小。这并非长久之计,但可作为临时解决方案应对不可避免的深递归需求。例如,设置 -Xss2m 可将栈大小从默认的 1MB 增加到 2MB,从而允许更深的调用层级。然而,这种方法仅能延缓问题发生,不能从根本上消除递归设计缺陷。
// 编译命令
javac RecursionWithLargeStack.java

// 运行命令,设置栈大小为 4MB
java -Xss4m RecursionWithLargeStack
public class RecursionWithLargeStack {
    private static int depth = 0;

    public void deepRecursion() {
        depth++;
        if (depth < 100000) { // 尝试较深的递归
            deepRecursion();
        } else {
            System.out.println("Reached max depth: " + depth);
        }
    }

    public static void main(String[] args) {
        RecursionWithLargeStack app = new RecursionWithLargeStack();
        try {
            app.deepRecursion();
        } catch (StackOverflowError e) {
            System.err.println("Stack overflow occurred at depth: " + depth);
        }
    }
}
该示例展示了如何通过命令行参数 -Xss 控制栈内存。程序 RecursionWithLargeStack 执行了十万次递归调用,这在默认栈配置下必然失败。通过指定较大的栈大小,程序得以成功运行至设定的深度阈值。需要注意的是,过度依赖此方法可能导致内存资源浪费,且在极端情况下仍可能触发溢出。因此,它仅适用于那些因历史原因难以重构的遗留系统,新代码应始终坚持迭代或尾递归优化的原则。



















