








java jdbc 处理批量操作性能优化的核心做法是开启事务自动提交关闭、使用 addbatch() 与 executebatch() 组合,并配合 rewritebatchedstatements=true 驱动参数。这样可以将多次 sql 执行合并为一次网络往返,显著降低 i/o 开销。

为什么默认逐条插入慢
默认情况下,JDBC 每执行一条 executeUpdate() 都会向数据库发送一次请求并等待响应。在数据量大时,这种频繁的网络交互成为瓶颈。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchDemo {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        try (Connection conn = DriverManager.getConnection(url, "user", "pass");
             PreparedStatement ps = conn.prepareStatement("INSERT INTO t VALUES (?)")) {
            conn.setAutoCommit(false);
            for (int i = 0; i < 1000; i++) {
                ps.setInt(1, i);
                ps.addBatch();
            }
            ps.executeBatch();
            conn.commit();
        }
    }
}
上述代码中,setAutoCommit(false) 确保所有操作在一个事务中完成,避免每条语句都触发一次磁盘刷盘。ps.addBatch() 将 SQL 暂存,直到 executeBatch() 才统一发送。MySQL 驱动在开启 rewriteBatchedStatements 后,会将多条 INSERT 合并为一条 INSERT ... VALUES (...), (...) 语句,进一步减少解析开销。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何控制批次大小
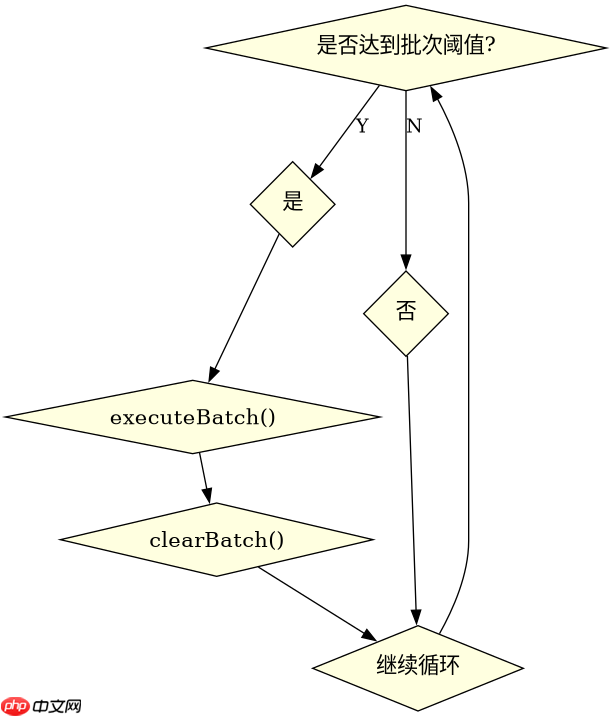
虽然批量提交能提升性能,但过大的批次可能导致内存溢出或事务锁竞争。通常建议每 500 到 1000 条执行一次 executeBatch(),并适时 commit()。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class ChunkedBatch {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        try (Connection conn = DriverManager.getConnection(url, "user", "pass");
             PreparedStatement ps = conn.prepareStatement("INSERT INTO t VALUES (?)")) {
            conn.setAutoCommit(false);
            int count = 0;
            for (int i = 0; i < 10000; i++) {
                ps.setInt(1, i);
                ps.addBatch();
                count++;
                if (count % 1000 == 0) {
                    ps.executeBatch();
                    conn.commit();
                    ps.clearBatch();
                }
            }
            if (count % 1000 != 0) {
                ps.executeBatch();
                conn.commit();
            }
        }
    }
}
该示例展示了分块提交的逻辑:每累积 1000 条记录就执行一次 executeBatch() 和 commit(),并通过 clearBatch() 清空缓存,防止内存持续增长。这种方式在保证吞吐量的同时,控制了单次事务的大小,适合大数据量导入场景。
当遇到主键冲突时如何处理
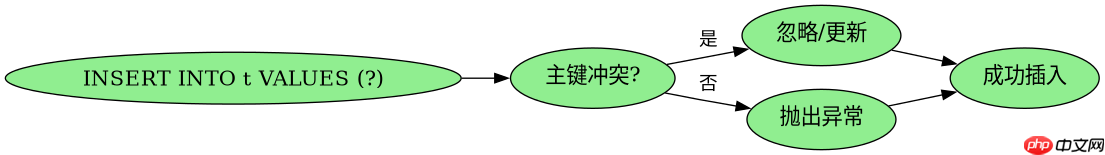
如果批量插入的数据中存在重复主键,默认会抛出异常并中断整个批次。为避免单条错误导致全部回滚,可在 SQL 中使用 INSERT IGNORE 或 ON DUPLICATE KEY UPDATE。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class ConflictBatch {
    public static void main(String[] args) throws Exception {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        try (Connection conn = DriverManager.getConnection(url, "user", "pass");
             PreparedStatement ps = conn.prepareStatement(
                 "INSERT INTO t VALUES (?) ON DUPLICATE KEY UPDATE id=id")) {
            conn.setAutoCommit(false);
            for (int i = 0; i < 100; i++) {
                ps.setInt(1, i % 10); // 模拟重复主键
                ps.addBatch();
            }
            ps.executeBatch();
            conn.commit();
        }
    }
}
此代码中,ON DUPLICATE KEY UPDATE id=id 使得重复行被忽略而非报错,从而保证整个批次顺利执行。若需区分成功与跳过,可检查 executeBatch() 返回的数组,其中负值表示被忽略的行。


















