








java 中的 forkjoinpool 专为处理可递归分解为子任务的计算密集型工作而设计,核心用法是提交继承自 forkjointask 的任务(如 recursiveaction 或 recursivetask)并调用 invoke() 方法。通过重写 compute() 方法实现分治逻辑,当任务规模小于阈值时直接执行,否则拆分为两个子任务并使用 fork() 异步执行、join() 等待结果,最终由主线程汇总返回。这种机制利用工作窃取算法高效调度空闲线程,避免传统线程池在大量阻塞或细粒度任务上的开销。

ForkJoinPool 的初始化与基本提交流程是怎样的
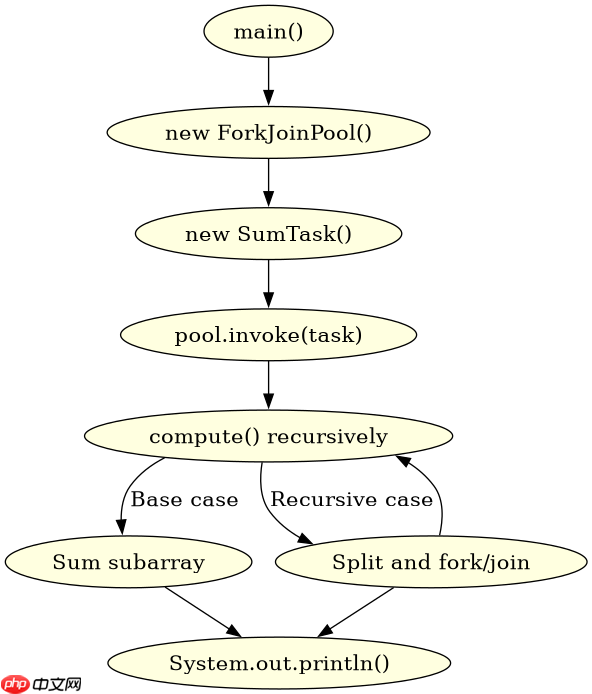
创建 ForkJoinPool 实例后,可直接提交任务或通过 execute() 启动异步执行。默认构造函数使用可用处理器数量作为并行度,也可显式指定线程数。提交 RecursiveTask 后,调用 invoke() 会同步等待结果返回,这是最常用的同步模式。若只需触发执行而不关心返回值,可使用 execute() 配合 awaitTermination() 进行控制。任务内部必须正确实现拆分逻辑,否则可能导致栈溢出或无限递归。
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveTask;

public class SumTask extends RecursiveTask<Long> {
    private final long[] array;
    private final int start;
    private final int end;
    private static final int THRESHOLD = 100;

    public SumTask(long[] array, int start, int end) {
        this.array = array;
        this.start = start;
        this.end = end;
    }

    @Override
    protected Long compute() {
        if (end - start <= THRESHOLD) {
            long sum = 0;
            for (int i = start; i < end; i++) {
                sum += array[i];
            }
            return sum;
        } else {
            int mid = (start + end) / 2;
            SumTask left = new SumTask(array, start, mid);
            SumTask right = new SumTask(array, mid, end);
            left.fork();
            right.fork();
            return left.join() + right.join();
        }
    }

    public static void main(String[] args) {
        long[] data = new long[10000];
        for (int i = 0; i < data.length; i++) {
            data[i] = i;
        }
        ForkJoinPool pool = new ForkJoinPool();
        SumTask task = new SumTask(data, 0, data.length);
        Long result = pool.invoke(task);
        System.out.println("Result: " + result);
    }
}
运行上述代码将输出数组所有元素之和。输入为长度为 10000 的长整型数组,阈值为 100,拆分至子数组长度小于等于 100 时停止递归并求和。预期结果为 499950000,类型为 Long。无异常抛出,因输入非空且逻辑完整。若输入为空数组,compute() 中循环不执行,返回 0,符合预期。

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
立即学习“Java免费学习笔记(深入)”;
如何验证 ForkJoinPool 的工作窃取行为
工作窃取是 ForkJoinPool 的核心调度机制:当某线程完成自身任务队列中的所有任务后,会从其他繁忙线程的队列尾部窃取任务执行。可通过自定义 RecursiveTask 添加延迟模拟耗时操作,观察线程活动情况。例如,让部分任务休眠较长时间,其他任务快速完成,空闲线程会自动窃取剩余任务。这种行为提升了 CPU 利用率,尤其适用于任务执行时间不均的场景。验证时需确保任务足够小且数量多,以触发窃取机制。
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.RecursiveTask;
import java.util.concurrent.TimeUnit;

public class StolenTask extends RecursiveTask<String> {
    private final String name;
    private final boolean slow;

    public StolenTask(String name, boolean slow) {
        this.name = name;
        this.slow = slow;
    }

    @Override
    protected String compute() {
        if (slow) {
            try {
                TimeUnit.MILLISECONDS.sleep(500);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
        return name + " done";
    }

    public static void main(String[] args) throws Exception {
        ForkJoinPool pool = new ForkJoinPool(4);
        StolenTask fast1 = new StolenTask("Fast1", false);
        StolenTask fast2 = new StolenTask("Fast2", false);
        StolenTask slow1 = new StolenTask("Slow1", true);
        StolenTask slow2 = new StolenTask("Slow2", true);

        fast1.fork();
        fast2.fork();
        slow1.fork();
        slow2.fork();

        System.out.println(fast1.join());
        System.out.println(fast2.join());
        System.out.println(slow1.join());
        System.out.println(slow2.join());

        pool.shutdown();
        pool.awaitTermination(10, TimeUnit.SECONDS);
    }
}
该程序提交四个任务,其中两个快速完成,两个慢速执行。由于 ForkJoinPool 的工作窃取特性,快速任务完成后,其线程可能窃取慢速任务或其他待处理任务。输出顺序不确定,但所有任务均会完成。预期输出包含四个字符串,格式为 "Name done"。无异常,因未处理中断以外的错误。若线程数少于任务数,仍能保证所有任务执行,体现窃取优势。
当任务拆分阈值设置过小会导致什么问题
若任务拆分阈值设置过小,会导致递归深度增加,产生大量细粒度任务对象,进而引发内存开销增大和上下文切换频繁。每个任务都需分配堆空间存储状态,过多任务可能触发垃圾回收压力,甚至导致 OutOfMemoryError。此外,任务调度开销超过计算收益,整体性能下降。合理阈值应基于任务计算复杂度与系统资源平衡,通常通过基准测试确定。对于简单求和等轻量操作,阈值设为 100~1000 较为合适;复杂计算可适当提高。
















