








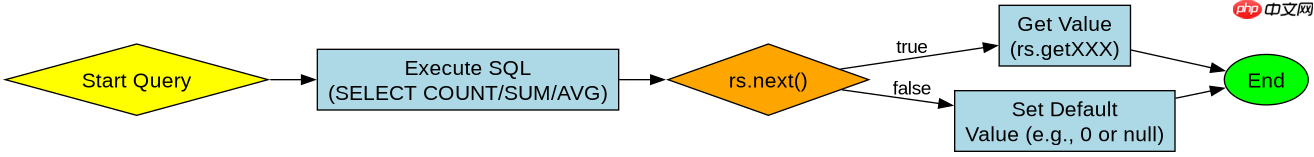
java jdbc 处理聚合函数查询的标准做法是执行 sql 语句并调用 resultset.next() 获取结果,随后通过 resultset.getxxx() 方法提取聚合值。由于聚合操作通常返回单行数据,无需遍历循环,直接定位到第一行即可读取列值。若查询结果为空或无匹配记录,next() 将返回 false,此时需根据业务逻辑判断是否赋予默认值。
如何安全地获取 COUNT 查询的返回值
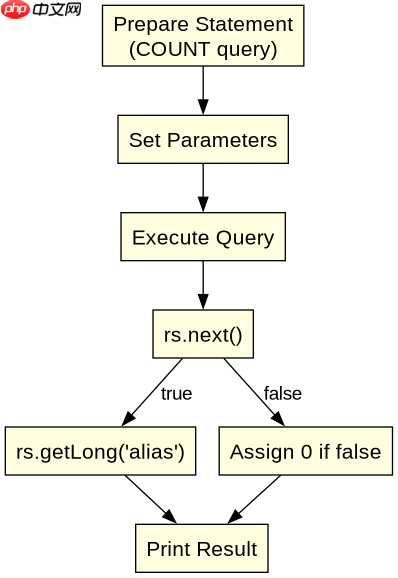
针对 COUNT(*) 查询,核心在于处理可能出现的空结果集。当数据库中没有满足条件的记录时,ResultSet 不会包含任何行,直接调用 getLong() 会抛出异常。因此,必须在获取值之前检查 next() 的返回值,确保游标已移动到有效数据行上。
import java.sql.*;

public class CountQueryExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 模拟一个可能没有数据的查询
        String sql = "SELECT COUNT(*) as total FROM users WHERE status = ?";
        int status = 999; // 假设这是一个不存在的状态

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            pstmt.setInt(1, status);
            ResultSet rs = pstmt.executeQuery();

            long count = 0;
            if (rs.next()) {
                // 使用别名 'total' 获取值
                count = rs.getLong("total");
            }
            System.out.println("Count result: " + count);
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
上述代码中,status = 999 确保了查询结果为空。程序首先尝试移动游标,如果 rs.next() 为 false,则保持 count 为初始值 0。这种模式避免了 SQLException,并正确处理了零记录的情况。预期输出为 Count result: 0。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何处理 SUM 和 AVG 的空值与类型转换
在处理 SUM() 或 AVG() 时,除了空结果集的问题,还需注意数值类型的精度和空值(NULL)的处理。如果表中存在 NULL 值,聚合函数会自动忽略它们,但如果所有参与计算的字段均为 NULL 或结果为空,数据库可能返回 SQL NULL。在 Java 中,这对应于 null 引用或特定类型的零值,需进行显式检查以防止算术错误。

import java.sql.*;

public class SumAvgQueryExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        String sql = "SELECT SUM(amount) as total_sum, AVG(amount) as avg_amount FROM orders WHERE amount > ?";
        double threshold = 100.0;

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            pstmt.setDouble(1, threshold);
            ResultSet rs = pstmt.executeQuery();

            if (rs.next()) {
                // 检查是否为 null,因为 SUM/AVG 可能返回 SQL NULL
                Double sumVal = rs.getObject("total_sum", Double.class);
                Double avgVal = rs.getObject("avg_amount", Double.class);

                if (sumVal != null && avgVal != null) {
                    System.out.printf("Sum: %.2f, Avg: %.2f%n", sumVal, avgVal);
                } else {
                    System.out.println("No valid data found for aggregation.");
                }
            } else {
                System.out.println("Query returned no rows.");
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
此示例使用了 getObject(columnName, Class) 方法来安全地获取可能为空的数值。如果 amount 列中所有大于 100.0 的记录都不存在或值为 NULL,sumVal 和 avgVal 将为 null。通过检查这些对象是否为 null,可以优雅地处理边界情况。预期输出取决于数据库内容,若无匹配数据,则输出 No valid data found for aggregation.。
当聚合查询涉及多表连接时如何处理重复计数
在涉及多表连接的聚合查询中,最常见的陷阱是因一对多关系导致的计数重复。例如,统计每个用户的订单数时,如果直接使用 COUNT(*) 而不分组,或者在子查询中未正确关联,可能会得到错误的总数。正确的做法是使用 GROUP BY 结合 COUNT(),并确保连接条件准确,以避免笛卡尔积带来的膨胀。
import java.sql.*;

public class JoinAggregationExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test";
        String user = "root";
        String password = "password";

        // 查询每个用户及其订单数量,避免重复
        String sql = "SELECT u.id, u.name, COUNT(o.id) as order_count " +
                     "FROM users u LEFT JOIN orders o ON u.id = o.user_id " +
                     "GROUP BY u.id, u.name";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement();
             ResultSet rs = stmt.executeQuery(sql)) {

            while (rs.next()) {
                int userId = rs.getInt("id");
                String userName = rs.getString("name");
                int orderCount = rs.getInt("order_count");
                System.out.printf("User: %s (%d), Orders: %d%n", userName, userId, orderCount);
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
该代码使用 LEFT JOIN 确保即使没有订单的用户也被列出,其 order_count 将为 0。COUNT(o.id) 仅计算非空的订单 ID,从而准确反映每个用户的实际订单数。通过 GROUP BY 对 u.id 和 u.name 进行分组,保证了结果的唯一性和准确性。预期输出将列出所有用户及其对应的订单数量,无重复项。
















