








java hashset 对小集合去重的优化核心在于避免对象创建和哈希冲突开销,具体做法是改用基于数组的线性扫描或排序后双指针去重。对于数据量极小(例如少于10个元素)的场景,hashset 的初始化、哈希计算和节点分配成本往往高于直接遍历比较,此时使用原生数组配合循环判断能显著降低内存分配和cpu周期消耗。
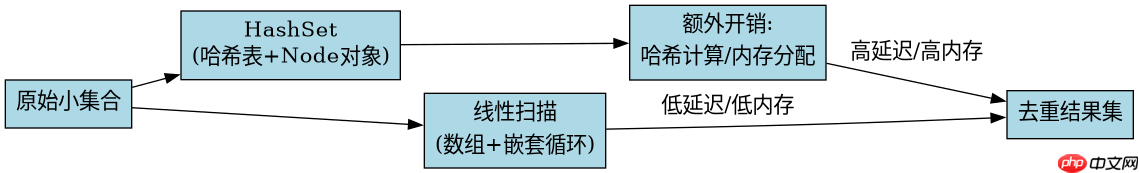
为什么小集合用 HashSet 反而慢
HashSet 底层依赖 HashMap,每次添加元素都要计算哈希码、处理潜在冲突并分配 Node 对象。当集合元素很少时,这些固定开销占比极高。相比之下,ArrayList 或原生数组没有哈希表结构,内存布局紧凑,缓存命中率高。
import java.util.*;

public class SmallSetOptimization {
    public static void main(String[] args) {
        Integer[] data = {1, 2, 2, 3, 3, 3, 4};

        // 方法1: 传统 HashSet (基准)
        Set<Integer> set = new HashSet<>(Arrays.asList(data));
        System.out.println("HashSet size: " + set.size());

        // 方法2: 数组线性去重 (优化)
        int[] unique = linearDedup(data);
        System.out.print("Linear dedup: ");
        for (int v : unique) System.out.print(v + " ");
        System.out.println();
    }

    private static int[] linearDedup(Integer[] input) {
        if (input.length == 0) return new int[0];
        int[] temp = new int[input.length];
        int count = 0;
        temp[0] = input[0];
        count++;

        for (int i = 1; i < input.length; i++) {
            boolean exists = false;
            for (int j = 0; j < count; j++) {
                if (temp[j] == input[i]) {
                    exists = true;
                    break;
                }
            }
            if (!exists) {
                temp[count++] = input[i];
            }
        }
        return Arrays.copyOf(temp, count);
    }
}
上述代码展示了两种实现。HashSet 方式虽然简洁,但涉及自动装箱和哈希表操作。线性去重方式通过两层循环直接比较,避免了额外对象创建。在元素极少时,这种简单逻辑的执行路径更短,且不需要维护复杂的内部状态。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
排序后双指针去重策略
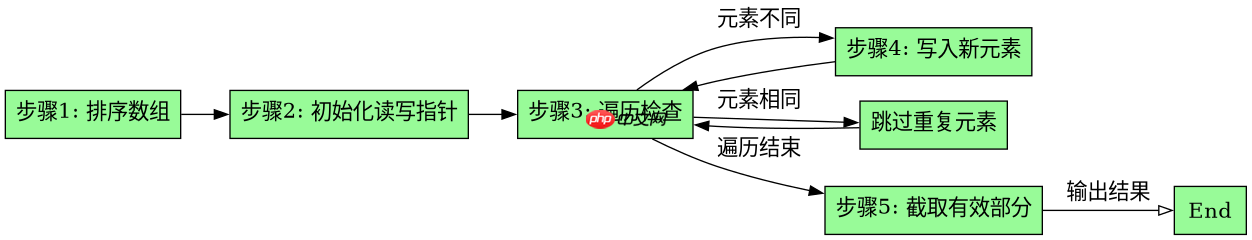
如果允许修改原数据顺序,先排序再使用双指针去重是另一种高效方案。排序后相同元素相邻,只需一次遍历即可剔除重复项。这种方法的时间复杂度为 O(N log N),但在小数据量下常数因子极小,且空间复杂度可控制在 O(1) 或 O(N) 取决于是否原地排序。
import java.util.*;

public class SortDedup {
    public static void main(String[] args) {
        Integer[] data = {3, 1, 2, 3, 1, 4};
        Arrays.sort(data);

        int writeIndex = 0;
        for (int readIndex = 1; readIndex < data.length; readIndex++) {
            if (!data[readIndex].equals(data[writeIndex])) {
                writeIndex++;
                data[writeIndex] = data[readIndex];
            }
        }

        // 结果在 data[0...writeIndex]
        System.out.println("Unique count: " + (writeIndex + 1));
    }
}
该段代码演示了排序去重的过程。首先对数组进行升序排列,然后使用两个索引指针。读指针遍历整个数组,写指针指向当前唯一元素的末尾。当发现新元素与写指针所指元素不同时,将其写入下一个位置。最终有效范围即为去重后的结果。这种方式在处理小规模整数或可比较对象时非常高效。
基于输入长度阈值的动态选择
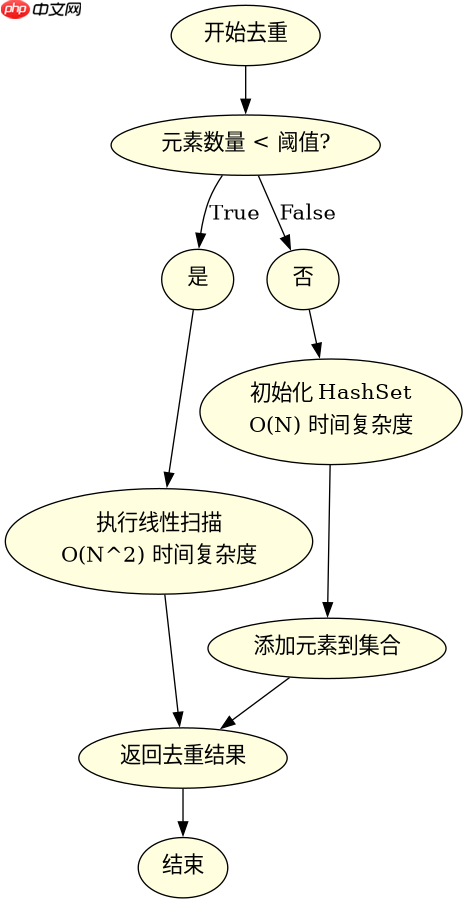
在实际工程中,最佳实践是根据输入集合的大小动态切换算法。当元素数量低于某个阈值(如5或10)时,使用线性扫描或排序去重;超过阈值则切换到 HashSet。这种混合策略能兼顾小数据的低开销和大数据的高性能。



















