








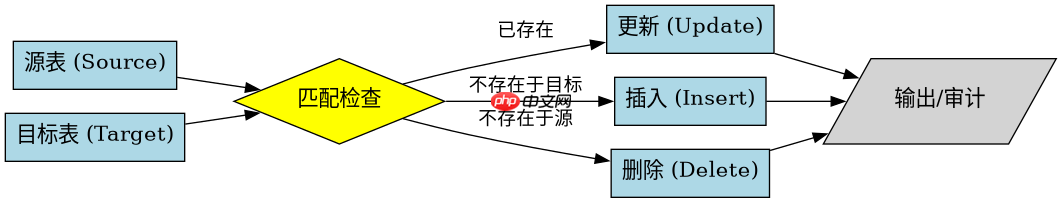
在sql server 2022中,使用merge语句的最佳实践是将其作为单一语句处理数据同步的核心工具,通过明确指定源表和目标表的连接条件,并分别定义when matched、when not matched by source和when not matched by target三种情况下的具体操作(update、insert或delete),可以高效地完成“upsert”逻辑。关键在于必须为每个匹配分支提供明确的动作,避免遗漏导致的数据静默丢失,同时利用output子句捕获变更详情以便审计或后续处理。
MERGE语句如何处理目标表中存在但源表中缺失的记录?
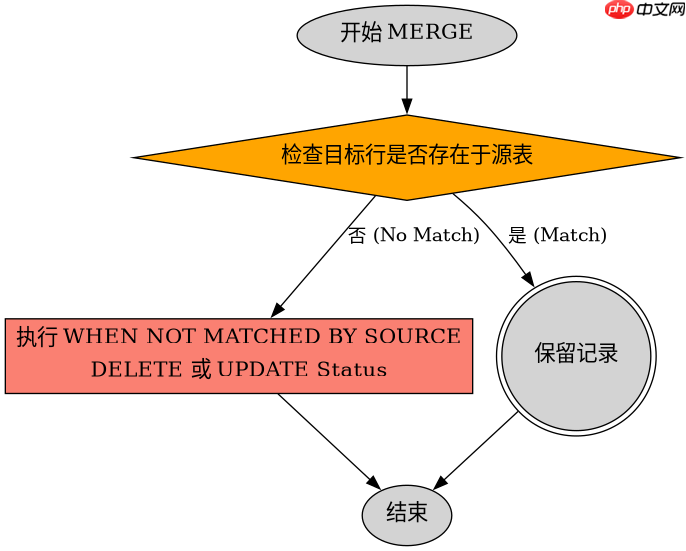
当目标表中存在记录但在源表中找不到对应匹配项时,可以通过WHEN NOT MATCHED BY SOURCE子句来执行删除操作或更新状态字段。这是实现软删除或归档旧数据的常用模式,确保目标表的数据集与源系统保持严格一致。
CREATE TABLE #Target (ID INT, Name VARCHAR(50), Status VARCHAR(10));
CREATE TABLE #Source (ID INT, Name VARCHAR(50));

INSERT INTO #Target VALUES (1, 'Alice', 'Active'), (2, 'Bob', 'Active');
INSERT INTO #Source VALUES (1, 'Alice Updated');

MERGE #Target AS T
USING #Source AS S ON T.ID = S.ID
WHEN MATCHED THEN UPDATE SET T.Name = S.Name
WHEN NOT MATCHED BY SOURCE THEN DELETE;

SELECT * FROM #Target;
上述代码将删除ID为2的Bob记录,因为源表中没有该ID。预期结果是#Target表中仅保留ID为1且Name为'Alice Updated'的记录。
如何安全地处理MERGE中的键冲突与重复源数据?
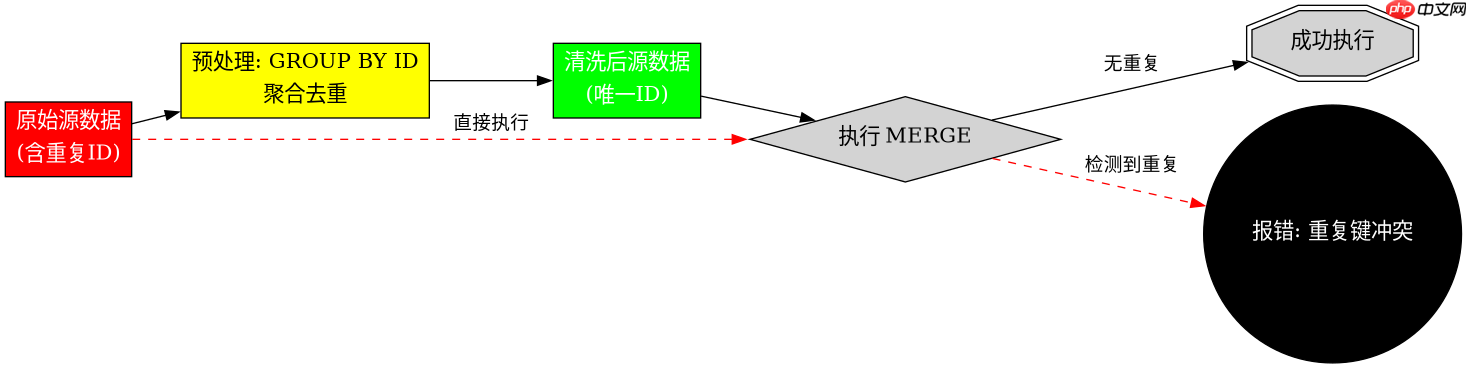
如果源表包含针对同一目标键的多行记录,MERGE语句会抛出错误并终止事务。最佳实践是在MERGE之前对源数据进行去重或使用聚合函数,或者在应用层确保源数据的唯一性。此外,SQL Server 2022并未改变这一行为,因此预防性清洗源数据是避免运行时异常的关键。
-- 假设源表有重复ID
CREATE TABLE #DupSource (ID INT, Name VARCHAR(50));
INSERT INTO #DupSource VALUES (1, 'A'), (1, 'B');

-- 直接MERGE会报错:The MERGE statement attempted to UPDATE or DELETE the same row more than once.
-- 正确做法:先聚合
MERGE #Target AS T
USING (SELECT ID, MAX(Name) as Name FROM #DupSource GROUP BY ID) AS S ON T.ID = S.ID
WHEN MATCHED THEN UPDATE SET T.Name = S.Name
WHEN NOT MATCHED BY SOURCE THEN DELETE;

SELECT * FROM #Target;
通过对源数据按ID分组并取最大值,避免了重复键冲突。预期结果是ID为1的记录被更新为'B'(假设MAX返回B)。
MERGE语句在执行过程中如何记录变更历史?
为了追踪数据变更,应始终结合OUTPUT子句使用MERGE。它可以返回插入、更新或删除的每一行的详细信息,包括旧值和新值,这对于构建审计日志或触发下游ETL流程至关重要。在SQL Server 2022中,这种机制依然稳定且高效,建议将输出结果直接插入到历史表中。


















