








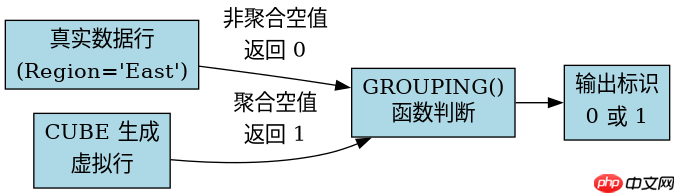
使用 grouping() 函数可以明确区分 cube 或 rollup 生成的虚拟小计/合计行与真实数据行。具体做法是在 select 列表中调用该函数并传入分组列,当某列为 cube 产生的空值时返回 1,否则返回 0。通过判断返回值是否为 1,即可在查询结果中准确标记出哪些是汇总行。
CUBE 生成的小计行如何识别?
CUBE 操作会生成所有可能的列组合,其中包含部分列值为空的行即为小计行。GROUPING() 函数针对每一列单独判断,若该列在聚合层级中为空(即由 CUBE 产生),则返回 1;若为实际数据中的 NULL 值,则返回 0。利用这一特性,可以构建一个标识列来区分不同层级的汇总。
CREATE TABLE Sales (Region VARCHAR(10), Product VARCHAR(10), Amount INT);
INSERT INTO Sales VALUES ('East', 'A', 100), ('East', 'B', 200), ('West', 'A', 150);

SELECT Region, Product, SUM(Amount) as Total,
       GROUPING(Region) as g_Reg,
       GROUPING(Product) as g_Prod
FROM Sales
GROUP BY CUBE (Region, Product);
运行上述代码后,观察结果集:
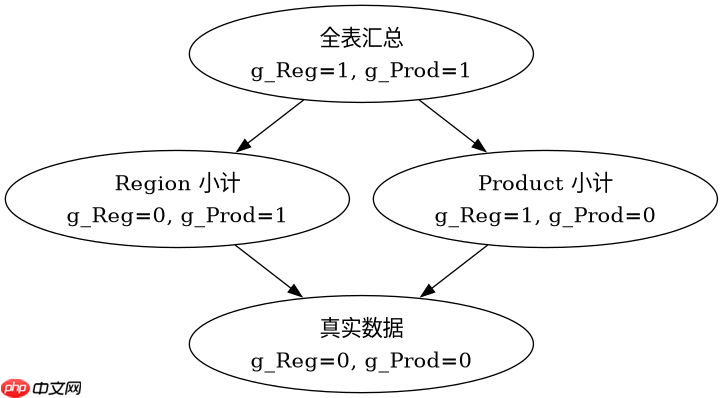
- 真实数据行:g_Reg 和 g_Prod 均为 0。
- Region 小计行(如 East 总计):Region 有值,Product 为 NULL,故 g_Reg=0, g_Prod=1。
- Product 小计行(如 A 总计):Region 为 NULL,Product 有值,故 g_Reg=1, g_Prod=0。
- 总合计行:Region 和 Product 均为 NULL,故 g_Reg=1, g_Prod=1。
如何利用 GROUPING_ID 简化多层级汇总标记?
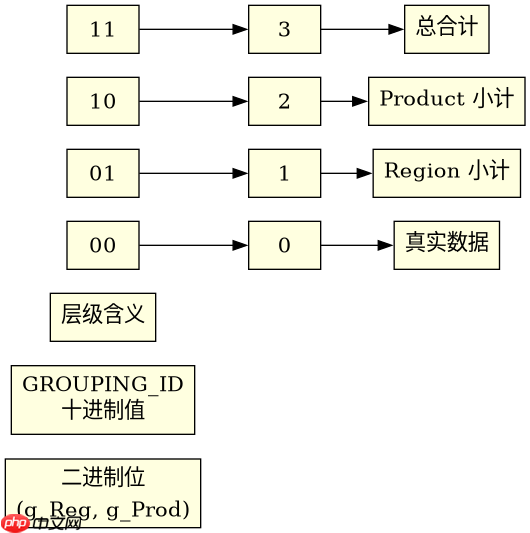
当分组维度较多时,逐个检查每个 GROUPING() 返回值变得繁琐。GROUPING_ID() 函数接受多个列作为参数,将它们的 GROUPING 返回值视为二进制位,转换为十进制整数。这使得我们可以通过单一数值快速判断当前行属于哪个汇总层级。
SELECT Region, Product, SUM(Amount) as Total,
       GROUPING_ID(Region, Product) as grp_id
FROM Sales
GROUP BY CUBE (Region, Product);基于同一输入数据,GROUPING_ID 的计算逻辑如下:
- 真实数据行:二进制 00,十进制 0。
- Region 小计行:二进制 01(假设 Region 为高位),十进制 1。
- Product 小计行:二进制 10,十进制 2。
- 总合计行:二进制 11,十进制 3。
开发者可以通过判断 grp_id 的值来应用不同的样式或逻辑,例如当 grp_id > 0 时标记为汇总行。
当原始数据包含 NULL 时 GROUPING() 如何处理?
在真实业务场景中,数据列本身可能包含 NULL 值。这是 GROUPING() 函数最核心的价值所在:它严格区分“因聚合而缺失的列”和“原本就存在的 NULL”。如果某行的 Region 字段在数据库中就是 NULL,且该行未被聚合,GROUPING(Region) 仍返回 0。只有当 CUBE 或
ROLLUP</sup> 机制将该列置为空以生成汇总行时,才返回 1。</p><pre class="brush:php;toolbar:false;">INSERT INTO Sales VALUES (NULL, 'C', 50);

SELECT Region, Product, SUM(Amount) as Total,
       GROUPING(Region) as g_Reg
FROM Sales
GROUP BY ROLLUP (Region, Product);
执行上述带有原始 NULL 数据的查询:
- 原始 <code>NULL 行:Region 为 NULL,但 g_Reg 为 0,表明这是真实数据。
- Region 小计行:Region 为 NULL,但 g_Reg 为 1,表明这是汇总产生的空值。
这种区分确保了在报表展示或后续处理中,不会将真实的缺失数据误判为汇总项,也不会将汇总项误判为普通记录。


















