








在sql中根据业务场景准确选择rank与row_number,核心在于是否需要处理并列排名以及是否要求排名连续。如果数据中存在重复值且你希望相同的值获得相同的排名,同时跳过后续名次(例如两个第1名后直接是第3名),应使用rank();如果无论是否有重复值,你都希望每一行都有唯一的、连续的序号(例如两个第1名后接着是第2名),则应使用row_number()。具体做法是在select语句中使用对应的窗口函数,并配合over子句指定partition by分组和order by排序字段。
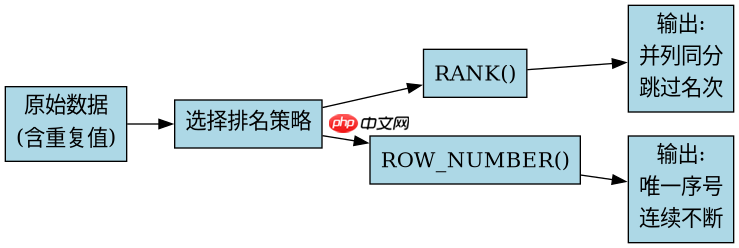
RANK()函数如何处理并列数据
RANK()函数在遇到相同排序值时,会赋予它们相同的排名,并在后续排名中跳过被占用的名额。这意味着如果有两个并列第一,下一个排名将是第三。这种特性适用于需要体现“并列”概念的业务场景,如比赛成绩排名或销售额并列前几名。
WITH SalesData AS (
    SELECT 'Alice' AS Name, 1000 AS Amount
    UNION ALL SELECT 'Bob', 1000
    UNION ALL SELECT 'Charlie', 800
    UNION ALL SELECT 'David', 600
)
SELECT
    Name,
    Amount,
    RANK() OVER (ORDER BY Amount DESC) as Rank_Result
FROM SalesData;
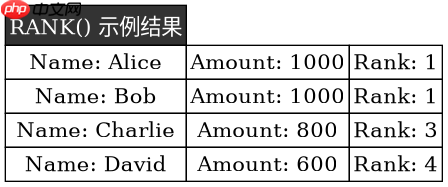
上述代码执行后,Alice和Bob的排名均为1,Charlie的排名为3,David的排名为4。这验证了RANK()在遇到相同Amount值时返回相同排名,并跳过了第2名。
ROW_NUMBER()如何生成唯一连续序号
ROW_NUMBER()函数为结果集中的每一行分配一个唯一的整数,从1开始递增。即使排序字段完全相同,它也会强制给出不同的序号。这适用于需要分页显示、提取每组第一条记录或生成唯一序列号的场景,因为它保证了排名的绝对唯一性和连续性。
WITH SalesData AS (
    SELECT 'Alice' AS Name, 1000 AS Amount
    UNION ALL SELECT 'Bob', 1000
    UNION ALL SELECT 'Charlie', 800
    UNION ALL SELECT 'David', 600
)
SELECT
    Name,
    Amount,
    ROW_NUMBER() OVER (ORDER BY Amount DESC) as RowNum_Result
FROM SalesData;
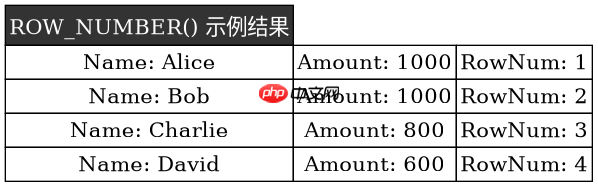
上述代码执行后,Alice获得1,Bob获得2,Charlie获得3,David获得4。尽管Alice和Bob金额相同,ROW_NUMBER()仍给出了连续的1和2,没有跳过任何数字。
基于ORDER BY字段相同时的具体排名差异
当ORDER BY指定的字段存在大量重复值时,RANK()和ROW_NUMBER()的行为差异最为明显。RANK()会将所有重复值映射到同一个排名ID,而ROW_NUMBER()则会依据数据库内部的不稳定顺序(通常基于物理存储或插入顺序)强行区分先后。在实际开发中,若业务逻辑要求严格的前N名筛选且不允许因并列导致名额溢出,必须使用ROW_NUMBER()配合子查询过滤;若允许并列进入下一轮或统计并列人数,则RANK()更为合适。
















