








为什么SQL中GROUP BY文本长字段会消耗过多内存
因为数据库在分组时通常需要对长字符串进行哈希计算或全量排序,这会导致大量的临时数据驻留在内存中。如果内存不足以容纳所有分组键,数据库会被迫将中间结果溢出到磁盘,从而引发严重的i/o瓶颈和性能下降。

如何优化长文本字段的分组性能
通过提取长文本的前缀或使用哈希值作为分组依据,可以显著减少参与比较的字节数,从而降低内存占用并加速分组过程。
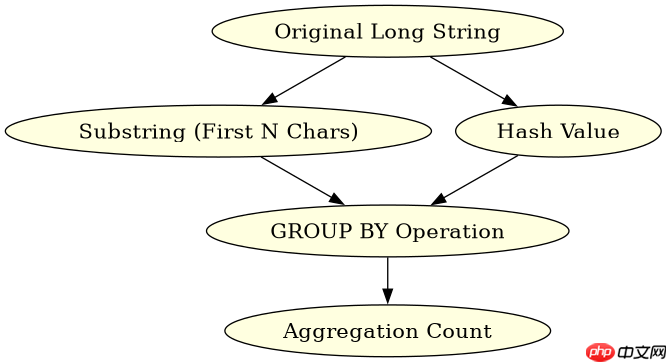
SELECT LEFT(description, 50) AS short_desc, COUNT(*) FROM logs GROUP BY short_desc;
基于程序中某个输入、条件或结果的具体问题
当使用哈希值进行分组时,虽然内存占用极低,但需要处理哈希冲突的情况,即不同的长文本可能生成相同的短哈希值,导致统计结果不准确。



















