








在sql中计算移动累计总和,核心做法是利用不等值join将当前行与历史行关联,通过条件 `t2.date

如何构建基础的时间序列不等值JOIN逻辑?
该逻辑依赖于自连接中的日期比较条件,确保每一行都能“看到”包括自身在内的所有过去记录。例如,对于订单表,我们连接同一张表,条件是右表的订单日期小于等于左表的订单日期,并按左表的客户ID和订单日期分组求和。
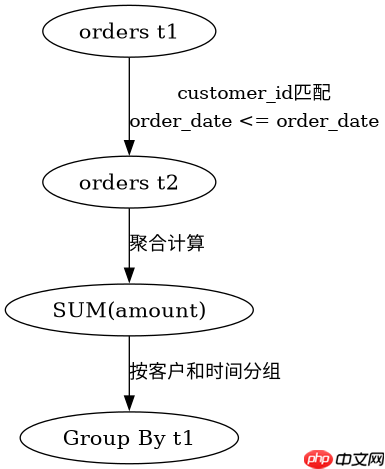
SELECT
    t1.customer_id,
    t1.order_date,
    SUM(t2.amount) AS cumulative_sum
FROM orders t1
JOIN orders t2
    ON t1.customer_id = t2.customer_id
    AND t2.order_date <= t1.order_date
GROUP BY
    t1.customer_id,
    t1.order_date
ORDER BY
    t1.customer_id,
    t1.order_date;
上述查询针对每个客户的每笔订单,计算从第一条订单到当前订单的金额总和。假设输入数据包含客户A的两笔订单:1月1日金额100,1月2日金额200。第一行输出为100,第二行输出为300。这种写法直观地展示了不等值JOIN的累积效应,但需注意其时间复杂度较高,适合数据量较小的场景。
如何处理非连续时间戳或重复日期的情况?
当数据中存在重复日期或非连续时间戳时,直接基于日期比较可能导致结果不符合预期,因为相等日期的多行会被全部计入。此时需要引入唯一标识符(如主键ID)或排序序号来精确界定“之前”的范围。使用主键ID进行比较是最稳健的做法,因为它保证了全序关系且无歧义。
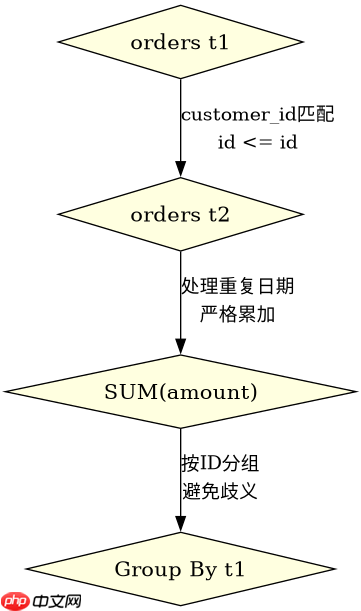
SELECT
    t1.id,
    t1.customer_id,
    t1.order_date,
    t1.amount,
    SUM(t2.amount) AS cumulative_sum
FROM orders t1
JOIN orders t2
    ON t1.customer_id = t2.customer_id
    AND t2.id <= t1.id
GROUP BY
    t1.id,
    t1.customer_id,
    t1.order_date,
    t1.amount
ORDER BY
    t1.customer_id,
    t1.order_date,
    t1.id;
在此改进版本中,使用 t2.id 替代日期比较。即使同一天有多笔订单,也能根据ID顺序严格累加。例如,若客户A在1月1日有两笔订单,ID分别为1和2,金额均为50。ID为1的行累计值为50,ID为2的行累计值为100。这解决了日期相同时的不确定性,确保了累计总和的准确性。对于大规模数据,建议结合窗口函数优化性能,但不等值JOIN在处理复杂业务逻辑或兼容旧版数据库时仍具实用价值。
基于程序中某个输入、条件或结果的具体问题
在使用不等值JOIN计算累计总和时,如果输入数据中包含NULL值的金额字段,SUM函数会忽略这些NULL值,但可能导致累计结果偏小。例如,若某行金额为NULL,它不会贡献到后续行的累计和中,但也不会中断累计过程。为避免此问题,应在JOIN前使用COALESCE将NULL转换为0,或在SUM中使用COALESCE包裹字段。此外,若未正确分组,会导致笛卡尔积膨胀,因此必须确保GROUP BY包含所有非聚合列。


















