








把一个新旗舰模型接进现有系统,先算账再写代码通常更省事。围绕 11 月 15 日 gpt-6 astra 的定价与上下文数据,接入前至少要把三件事算清楚。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
第一步:把单价拆成输入与输出
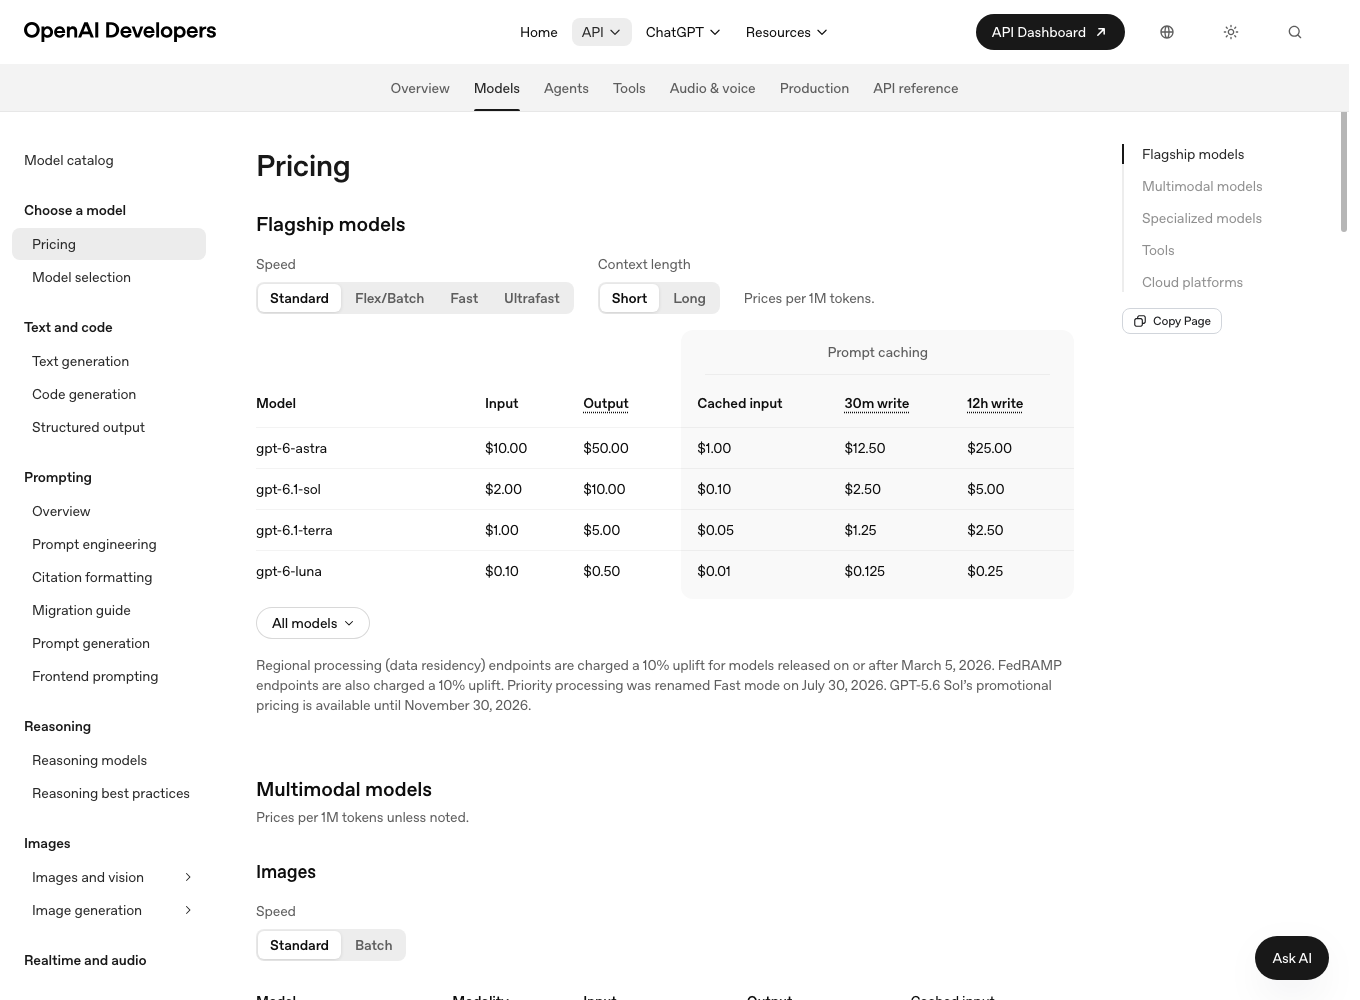
标准定价是每百万输入 token 10 美元、输出 50 美元,输出单价是输入的 5 倍。估算时不要只用一个「平均每百万 token 价格」,而要把典型请求拆成输入长度与输出长度两部分。举例说,一次请求输入 2 万 token、输出 2000 token,成本约为 0.2 + 0.1 = 0.3 美元;若把输出放大到 1 万 token,成本就变成 0.7 美元,其中输出占了大头。缓存读取、工具调用等是否另计费,需要看所用渠道的计价说明,不能从这两档单价推断。
第二步:上下文窗口不等于填充目标
约 105 万 token 的上下文窗口,指的是单次可容纳的上限,不是建议每次都塞满。长上下文会带来两笔成本:输入 token 本身,以及注意力计算带来的延迟。更实际的做法是按任务切分——先检索出与当前步骤相关的片段,再组装上下文;把「一次问完」改成「分步执行 + 中间结果落盘」,往往同时降低费用与出错率。单次最高 12.8 万输出的上限也适合当成截断设计的参考:超过这个量级的产物应规划续写与拼接,而不是依赖一次返回。
第三步:按任务而不是按请求记账
旗舰模型单价更高,但它在跨文件代码评审、OSWorld 类任务上的完成率与耗时同样有改善,于是衡量单位变成「一个任务总共花多少」。建议在接入前定义一组可复现的代表任务,记录每个任务的请求数、总输入、总输出、重跑次数与人工返工时间,再和现用模型对比。只有把重跑与返工算进去,才能判断高单价是否真的更贵。
直连、Azure、Bedrock 等渠道的计费方式并不相同,正式接入前要按所用渠道的官方文档与实际账单核算。






















