








在 nginx 的默认轮询(round robin)负载均衡中,无法直接通过单一参数设置“最大失败请求次数”来触发故障转移。nginx 原生模块仅支持基于连续失败的超时时间(`max_fails`)和恢复周期(`fail_timeout`)来判断后端是否健康。若需实现严格的“失败 n 次后剔除”逻辑,必须借助第三方模块 `nginx_upstream_check_module` 或升级至 openresty/nginx plus 使用主动健康检查机制。
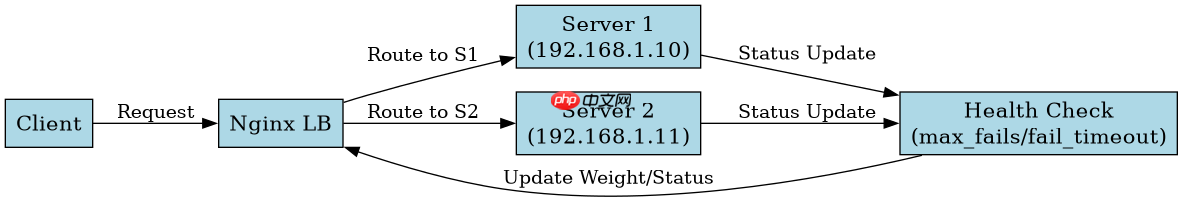
Nginx 原生配置如何实现失败判定
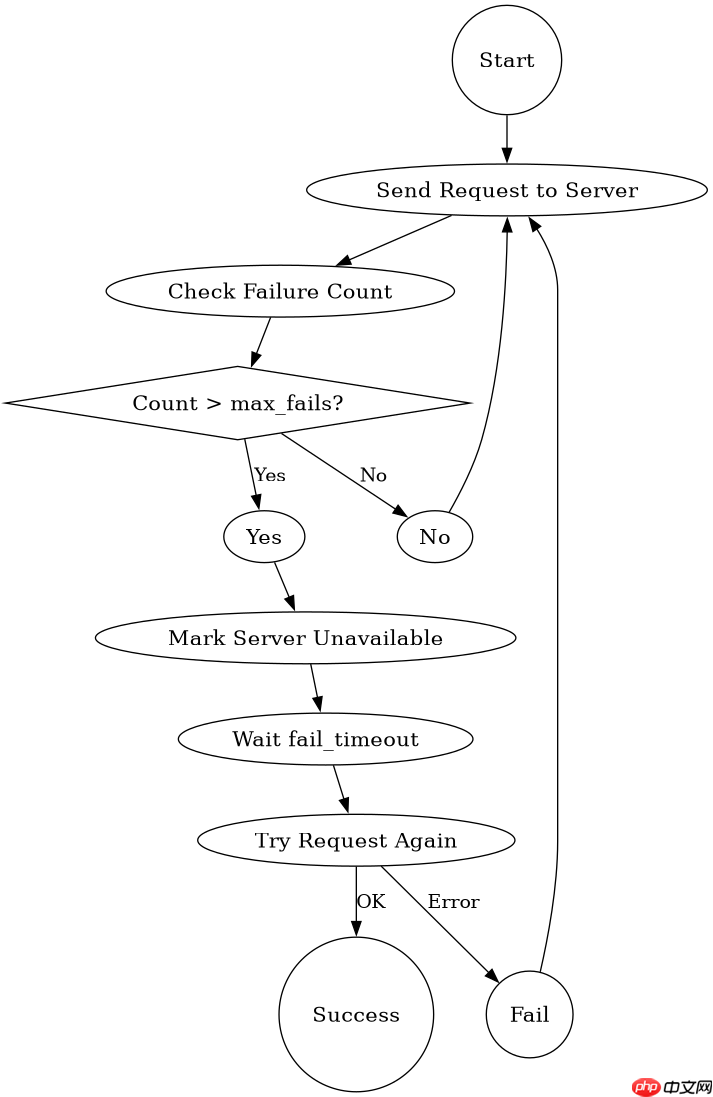
原生配置通过 `max_fails` 和 `fail_timeout` 配合工作。`max_fails` 定义在 `fail_timeout` 时间段内,允许的最大失败连接数。一旦超过此次数,Nginx 会在 `fail_timeout` 时间内将该服务器标记为不可用,并将请求转发给其他正常服务器。
upstream backend {
    server 192.168.1.10:80 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:80 max_fails=3 fail_timeout=30s;
}
上述配置表示:如果在 30 秒内,与 `192.168.1.10` 的连接失败了 3 次,Nginx 将在接下来的 30 秒内不再向该服务器发送请求。这里的“失败”通常指连接超时、502 Bad Gateway 或 504 Gateway Timeout 等错误。注意,`max_fails` 默认值为 1,`fail_timeout` 默认值为 10 秒。这种机制是滑动窗口式的,不是全局累计计数。

如何精确控制失败后的行为与恢复
调整 `max_fails` 和 `fail_timeout` 的比例可以改变系统的敏感度。较小的 `max_fails` 值会让系统更快地剔除疑似故障节点,但可能导致误判;较大的 `fail_timeout` 值则延长了故障节点的恢复等待时间,确保其有足够时间重启或修复。

upstream backend {
    server 192.168.1.10:80 max_fails=5 fail_timeout=60s;
    server 192.168.1.11:80 max_fails=5 fail_timeout=60s;
}
在实际应用中,建议将 `max_fails` 设置为 3 到 5 之间,`fail_timeout` 设置为 30 到 60 秒。这样可以在保证高可用的同时,避免因网络抖动导致的频繁切换。此外,Nginx 会在 `fail_timeout` 结束后尝试向该服务器发送请求,如果成功,则将其重新加入可用池。
当所有后端都失败时 Nginx 返回什么状态
如果所有配置的 upstream 服务器都被标记为不可用(即都达到了 `max_fails` 阈值),Nginx 将无法找到可用的后端服务器。此时,Nginx 会返回 502 Bad Gateway 错误给客户端。这是 Nginx 的标准行为,表明它已经尽力尝试了所有已知后端,但均不可达。


















