








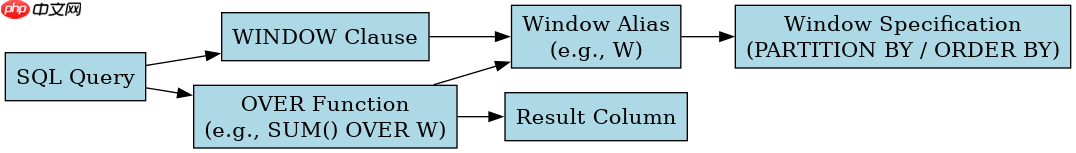
在sql中通过window子句实现多窗口规范复用,核心做法是在select查询的from子句之后、where/order by等子句之前定义一个名为window_clause的命名窗口,并在over()函数调用中直接引用该名称。这样做可以避免在多个聚合或分析函数中重复书写相同的partition by和order by逻辑,从而简化代码并减少维护成本。例如,定义w as (partition by dept_id order by hire_date)后,所有使用该窗口的函数只需写over(w)即可。
如何定义基础窗口规范
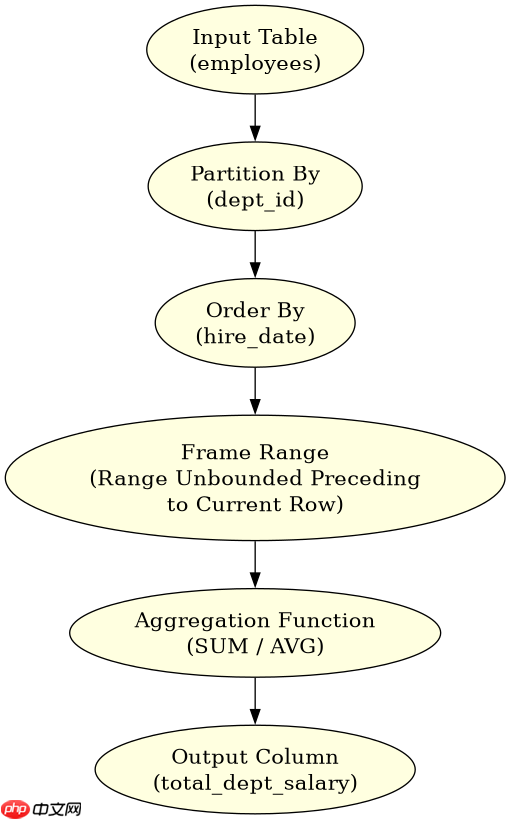
定义基础窗口规范需要在查询语句中显式声明窗口别名及其包含的子句。语法结构为WINDOW window_name AS (window_specification)。其中window_name是自定义的名称,window_specification可以包含PARTITION BY、ORDER BY和RANGE/ROWS帧子句。这种定义方式将窗口逻辑与具体的函数调用解耦,使得后续引用更加简洁。如果未指定帧子句,默认行为取决于是否使用了ORDER BY:有排序则默认为RANGE UNBOUNDED PRECEDING AND CURRENT ROW,无排序则默认为RANGE BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING。
SELECT
    emp_id,
    dept_id,
    salary,
    SUM(salary) OVER W as total_dept_salary,
    AVG(salary) OVER W as avg_dept_salary
FROM employees
WINDOW W AS (PARTITION BY dept_id);
上述代码展示了如何在employees表中计算每个部门的总薪资和平均薪资。通过定义W窗口仅按dept_id分区,两个分析函数复用了同一分区逻辑。执行结果中,total_dept_salary和avg_dept_salary列的值对于同一部门的所有员工是相同的,因为它们基于相同的分组范围计算。若需进一步限制计算范围,可在WINDOW定义中添加ORDER BY或帧子句。
如何组合多个窗口规范
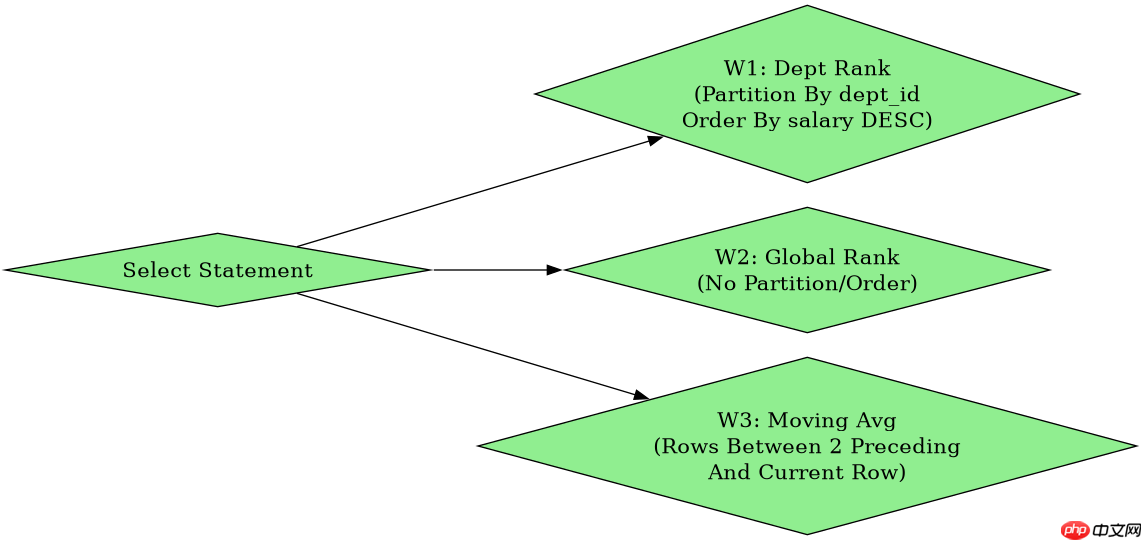
组合多个窗口规范允许在同一查询中定义不同的窗口别名,每个别名对应不同的分区或排序逻辑。这适用于需要同时展示不同维度统计数据的场景。例如,可以同时定义一个按部门分区的窗口和一个全局窗口,或者定义具有不同帧范围的窗口。每个窗口别名必须唯一,且可以在多个OVER()子句中重复引用。这种灵活性使得复杂的多维分析可以通过单一的查询完成,无需使用子查询或CTE进行多次扫描。
SELECT
    emp_id,
    dept_id,
    salary,
    RANK() OVER (PARTITION BY dept_id ORDER BY salary DESC) as dept_rank,
    RANK() OVER () as global_rank,
    SUM(salary) OVER (ROWS BETWEEN 2 PRECEDING AND CURRENT ROW) as moving_avg
FROM employees;
在上述示例中,虽然未使用显式的WINDOW子句,但展示了多种窗口规范的组合方式。若改用WINDOW子句,可改写为:WINDOW W1 AS (PARTITION BY dept_id ORDER BY salary DESC), W2 AS (), W3 AS (ROWS BETWEEN 2 PRECEDING AND CURRENT ROW),然后在OVER中引用W1、W2、W3。这种方式提高了可读性,特别是当窗口规范较长时。执行结果会生成三列排名或移动平均值,分别基于部门内排序、全局排序和固定行数的滑动窗口。注意,W2为空窗口规范时,默认对所有行进行全局聚合或排序。
当窗口规范包含ORDER BY时,帧子句的默认行为是什么
当窗口规范中包含ORDER BY子句但未显式指定帧子句(RANGE或ROWS)时,SQL标准规定默认的帧范围为RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW。这意味着计算将从分区的第一行开始,一直累积到当前行。这一默认行为对排名函数和累计聚合函数有重要影响。例如,使用SUM()配合默认排序会得到累计和,而使用ROW_NUMBER()则不受帧子句影响,因为排名函数通常忽略帧子句(尽管语法上允许)。理解这一默认行为有助于避免意外的计算结果,特别是在处理时间序列数据或需要逐行累加的场景中。


















