








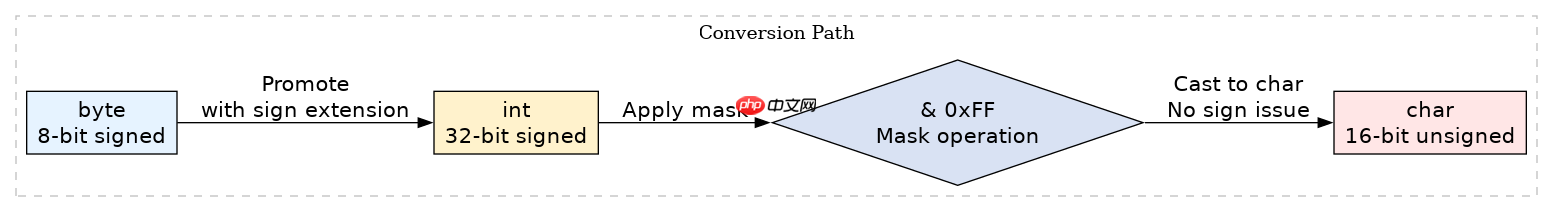
java 中 byte 和 char 之间不能直接转换,因为两者类型不兼容且存在精度丢失风险。byte 是 8 位有符号整数,而 char 是 16 位无符号 unicode 字符。若要将 byte 转为 char,需先将其提升为 int 或 short 以消除符号扩展问题,再强制转换为 char;反之,将 char 转为 byte 时,高位字节会被截断,仅保留低 8 位。这种转换通常用于处理底层二进制数据或特定编码(如 ascii)的字符映射。
byte 转 char 的具体实现方式是什么
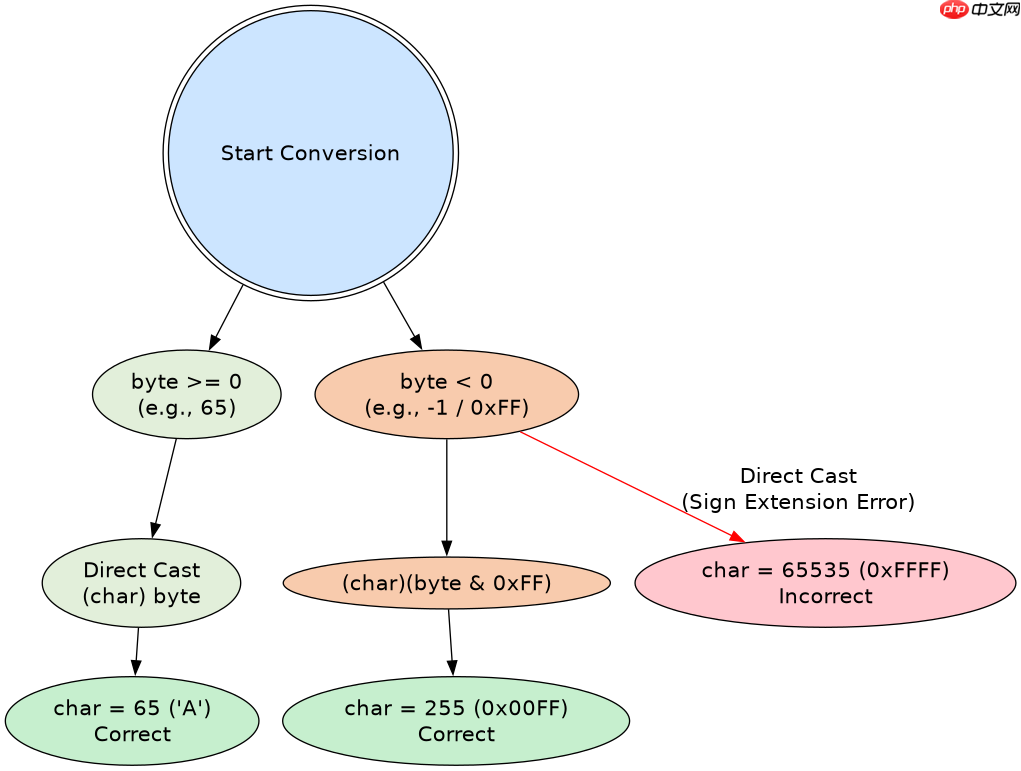
byte 转 char 的核心在于处理符号扩展。当 byte 值为负数时,直接赋值给 char 会因隐式提升为 int 而产生全 1 的高位填充,导致错误的 Unicode 值。正确的做法是先通过按位与操作 `& 0xFF` 将其视为无符号值,再转换为 char。例如,byte 值 -1 (即 0xFF) 应转换为 char 值 255 (即 0x00FF),而非 65535 (即 0xFFFF)。
public class ByteCharConversion {
    public static void main(String[] args) {
        // 测试正数
        byte posByte = 65; // ASCII 'A'
        char posChar = (char) (posByte & 0xFF);
        System.out.println("Positive: byte=" + posByte + ", char='" + posChar + "', code=" + (int)posChar);

        // 测试负数
        byte negByte = -1; // 0xFF in two's complement
        char negChar = (char) (negByte & 0xFF);
        System.out.println("Negative: byte=" + negByte + ", char code=" + (int)negChar + ", hex=0x" + Integer.toHexString(negChar));

        // 错误示范:直接转换
        char wrongChar = (char) negByte;
        System.out.println("Wrong: byte=" + negByte + ", char code=" + (int)wrongChar + ", hex=0x" + Integer.toHexString(wrongChar));
    }
}
运行上述代码,正数 65 正确转换为 'A' (code 65)。负数 -1 经过 `& 0xFF` 处理后,转换为 code 255 的字符。若直接转换,-1 会被提升为 int -1 (0xFFFFFFFF),再截断为 char 时得到 65535 (0xFFFF),这是错误的。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
char 转 byte 的数据截断规则如何
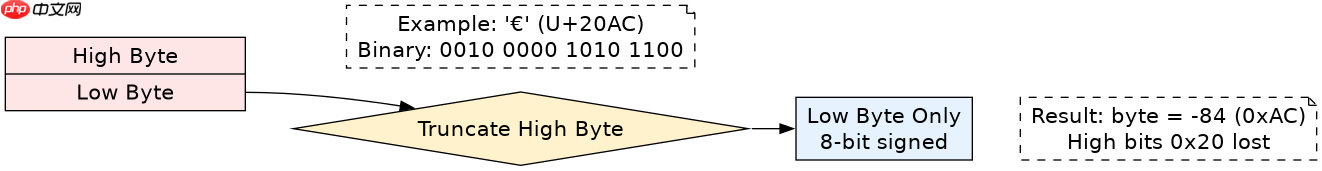
char 转 byte 是窄化原始转换,JVM 会直接丢弃 char 的高 8 位,仅保留低 8 位作为 byte 的值。这意味着如果 char 的值大于 127 或小于 0(在 byte 范围内),结果将出现不可逆的数据丢失。例如,char '€' (Unicode U+20AC, 十进制 8364) 转换为 byte 后,只保留低 8 位 0xAC (-84),高位的 0x20 被完全丢弃。这种转换适用于只需低位数据的场景,如校验和计算或简单协议解析。
public class CharByteTruncation {
    public static void main(String[] args) {
        char c = '€'; // Unicode U+20AC, decimal 8364, binary 0010 0000 1010 1100
        byte b = (byte) c;
        System.out.println("Char: '" + c + "', code: " + (int)c + ", hex: 0x" + Integer.toHexString(c));
        System.out.println("Byte: " + b + ", hex: 0x" + Integer.toHexString(b & 0xFF));

        // 验证截断
        int lowByte = c & 0xFF;
        System.out.println("Low byte value: " + lowByte + ", matches byte cast: " + (lowByte == (b & 0xFF)));
    }
}
该程序输出显示,char '€' 的完整码点是 8364 (0x20AC),转换为 byte 后变为 -84 (0xAC)。这证实了高 8 位 (0x20) 被丢弃,仅低 8 位 (0xAC) 保留。开发者在使用此转换时需确保高位数据无需保留,否则会导致信息损坏。
如何处理 UTF-8 编码下的多字节字符转换
UTF-8 编码下,非 ASCII 字符由多个 byte 组成,因此单个 byte 或 char 无法直接表示完整字符。若需处理此类字符,应避免逐字节转换,而是使用 CharsetDecoder 或 String.getBytes() 进行整体编解码。例如,将包含中文的字符串转为 byte 数组时,每个汉字占 3 个 byte,此时强行将单个 byte 转为 char 毫无意义,因为中间字节不构成有效字符。正确的做法是将整个 byte 序列还原为 String,再从中提取 char。
import java.nio.charset.StandardCharsets;

public class Utf8Handling {
    public static void main(String[] args) {
        String text = "Hello 世界";
        byte[] bytes = text.getBytes(StandardCharsets.UTF_8);

        // 错误做法:尝试将单个 byte 转为 char 来重建字符串
        StringBuilder sb = new StringBuilder();
        for (byte b : bytes) {
            sb.append((char) (b & 0xFF)); // 这会生成乱码
        }
        System.out.println("Wrong reconstruction: " + sb.toString());

        // 正确做法:使用标准解码
        String reconstructed = new String(bytes, StandardCharsets.UTF_8);
        System.out.println("Correct reconstruction: " + reconstructed);
    }
}
运行结果显示,逐字节转换生成的字符串包含大量不可见或错误字符,而使用 StandardCharsets.UTF_8 解码则能完美还原原始文本。这表明在处理多字节编码时,必须保持字节流的完整性,避免局部转换导致的语义破坏。



















