








java hashmap 按值排序的核心做法是将键值对提取为列表,调用 collections.sort() 或 list.sort() 并传入基于值的比较器,最后将排好序的条目重新放入 linkedhashmap 中。这样做会保留插入顺序,从而在遍历新 map 时获得按值排序的结果。如果存在值相同的情况,排序结果取决于比较器的稳定性及是否指定了次级排序条件。

如何获取按值升序排列的新 Map
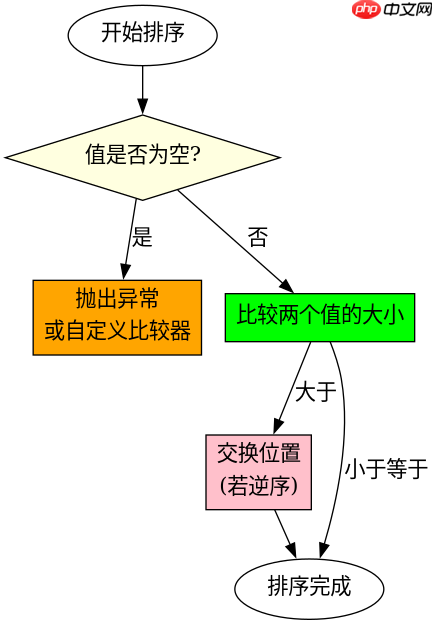
要获取一个按值升序排列的新 Map,需要利用 Java 8 引入的 Stream API。通过 entrySet().stream() 将集合转换为流,使用 sorted() 方法配合 Map.Entry.comparingByValue() 进行自然排序,最后通过 collect() 收集到 LinkedHashMap 中。这种方法代码简洁,且能自动处理空值(默认情况下 comparingByValue() 不允许空值,需自定义比较器)。示例输入为包含姓名和分数的映射,输出将是分数从低到高排列的有序映射。
import java.util.*;
import java.util.stream.*;

public class SortByValue {
    public static void main(String[] args) {
        Map<String, Integer> scores = new HashMap<>();
        scores.put("Alice", 85);
        scores.put("Bob", 92);
        scores.put("Charlie", 78);

        // 按值升序排序,存入 LinkedHashMap 保持顺序
        Map<String, Integer> sortedMap = scores.entrySet()
            .stream()
            .sorted(Map.Entry.comparingByValue())
            .collect(Collectors.toMap(
                Map.Entry::getKey,
                Map.Entry::getValue,
                (e1, e2) -> e1,
                LinkedHashMap::new
            ));

        System.out.println(sortedMap);
    }
}
运行上述代码,预期输出结果为:{Charlie=78, Alice=85, Bob=92}。这里 Collectors.toMap 的第三个参数是合并函数,由于排序后键是唯一的,该函数实际上不会被调用,但它是构建 Map 所必需的。第四个参数指定了返回类型为 LinkedHashMap,这是保持排序顺序的关键。
立即学习“Java免费学习笔记(深入)”;

使用Atmosphere构建通过WebSocket、SSE、gRPC、WebTransport、MCP、A2A和AG-UI流传输的JVM代理网关,并带有治理钩子。
如何处理值相同的情况并保持稳定排序
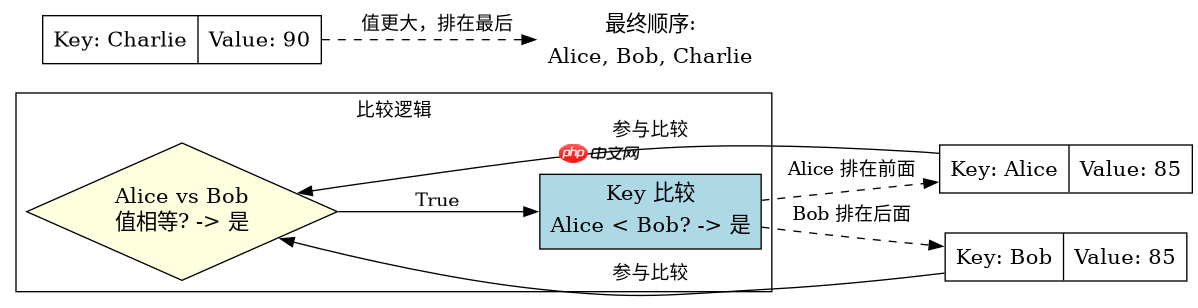
当 Map 中存在多个具有相同值的键值对时,默认的 comparingByValue() 无法保证这些元素之间的相对顺序,除非原始流是稳定的且没有发生冲突。为了明确处理这种情况,可以链式调用 .thenComparing() 添加次级排序条件,例如按 Key 的自然顺序排列。这样可以确保即使值相同,结果也是确定且可预测的。对于示例输入,如果 Bob 和 Alice 分数相同,按 Key 排序会将 Alice 排在 Bob 前面。
import java.util.*;
import java.util.stream.*;

public class StableSortByValue {
    public static void main(String[] args) {
        Map<String, Integer> scores = new HashMap<>();
        scores.put("Bob", 85);
        scores.put("Alice", 85); // 值相同
        scores.put("Charlie", 90);

        // 先按值升序,值相同时按 Key 升序
        Map<String, Integer> stableSortedMap = scores.entrySet()
            .stream()
            .sorted(Map.Entry.<String, Integer>comparingByValue()
                .thenComparing(Map.Entry.comparingByKey()))
            .collect(Collectors.toMap(
                Map.Entry::getKey,
                Map.Entry::getValue,
                (e1, e2) -> e1,
                LinkedHashMap::new
            ));

        System.out.println(stableSortedMap);
    }
}
运行此段代码,预期输出结果为:{Alice=85, Bob=85, Charlie=90}。可以看到,尽管 Alice 和 Bob 的值都是 85,但由于添加了 thenComparing,它们按照姓名的字母顺序排列,确保了结果的稳定性。这种处理方式在处理业务数据时非常常见,例如在成绩相同时按学号或姓名排序。
为什么必须使用 LinkedHashMap 而不是 HashMap
在按值排序的过程中,最终结果必须存储在 LinkedHashMap 中,因为普通的 HashMap 不保证迭代顺序。无论内部哈希算法如何,HashMap 的遍历顺序是不确定的,且在元素增删过程中可能发生变化。而 LinkedHashMap 维护了一个双向链表来记录插入顺序(或访问顺序)。当我们通过 Stream 收集结果时,指定 LinkedHashMap::new 作为 Map 工厂,Stream 会按照排序后的顺序依次调用 put 方法,LinkedHashMap 就会严格按照这个顺序记录节点。因此,后续对该 Map 进行 keySet()、values() 或 entrySet() 遍历时,得到的顺序就是排序后的顺序。如果使用 HashMap,虽然内容正确,但遍历顺序将完全随机,失去排序的意义。


















