








spring boot 全局异常处理无法直接捕获雪花算法(snowflake)产生的异常,因为雪花算法通常只是生成 id 的工具类或静态方法,其内部抛出的异常属于业务逻辑层面的运行时异常,不会自动触发 spring mvc 的异常处理机制。要捕获这些异常,必须在调用雪花算法生成 id 的业务代码中显式使用 try-catch 块进行包裹,或者将生成 id 的逻辑封装在 service 层并在该层统一处理。

为什么全局异常处理器抓不到雪花算法异常
全局异常处理器(如 @ControllerAdvice)主要拦截的是 Controller 层抛出的、未被处理的异常。雪花算法的实现通常是一个简单的工具类,它通过位运算计算时间戳、机器 ID 和工作 ID 来生成唯一标识。如果发生时钟回拨或参数配置错误,工具类会抛出 IllegalArgumentException 或自定义的 SnowflakeException。由于这些异常是在 Service 层的方法执行过程中产生的,且如果没有被 Service 层捕获,它们会向上传播到 Controller。虽然理论上 Controller 层的未捕获异常会被全局处理器捕获,但很多开发者习惯在 Service 层直接处理或记录日志,导致异常没有传播出来。此外,雪花算法本身并不与 Spring 框架深度集成,它只是一个纯 Java 逻辑,因此不存在像数据库连接断开那样的底层资源异常自动映射机制。
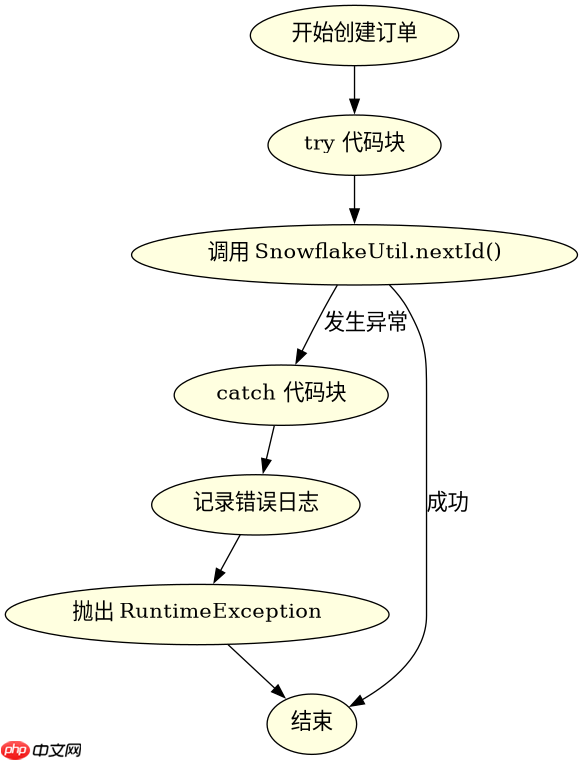
import org.springframework.stereotype.Service;

@Service
public class OrderService {

    public String createOrder() {
        try {
            // 假设 SnowflakeUtil 是自定义的雪花算法工具类
            String orderId = SnowflakeUtil.nextId();
            System.out.println("Generated Order ID: " + orderId);
            return orderId;
        } catch (Exception e) {
            // 必须在这里显式捕获并处理
            System.err.println("Failed to generate ID: " + e.getMessage());
            throw new RuntimeException("ID generation failed", e);
        }
    }
}
上述代码展示了在 Service 层如何显式捕获异常。当 SnowflakeUtil.nextId() 抛出异常时,try-catch 块会立即截获它。如果不加这个块,异常会继续向上抛出到 Controller,此时全局异常处理器才可能介入。但在实际开发中,建议在 Service 层就完成异常的转换和记录,而不是依赖全局处理器来处理这种具体的业务逻辑失败。

如何在 Service 层正确封装雪花算法调用
为了保持代码的整洁和异常处理的一致性,应该将雪花算法的调用封装在一个独立的组件中,并在 Service 层提供明确的错误处理路径。这样做的目的是确保当 ID 生成失败时,系统能够给出明确的反馈,而不是让异常随意传播。可以通过定义一个专门的异常类,如 IdGenerationException,来包装雪花算法可能抛出的原始异常。这样,全局异常处理器就可以针对这个特定的异常类型进行处理,返回统一的错误响应格式。
import org.springframework.web.bind.annotation.ExceptionHandler;
import org.springframework.web.bind.annotation.RestControllerAdvice;
import org.springframework.http.ResponseEntity;
import org.springframework.http.HttpStatus;

@RestControllerAdvice
public class GlobalExceptionHandler {

    @ExceptionHandler(IdGenerationException.class)
    public ResponseEntity<String> handleIdGenerationException(IdGenerationException ex) {
        return ResponseEntity.status(HttpStatus.INTERNAL_SERVER_ERROR)
                .body("ID Generation Failed: " + ex.getMessage());
    }
}
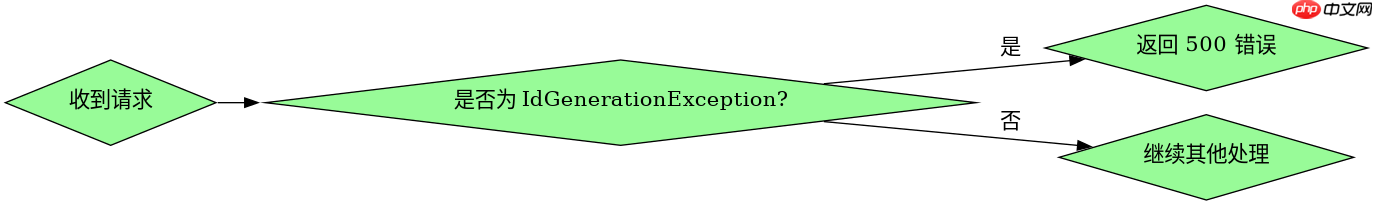
在全局异常处理器中,我们添加了针对 IdGenerationException 的处理方法。这样,当 Service 层抛出这个异常时,全局处理器会捕获它并返回一个标准的 HTTP 500 错误响应。这种做法不仅解决了雪花算法异常捕获的问题,还提高了系统的可维护性和错误信息的可读性。需要注意的是,雪花算法的异常通常是不可恢复的,因此在处理时应尽量避免重试,而是直接告知调用方系统暂时不可用。
基于时钟回拨条件的具体问题分析
雪花算法中最常见的异常原因是服务器时钟回拨,即系统时间突然向前调整。这种情况下,生成的 ID 可能会重复,导致数据不一致。为了解决这个问题,可以在雪花算法的实现中加入时钟回拨检测逻辑。当检测到时间回拨时,算法可以等待一段时间直到时间追上之前的最大值,或者抛出异常通知系统管理员进行检查。在实际应用中,建议结合分布式锁或 ZooKeeper 等协调服务来同步集群内的时间,减少时钟回拨的发生概率。

















