








String.Equals 忽略大小写时带重音字母和普通字母是否相等
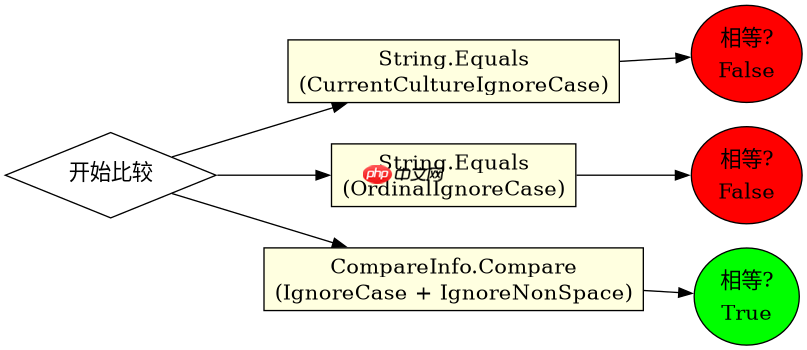
在 c# 中,默认使用当前文化进行忽略大小写的比较时,带重音的字母(如 é)通常被视为与普通字母(如 e)不相等。这是因为基于文化的比较会区分重音符号,除非显式指定不区分重音的比较规则。要得到它们相等的结果,必须使用 compareinfo 或 stringcomparison.ordinalignorecase 等特定选项。
using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        string s1 = "café";
        string s2 = "cafe";

        // 1. 默认忽略大小写比较(区分重音)
        bool defaultIgnoreCase = string.Equals(s1, s2, StringComparison.CurrentCultureIgnoreCase);
        Console.WriteLine($"CurrentCultureIgnoreCase: {defaultIgnoreCase}");

        // 2. 不区分大小写且不区分重音(通过 CompareInfo)
        CompareInfo ci = CultureInfo.CurrentCulture.CompareInfo;
        bool ignoreAccent = ci.Compare(s1, s2, CompareOptions.IgnoreCase | CompareOptions.IgnoreNonSpace);
        Console.WriteLine($"IgnoreCase + IgnoreNonSpace: {ignoreAccent}");

        // 3. 仅不区分大小写(不区分重音)
        bool ordinalIgnoreCase = string.Equals(s1, s2, StringComparison.OrdinalIgnoreCase);
        Console.WriteLine($"OrdinalIgnoreCase: {ordinalIgnoreCase}");
    }
}运行上述代码,输出结果通常为:CurrentCultureIgnoreCase: FalseIgnoreCase + IgnoreNonSpace: TrueOrdinalIgnoreCase: False
这表明默认行为是区分重音的,而 CompareOptions.IgnoreNonSpace 是实现“忽略重音”的关键。
StringComparison.OrdinalIgnoreCase 对重音字母的处理逻辑
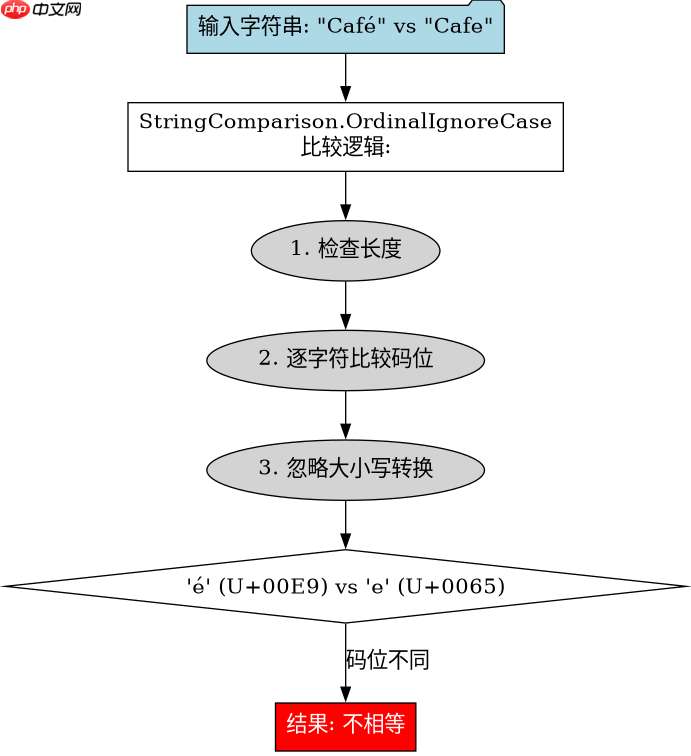
StringComparison.OrdinalIgnoreCase 基于 Unicode 码位进行比较,它只忽略大小写,完全忽略区域性和重音差异。因此,é (U+00E9) 和 e (U+0065) 在这种模式下是不相等的,因为它们的码位不同。这种比较方式速度快,但不符合自然语言习惯。

using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        string s1 = "Café";
        string s2 = "Cafe";

        // OrdinalIgnoreCase 比较
        bool ordResult = string.Equals(s1, s2, StringComparison.OrdinalIgnoreCase);
        Console.WriteLine($"OrdinalIgnoreCase Result: {ordResult}");

        // 查看字符码位
        char c1 = s1[3]; // é
        char c2 = s2[3]; // e
        Console.WriteLine($"Codepoint of 'é': U+{((int)c1):X4}");
        Console.WriteLine($"Codepoint of 'e': U+{((int)c2):X4}");
    }
}
此段代码验证了 OrdinalIgnoreCase 不会将 é 和 e 视为相同。如果希望在不区分大小写的同时也不区分重音,必须使用 CompareInfo 并组合 CompareOptions.IgnoreNonSpace。
使用 CompareOptions.IgnoreNonSpace 实现忽略重音比较
要在 C# 中实现真正的“忽略重音”且“忽略大小写”的比较,需要使用 CultureInfo.CurrentCulture.CompareInfo 对象,并在 Compare 方法中传入 CompareOptions.IgnoreCase | CompareOptions.IgnoreNonSpace。这是处理国际化文本匹配的标准做法。
using System;
using System.Globalization;

class Program
{
    static void Main()
    {
        string input = "résumé";
        string pattern = "resume";

        CompareInfo ci = CultureInfo.InvariantCulture.CompareInfo;

        // 忽略大小写 AND 忽略非空格字符(即重音符号)
        bool match = ci.Compare(input, pattern, CompareOptions.IgnoreCase | CompareOptions.IgnoreNonSpace);

        Console.WriteLine($"Match with IgnoreNonSpace: {match}");

        // 对比:仅忽略大小写
        bool noAccentIgnore = ci.Compare(input, pattern, CompareOptions.IgnoreCase);
        Console.WriteLine($"Match without IgnoreNonSpace: {noAccentIgnore}");
    }
}运行结果:Match with IgnoreNonSpace: TrueMatch without IgnoreNonSpace: False
这证明了 IgnoreNonSpace 选项是解决重音字母相等性问题的核心参数。在实际开发中,若需处理用户输入搜索,应优先使用此组合以确保用户体验的一致性。


















