








linq 分组查询统计开销重复产生是因为 groupby 在内存中构建分组后,后续的聚合操作(如 sum、average)会遍历每个分组内的元素进行计算。如果代码逻辑不当,例如在循环外调用 groupby 但内部多次执行聚合,或者对同一个分组集合进行了多次迭代处理,就会导致相同的统计逻辑被重复执行。要解决这个问题,需要确保只进行一次分组和一次聚合遍历,或者将结果缓存。

如何避免在循环中重复执行 GroupBy 导致的性能浪费?
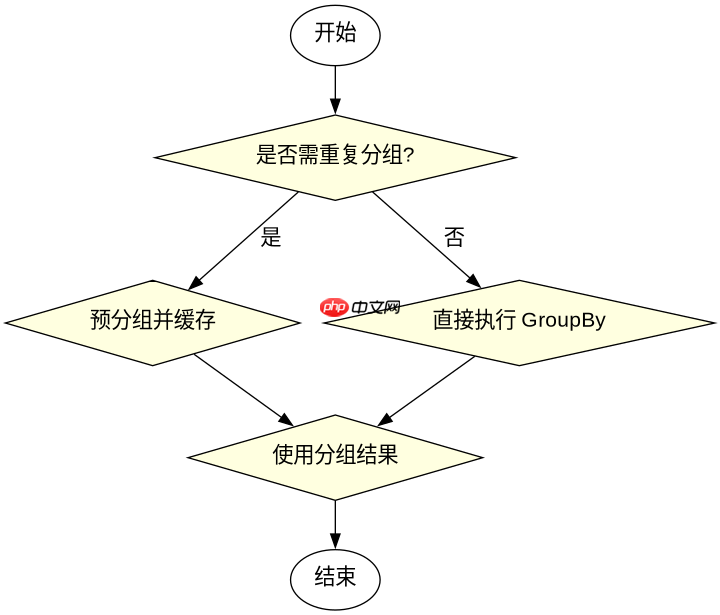
如果在循环或频繁调用的方法中直接调用 GroupBy,每次都会重新创建分组对象并遍历数据源,导致开销累积。正确的做法是将分组结果提取到变量中,或者使用字典手动分组以减少重复计算。
using System;
using System.Collections.Generic;
using System.Linq;

class Program
{
    static void Main()
    {
        var data = new List<int> { 1, 2, 2, 3, 3, 3 };
        // 错误做法:在循环中重复分组
        for (int i = 0; i < 1000; i++)
        {
            var grouped = data.GroupBy(x => x);
            foreach (var group in grouped)
            {
                Console.WriteLine($"Key: {group.Key}, Count: {group.Count()}");
            }
        }
    }
}
上述代码在循环中每次都执行 GroupBy,导致数据被多次遍历和分组。优化方案是预先分组:
using System;
using System.Collections.Generic;
using System.Linq;

class Program
{
    static void Main()
    {
        var data = new List<int> { 1, 2, 2, 3, 3, 3 };
        var grouped = data.GroupBy(x => x).ToList(); // 预分组
        for (int i = 0; i < 1000; i++)
        {
            foreach (var group in grouped)
            {
                Console.WriteLine($"Key: {group.Key}, Count: {group.Count()}");
            }
        }
    }
}
预期结果:优化后的代码只执行一次分组,后续循环仅访问已缓存的分组结果,显著降低 CPU 开销。

为什么多次调用 Aggregate 会导致中间状态重复计算?
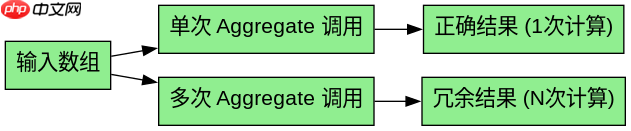
Aggregate 是一个累积操作,如果将其嵌套在循环或递归中,每次调用都会从头开始计算累积值,导致中间状态无法复用。正确做法是使用局部变量存储累积结果,或在单次遍历中完成所有聚合。
using System;
using System.Linq;

class Program
{
    static void Main()
    {
        var data = new[] { 1, 2, 3, 4, 5 };
        // 错误做法:多次调用 Aggregate
        int sum1 = data.Aggregate((a, b) => a + b);
        int sum2 = data.Aggregate((a, b) => a + b); // 重复计算
        Console.WriteLine(sum1 + " " + sum2);
    }
}
上述代码两次调用 Aggregate,分别独立计算总和,造成重复工作。优化方案是合并为一次:
using System;
using System.Linq;

class Program
{
    static void Main()
    {
        var data = new[] { 1, 2, 3, 4, 5 };
        int sum = data.Aggregate(0, (a, b) => a + b); // 单次计算
        Console.WriteLine(sum);
    }
}
预期结果:优化后只执行一次累加,输出 15,无重复计算开销。
当分组键为复杂对象时,Equals 方法未重写会导致什么结果?
如果分组键是自定义类且未重写 Equals 和 GetHashCode,LINQ 会使用引用相等性进行比较,导致相同值的对象被视为不同组,统计结果错误。必须重写这两个方法以确保值相等性判断。


















