








在 c# 中,即使字典的键看起来完全相同,查找失败通常是因为字符串包含不可见的 unicode 字符(如零宽空格)或采用了不同的规范化形式。要解决这个问题,必须在插入和查找前对键调用 string.normalize() 方法,确保它们处于统一的 unicode 标准形式(如 nfc),从而消除视觉相同但底层字节序列不同的差异。

如何检测并处理不可见字符导致的键冲突
当使用包含零宽空格或其他控制字符的字符串作为键时,ContainsKey 会返回 false,因为内存中的字节并不匹配。通过遍历字符串的字符并检查其 Unicode 类别,可以定位这些隐藏字符。处理的核心步骤是先对输入进行规范化,再存入字典。
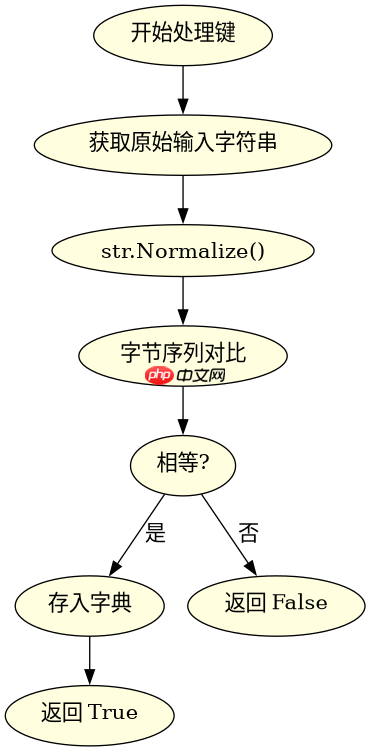

using System;
using System.Collections.Generic;
using System.Linq;

class Program
{
    static void Main()
    {
        var dict = new Dictionary<string, int>();

        // 模拟一个包含零宽空格 (U+200B) 的键
        string rawKey = "key" + "\u200B";
        string cleanKey = rawKey.Normalize();

        dict[cleanKey] = 100;

        // 直接查找原始带空格的键会失败
        Console.WriteLine(dict.ContainsKey(rawKey)); // False

        // 查找规范化后的键成功
        Console.WriteLine(dict.ContainsKey(cleanKey)); // True
        Console.WriteLine(dict[cleanKey]); // 100
    }
}
为什么不同输入法产生的相同汉字可能被视为不同键
某些汉字可以通过不同的 Unicode 码位组合表示(例如用基础字符加组合标记,或用预组合字符)。如果不进行规范化,Equals 方法会认为它们不相等。解决方法是在字典初始化或键比较器中强制使用 StringComparison.Ordinal 配合 Normalize,或者自定义 IEqualityComparer<string></string> 来统一处理。
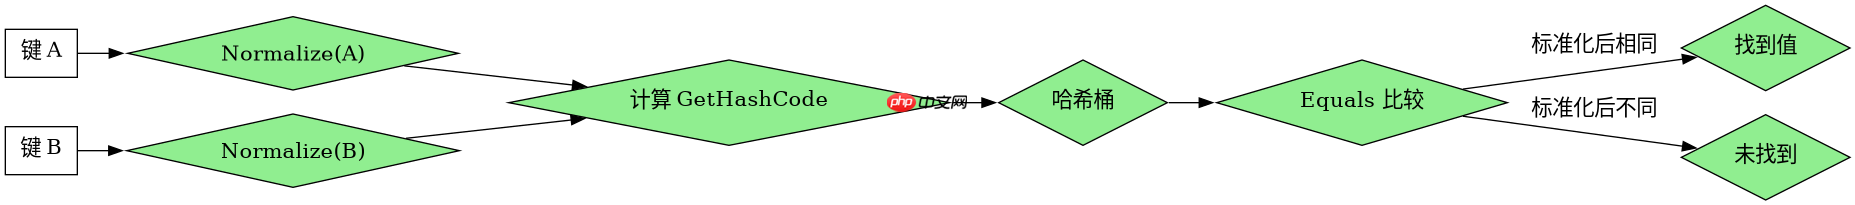
using System;
using System.Collections.Generic;
using System.Text;

class NormalizedEqualityComparer : IEqualityComparer<string>
{
    public bool Equals(string x, string y)
    {
        if (x == null || y == null) return x == y;
        return x.Normalize() == y.Normalize();
    }

    public int GetHashCode(string obj)
    {
        if (obj == null) return 0;
        return obj.Normalize().GetHashCode();
    }
}

class Program
{
    static void Main()
    {
        var dict = new Dictionary<string, string>(new NormalizedEqualityComparer());

        // 假设 'é' 有两种表示方式:预组合 U+00E9 或 e + 组合锐音符 U+0301
        string key1 = "café"; // 预组合
        string key2 = "cafe\u0301"; // 分解形式

        dict[key1] = "Value A";

        Console.WriteLine(dict.ContainsKey(key2)); // True
        Console.WriteLine(dict[key2]); // Value A
    }
}
基于程序中 Normalize 调用后哈希码变化的具体问题
在调用 Normalize() 后,字符串的 GetHashCode() 返回值可能会发生变化,因为底层字符数组改变了。如果先计算了哈希码再规范化,会导致字典查找失败。因此,必须确保在将键放入字典之前,已经完成了规范化操作,以保证哈希码与键内容的一致性。

















