








java中执行批量数据分库的核心做法是:根据业务规则(如用户id哈希)将数据分组,为每个目标数据库建立独立的连接和preparedstatement,在事务内分批提交。具体实现时,需先按分片键对数据进行分类,然后遍历每个分片组,创建对应的数据库连接,使用addbatch和executebatch进行高效插入,最后统一提交或回滚。
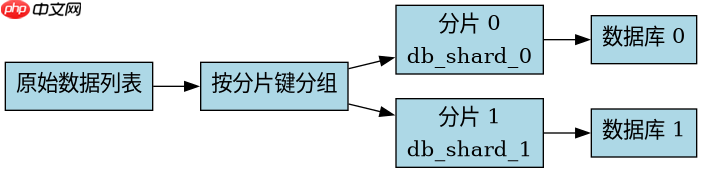
如何根据分片键将数据分组并路由到不同数据库
首先需要确定分片策略,通常采用取模或哈希算法。假设我们有两个数据库实例:db_shard_0和db_shard_1。我们将用户ID为偶数的数据路由到db_shard_0,奇数路由到db_shard_1。这一步骤不涉及数据库操作,纯粹是内存中的数据整理,确保后续能正确获取对应数据源。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

public class BatchShardingExample {
    // 模拟两个数据源的配置
    private static final String URL_0 = "jdbc:mysql://localhost:3306/db_shard_0";
    private static final String USER = "root";
    private static final String PASSWORD = "password";

    public static void main(String[] args) {
        List<User> allUsers = new ArrayList<>();
        for (int i = 1; i <= 10; i++) {
            allUsers.add(new User(i, "user_" + i));
        }

        // 1. 数据分组
        Map<Integer, List<User>> shardedData = partitionData(allUsers);

        // 2. 执行批量插入
        executeBatchInsert(shardedData);
    }

    private static Map<Integer, List<User>> partitionData(List<User> users) {
        Map<Integer, List<User>> map = new HashMap<>();
        for (User u : users) {
            int shardId = u.getId() % 2;
            map.computeIfAbsent(shardId, k -> new ArrayList<>()).add(u);
        }
        return map;
    }

    private static void executeBatchInsert(Map<Integer, List<User>> shardedData) {
        for (Map.Entry<Integer, List<User>> entry : shardedData.entrySet()) {
            int shardId = entry.getKey();
            List<User> users = entry.getValue();
            String url = shardId == 0 ? URL_0 : URL_0.replace("0", "1"); // 简化处理,实际应配置多个URL
            if (shardId == 1) url = "jdbc:mysql://localhost:3306/db_shard_1";

            try (Connection conn = DriverManager.getConnection(url, USER, PASSWORD)) {
                conn.setAutoCommit(false);
                String sql = "INSERT INTO users (id, name) VALUES (?, ?)";
                try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                    for (User u : users) {
                        pstmt.setInt(1, u.getId());
                        pstmt.setString(2, u.getName());
                        pstmt.addBatch();
                    }
                    pstmt.executeBatch();
                    conn.commit();
                } catch (Exception e) {
                    conn.rollback();
                    throw e;
                }
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
    }

    static class User {
        int id;
        String name;
        User(int id, String name) { this.id = id; this.name = name; }
    }
}
如何在代码中管理多数据源连接与事务
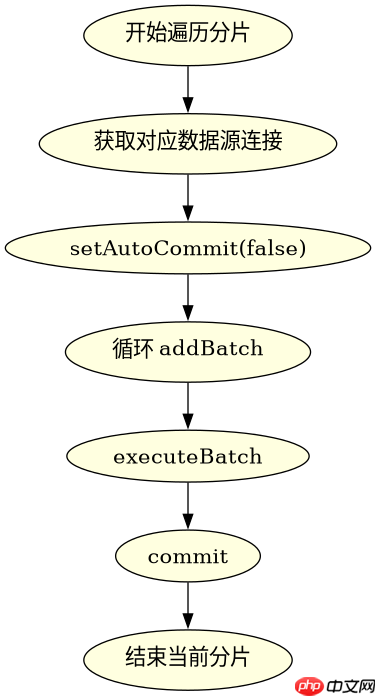
在分组完成后,需要针对每个分片独立管理连接。关键在于setAutoCommit(false)开启事务,并在try-with-resources块中确保资源释放。如果某个分片的批量插入失败,必须执行conn.rollback()以保证数据一致性。上述代码展示了如何遍历分组后的数据,动态选择URL,建立连接,并执行批量操作。

Java开发手册规约集合,基于阿里巴巴Java开发手册(嵩山版)。 涵盖7大维度:编程规约、异常日志、单元测试、安全规约、MySQL数据库、工程结构、设计规约。
立即学习“Java免费学习笔记(深入)”;
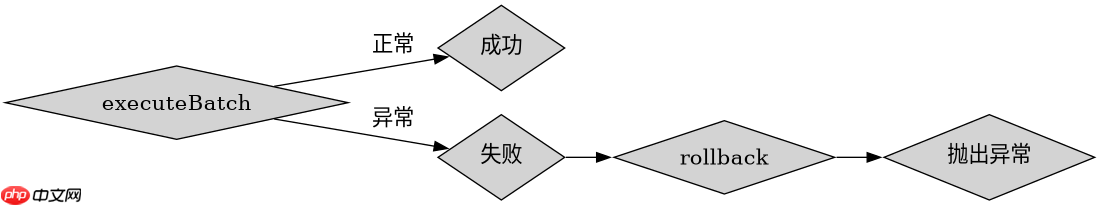
当某个分片插入失败时程序会如何处理
如果在执行pstmt.executeBatch()时发生异常(如主键冲突或网络中断),代码会捕获异常并调用conn.rollback()。这意味着该分片内所有已addBatch但未提交的数据都会回滚,不会部分写入。其他未处理的分片不受影响,但整个方法会抛出异常,调用方需决定是重试还是记录日志。这种机制确保了单个分片内的原子性,但跨分片的全局一致性需要更复杂的分布式事务方案支持。



















