








JDBC 事务中如何配置读写分离
在 jdbc 中实现批量操作的读写分离,核心在于维护两个独立的 connection 对象:一个用于写操作的主库连接,另一个用于读操作的从库连接。通过手动管理这两个连接的 autocommit 状态,可以确保在同一业务逻辑下,写操作在主库提交,而读操作在从库执行,从而实现数据隔离与负载均衡。
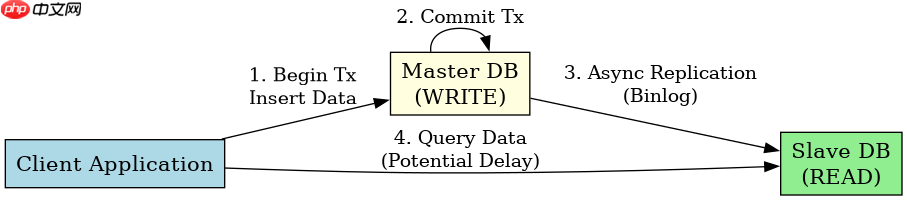
具体做法是创建主库连接并开启事务,同时创建从库连接并关闭自动提交。在执行批量写入时,使用主库连接;在需要读取中间结果或验证数据时,使用从库连接。需要注意的是,由于数据库复制存在延迟,从库可能无法立即读到主库的最新数据,因此这种模式适用于对实时一致性要求不高的场景。
JDBC 批量操作的具体代码实现
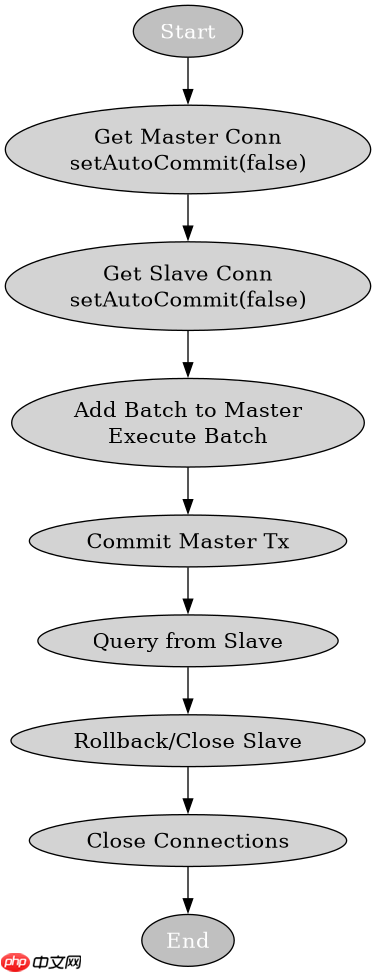
JDBC 批量操作通过 addBatch() 和 executeBatch() 方法实现,能显著减少网络往返次数。结合读写分离,我们需要在一个方法中同时处理主库的写入和从库的查询,并确保两者的事务独立性。
立即学习“Java免费学习笔记(深入)”;

Java开发手册规约集合,基于阿里巴巴Java开发手册(嵩山版)。 涵盖7大维度:编程规约、异常日志、单元测试、安全规约、MySQL数据库、工程结构、设计规约。
import java.sql.*;

public class JdbcReadWriteBatch {
    public static void main(String[] args) {
        Connection masterConn = null;
        Connection slaveConn = null;
        try {
            // 1. 获取主库连接(写)
            masterConn = DriverManager.getConnection("jdbc:mysql://master:3306/db", "user", "pass");
            masterConn.setAutoCommit(false);

            // 2. 获取从库连接(读)
            slaveConn = DriverManager.getConnection("jdbc:mysql://slave:3306/db", "user", "pass");
            slaveConn.setAutoCommit(false); // 显式关闭,便于控制

            // 3. 批量写入主库
            String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
            PreparedStatement pstmt = masterConn.prepareStatement(sql);
            for (int i = 0; i < 100; i++) {
                pstmt.setString(1, "User_" + i);
                pstmt.setString(2, "user_" + i + "@example.com");
                pstmt.addBatch();
            }
            int[] results = pstmt.executeBatch();
            System.out.println("Batch insert count: " + results.length);

            // 4. 主库提交
            masterConn.commit();

            // 5. 从库读取(注意:可能因复制延迟查不到刚插入的数据)
            Statement stmt = slaveConn.createStatement();
            ResultSet rs = stmt.executeQuery("SELECT COUNT(*) FROM users");
            if (rs.next()) {
                System.out.println("Slave DB Count: " + rs.getInt(1));
            }

            // 6. 清理资源
            slaveConn.rollback(); // 读操作通常不需要commit,但需保持状态一致
            pstmt.close();
            stmt.close();
        } catch (SQLException e) {
            if (masterConn != null) try { masterConn.rollback(); } catch (SQLException ex) {}
            if (slaveConn != null) try { slaveConn.rollback(); } catch (SQLException ex) {}
            e.printStackTrace();
        } finally {
            if (masterConn != null) try { masterConn.close(); } catch (SQLException e) {}
            if (slaveConn != null) try { slaveConn.close(); } catch (SQLException e) {}
        }
    }
}
上述代码展示了完整的流程。首先分别获取主从连接并关闭自动提交。接着使用主库连接进行批量插入,调用 executeBatch() 后提交事务。随后使用从库连接执行查询。最后务必在 finally 块中关闭所有连接,防止资源泄露。
主库提交后从库查询结果的延迟问题
当主库完成 commit() 后,立即在从库执行查询,返回的结果可能不包含最新插入的数据。这是因为 MySQL 的主从复制通常是异步的,从库需要通过 I/O 线程接收主库的 binlog,再由 SQL 线程重放,这个过程存在毫秒到秒级的延迟。
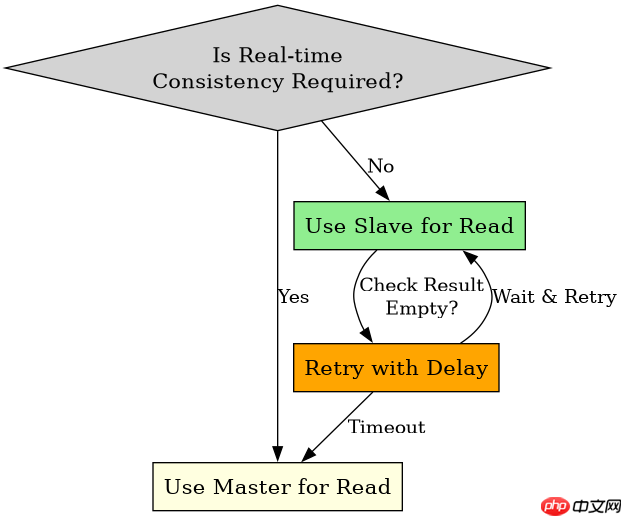
为了解决这个问题,可以在代码中加入重试机制,或者在强一致性要求的场景下,强制从库路由到主库。但在本例的批量操作场景中,如果业务允许最终一致性,可以直接忽略短暂的不一致。若必须读取最新数据,应复用主库连接进行查询,但这会破坏读写分离的性能优势。因此,设计时需权衡性能与数据实时性。


















