








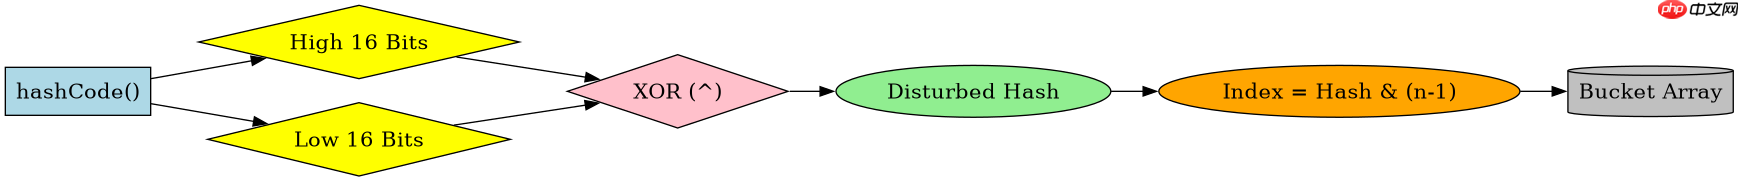
java hashmap 的哈希扰动函数通过让高16位与低16位进行异或运算,将高位的信息混合到低位中,从而减少哈希冲突。具体做法是在计算索引时,先调用 hash() 方法对键对象的 hashcode() 结果进行扰动处理,再与数组长度减一进行按位与操作。这样做能确保即使低位相同,高位不同的对象也能被分散到不同的桶中,提高散列均匀性。
为什么直接取模会导致冲突
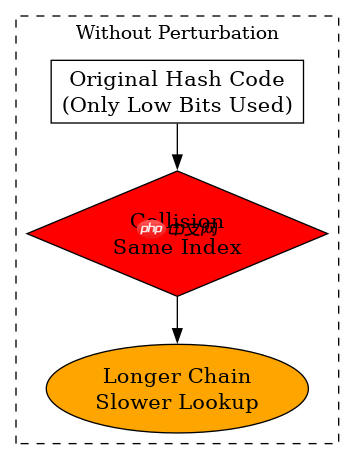
如果不使用扰动函数,直接使用 hashCode() 的低16位作为索引,当数组长度较小时,高位信息会被忽略。例如,如果两个对象的 hashCode() 仅在高位不同而低位相同,它们会映射到同一个桶中,导致链表或红黑树过长,降低查询效率。
public class Key {
    private int value;

    public Key(int value) {
        this.value = value;
    }

    @Override
    public int hashCode() {
        return value;
    }

    @Override
    public boolean equals(Object obj) {
        if (this == obj) return true;
        if (obj == null || getClass() != obj.getClass()) return false;
        Key key = (Key) obj;
        return value == key.value;
    }
}

import java.util.HashMap;
import java.util.Map;

public class Main {
    public static void main(String[] args) {
        Map<Key, String> map = new HashMap<>(4);
        // 构造两个hashCode低位相同但高位不同的对象
        Key k1 = new Key(0x00000001);
        Key k2 = new Key(0x00010001);
        Key k3 = new Key(0x00020001);
        Key k4 = new Key(0x00030001);

        map.put(k1, "A");
        map.put(k2, "B");
        map.put(k3, "C");
        map.put(k4, "D");

        System.out.println("Size: " + map.size());
        System.out.println("k1 bucket: " + Integer.toBinaryString(map.hashCode(k1) & (map.capacity() - 1)));
        System.out.println("k2 bucket: " + Integer.toBinaryString(map.hashCode(k2) & (map.capacity() - 1)));
    }
}
运行上述代码,若不使用扰动函数,k1 和 k2 可能落入同一桶。使用扰动后,它们的索引分布更均匀。
立即学习“Java免费学习笔记(深入)”;

扰动函数的具体实现原理
扰动函数的核心是 (h ^ (h >>> 16))`。它将哈希值的高16位右移16位后与原值异或。这样,原本只依赖低16位的索引计算,现在也受到了高位的影响。在数组长度为2的幂时,<code>n - 1 的二进制形式是全1,按位与操作能保留所有有效位。扰动后的哈希值能更好地利用这些位,减少碰撞概率。
// Java 8+ HashMap 内部实现片段
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}

// 计算索引
int index = hash(key) & (table.length - 1);
这种设计避免了传统乘法散列法的开销,同时提升了分布质量。对于自定义键对象,建议重写 hashCode() 以生成分布均匀的初始值,配合扰动函数效果更佳。
扰动后索引分布的具体表现
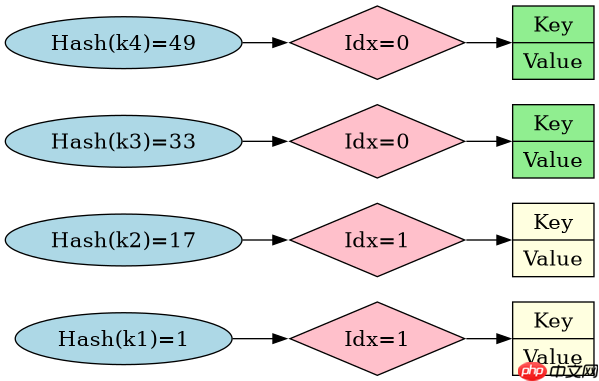
以数组长度为4为例,n - 1 为3(二进制11)。假设四个对象的原始 hashCode() 分别为1、17、33、49。未扰动时,它们都等于1,全部落入索引1。扰动后,1变为1^0=1,17变为17^0=17(10001),33变为33^1=32(100000),49变为49^1=48(110000)。与3按位与后,索引分别为1、1、0、0。虽然仍有冲突,但相比全集中在一个桶,分布已改善。若数组更大,如16,扰动效果更显著,能充分利用更多低位比特。


















