








复制算法(copying algorithm)是一种内存回收策略,它将可用内存按容量划分为大小相等的两块,每次只使用其中一块。当这一块内存用完了,就将还存活着的对象复制到另外一块上面,然后再把已经使用过的内存空间一次清理掉。

复制算法如何处理对象存活与内存分配
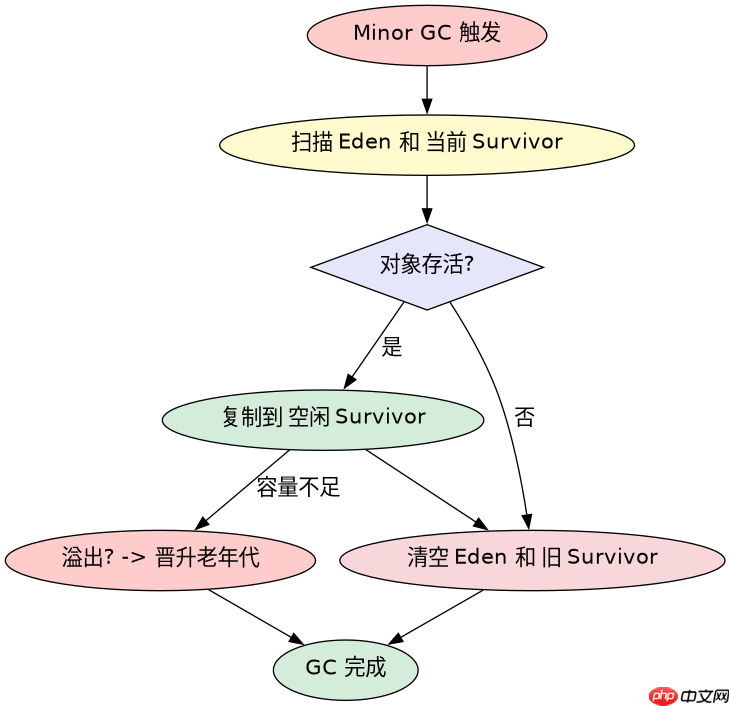
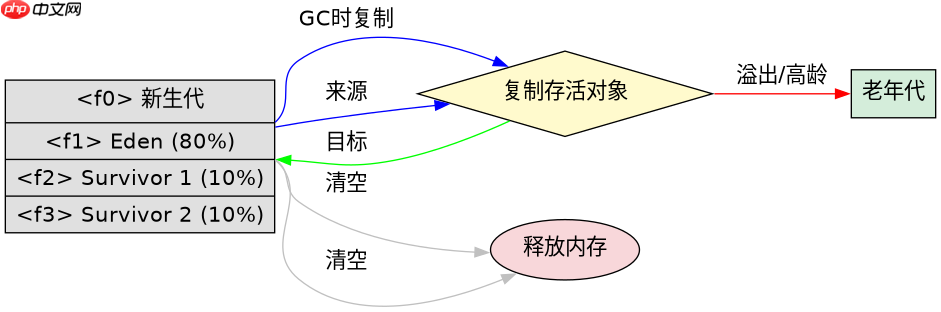
在Java虚拟机中,复制算法主要应用于新生代(Young Generation),特别是其中的Eden区和Survivor区。其核心逻辑是:所有对象都先在Eden区分配,当触发Minor GC时,系统检查Eden区和当前使用的Survivor区中存活的对象,并将它们复制到另一个空的Survivor区中。随后,清空Eden区和原Survivor区的所有内存。这种机制确保了 Survivor 区始终是“干净”的,无需进行复杂的内存整理操作。
public class CopyingGCExample {
    // 模拟对象生命周期
    static class ObjectData {
        byte[] payload = new byte[1024];
        int id;
        public ObjectData(int id) { this.id = id; }
    }

    public static void main(String[] args) {
        // 1. 初始化 Eden 和 Survivor 区域模拟
        // 假设 Eden 容量为 10MB, Survivor 容量为 5MB
        double edenCapacity = 10.0;
        double survivorCapacity = 5.0;

        // 模拟 Eden 中已有对象
        java.util.List<ObjectData> edenObjects = new java.util.ArrayList<>();
        for (int i = 0; i < 80; i++) { // 占用约 8MB
            edenObjects.add(new ObjectData(i));
        }

        System.out.println("GC前: Eden占用 " + (edenObjects.size() * 1.0 / 10) + "MB");

        // 2. 触发 Minor GC (复制算法)
        java.util.List<ObjectData> targetSurvivor = new java.util.ArrayList<>();
        int survivingCount = 0;

        for (ObjectData obj : edenObjects) {
            // 模拟存活判断:ID为偶数的对象存活
            if (obj.id % 2 == 0) {
                targetSurvivor.add(obj);
                survivingCount++;
            }
        }

        // 3. 清理 Eden 和旧 Survivor
        edenObjects.clear();
        System.out.println("GC后: Eden已清空, Survivor存活 " + survivingCount + " 个对象");

        // 4. 检查是否溢出到老年代
        if (targetSurvivor.size() * 1.0 / 10 > survivorCapacity) {
            System.out.println("警告: 存活对象超过 Survivor 容量,部分对象晋升至老年代");
        } else {
            System.out.println("成功: 所有存活对象已复制到 Survivor 区");
        }
    }
}
上述代码展示了复制算法的基本流程。首先创建一组模拟对象放入Eden区。当GC发生时,程序遍历这些对象,根据特定条件(如ID奇偶性)筛选出存活对象。存活对象被添加到目标Survivor列表中,而源Eden列表被清空。如果存活对象数量导致所需内存超过Survivor区的设定容量,则说明发生了“浮动垃圾”或需要晋升到老年代,这在实际JVM中会触发相应的处理机制。该过程避免了内存碎片,且由于只需复制存活对象,效率较高,尤其适合对象存活率低的场景。
立即学习“Java免费学习笔记(深入)”;

复制算法在分代收集理论中的位置与局限
尽管复制算法高效,但它存在一个显著缺点:可使用的内存规模减半。为了克服这一问题,现代JVM(如HotSpot)并不简单地使用两个对称的内存区域,而是将新生代划分为一块较大的Eden空间和两块较小的Survivor空间(通常比例为8:1:1)。每次GC时,只使用Eden和其中一块Survivor,回收时将存活对象复制到另一块Survivor,然后一次性清除Eden和已用Survivor。这样既保留了复制算法的高效性,又充分利用了内存空间。
public class GenerationalCopyAnalysis {
    public static void main(String[] args) {
        // 分析不同存活率下的性能表现
        double totalMemory = 100.0; // 总新生代内存单位
        double edenRatio = 0.8;     // Eden占比
        double survivorRatio = 0.1; // 单Survivor占比

        double edenSize = totalMemory * edenRatio;
        double survivorSize = totalMemory * survivorRatio;

        // 测试不同存活对象比例
        double[] survivalRates = {0.1, 0.5, 0.9};

        for (double rate : survivalRates) {
            long survivedObjects = Math.round(1000 * rate);
            double requiredSpace = survivedObjects * 0.1; // 假设每对象0.1单位

            String status = "OK";
            if (requiredSpace > survivorSize) {
                status = "OVERFLOW_TO_OLD_GEN";
            }

            System.out.printf("存活率 %.0f%%: 需 %.2f 单位, Survivor容量 %.2f, 结果: %s%n",
                    rate * 100, requiredSpace, survivorSize, status);
        }
    }
}
这段代码分析了不同存活率对复制算法的影响。当存活率较低时(如10%),复制少量对象即可,速度极快。但当存活率升高(如90%),需要复制的对象增多,且可能超出Survivor区容量,导致对象直接晋升到老年代。这说明复制算法最适合“朝生夕死”的对象。对于存活率高的场景,标记-清除或标记-压缩算法更为合适。因此,JVM采用混合策略:新生代用复制算法,老年代用标记-整理算法,以平衡速度与空间利用率。
为什么复制算法能避免内存碎片化问题
内存碎片化是垃圾回收中的常见难题,尤其在长期运行、对象生命周期各异的应用中。复制算法通过“移动”存活对象来解决这个问题。在复制过程中,所有存活对象被紧凑地复制到目标区域的起始位置,中间不留空隙。这意味着每次GC后,剩余内存都是连续可用的,从根本上消除了外部碎片。相比之下,标记-清除算法会在内存中留下大量空洞,长期使用会导致内存分配失败,即使总空闲内存足够。

















