








preparedstatement 本身不支持直接设置 distinct 关键字作为参数,因为 distinct 是 sql 语法的一部分而非占位符值。你需要将完整的 sql 语句拼接好,其中包含 distinct 关键字,然后对需要过滤的具体列值使用 setstring、setint 等方法进行参数绑定。这样做既能利用 preparedstatement 防止 sql 注入,又能确保数据库正确执行去重查询。

如何构建带 DISTINCT 的 SQL 字符串并绑定参数
在 Java 中创建 PreparedStatement 时,SQL 模板必须硬编码 DISTINCT 关键字。例如,查询用户表中不重复的城市名,SQL 应写为 SELECT DISTINCT city FROM users WHERE status = ?。接着通过 PreparedStatement.setString(1, "active") 绑定状态参数。这种写法让数据库解析器先识别 DISTINCT 语义,再处理参数替换,从而返回去重后的结果集。
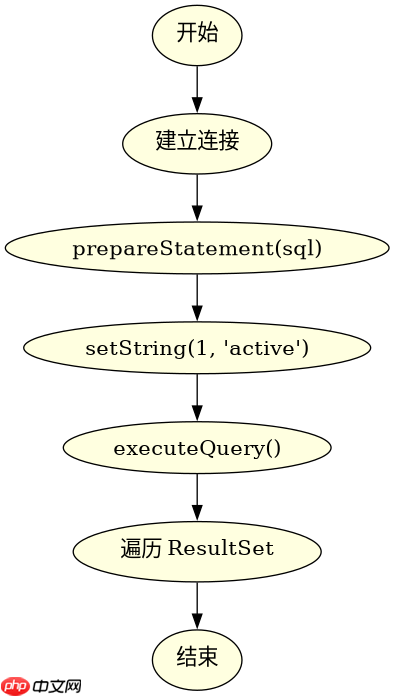
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;

public class DistinctExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        String sql = "SELECT DISTINCT city FROM users WHERE status = ?";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            pstmt.setString(1, "active");

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    System.out.println(rs.getString("city"));
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
运行上述代码,假设数据库中 users 表有三条记录:(1, 'Beijing', 'active')、(2, 'Shanghai', 'active')、(3, 'Beijing', 'inactive')。由于我们绑定了 status = 'active',且使用了 DISTINCT,输出将仅包含 Beijing 和 Shanghai 各一次,不会重复打印 Beijing。
立即学习“Java免费学习笔记(深入)”;

DISTINCT 与 GROUP BY 的性能差异及选择
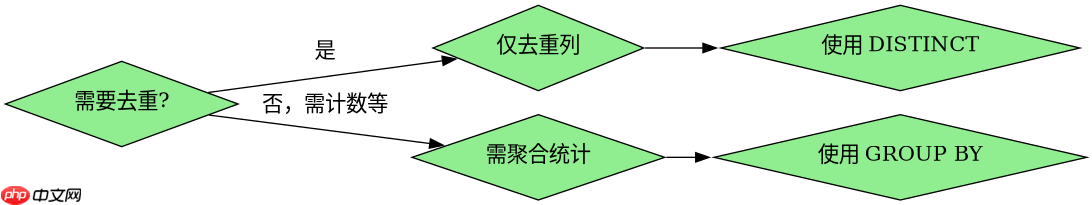
当需要去重时,除了 DISTINCT,还可以使用 GROUP BY。两者在功能上相似,但执行计划不同。DISTINCT 通常用于简单去重,而 GROUP BY 允许同时聚合其他列。对于仅去重的场景,DISTINCT 语义更清晰,数据库优化器也常针对其做特定优化。若需统计每城市的人数,则必须用 GROUP BY。在实际开发中,优先使用 DISTINCT 保持意图明确,除非需要额外聚合信息。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;

public class GroupByComparison {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        // 使用 GROUP BY 替代 DISTINCT 以获取计数
        String sql = "SELECT city, COUNT(*) as cnt FROM users WHERE status = ? GROUP BY city";

        try (Connection conn = DriverManager.getConnection(url, user, password);
             PreparedStatement pstmt = conn.prepareStatement(sql)) {

            pstmt.setString(1, "active");

            try (ResultSet rs = pstmt.executeQuery()) {
                while (rs.next()) {
                    System.out.println(rs.getString("city") + ": " + rs.getInt("cnt"));
                }
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
使用同一组输入数据,上述 GROUP BY 查询将输出:Beijing: 1 和 Shanghai: 1。这表明虽然两个城市都只有一条活跃记录,但 GROUP BY 提供了计数信息。若仅需城市列表,DISTINCT 更高效;若需分析分布,GROUP BY 更合适。开发者应根据业务需求选择,避免滥用 GROUP BY 导致不必要的排序开销。
当 DISTINCT 应用于多列时如何处理参数绑定
如果 DISTINCT 涉及多列,如 SELECT DISTINCT city, country FROM users WHERE status = ?,参数绑定方式不变,仍按位置索引设置。数据库会对所有选定列的组合进行去重。例如,若存在两条记录 (Beijing, China) 和 (Beijing, USA),它们将被视为不同行并全部保留。只有当 city 和 country 完全相同时才会去重。开发者需注意,多列 DISTINCT 可能增加内存消耗,尤其在大数据集上,建议结合索引优化查询性能。


















