








java iterator 的性能并不比 for-each 循环差,在大多数场景下两者性能几乎一致。for-each 循环在编译时会被自动转换为使用 iterator 的实现(针对非数组集合)或直接使用索引访问(针对数组),因此其底层开销与显式调用 iterator 相同。对于 arraylist 等支持随机访问的集合,基于索引的 for 循环可能略快,因为它避免了 iterator 对象的创建和 next() 方法的虚方法调用开销,但这种差异在实际应用中通常可以忽略不计。
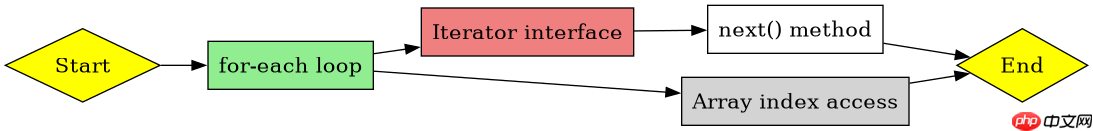
Iterator 与 for-each 循环的底层实现机制是什么
Iterator 是一个接口,它定义了 hasNext() 和 next() 两个核心方法。当你在代码中使用 for-each 循环遍历一个实现了 Iterable 接口的集合时,编译器会将其转换为使用 Iterator 的代码。这意味着 for-each 循环本质上就是 Iterator 的一种语法糖。对于数组,for-each 循环则直接使用索引进行访问,不涉及 Iterator。这种转换是透明的,开发者无需手动管理迭代器的状态,从而减少了出错的可能性。
import java.util.ArrayList;
import java.util.Iterator;
import java.util.List;

public class PerformanceTest {
    public static void main(String[] args) {
        List<Integer> list = new ArrayList<>();
        for (int i = 0; i < 1000000; i++) {
            list.add(i);
        }

        long startTime = System.nanoTime();
        // 使用 Iterator
        Iterator<Integer> iterator = list.iterator();
        while (iterator.hasNext()) {
            iterator.next();
        }
        long endTime = System.nanoTime();
        System.out.println("Iterator time: " + (endTime - startTime) + " ns");

        startTime = System.nanoTime();
        // 使用 for-each
        for (Integer num : list) {
            // do nothing
        }
        endTime = System.nanoTime();
        System.out.println("For-each time: " + (endTime - startTime) + " ns");

        startTime = System.nanoTime();
        // 使用索引 for 循环
        for (int i = 0; i < list.size(); i++) {
            list.get(i);
        }
        endTime = System.nanoTime();
        System.out.println("Index-based for time: " + (endTime - startTime) + " ns");
    }
}
运行上述代码,你会观察到 Iterator 和 for-each 的执行时间非常接近,而索引 for 循环可能会稍快一些,尤其是在数据量较大时。这是因为 ArrayList 的 get(i) 操作是 O(1) 复杂度的,而 Iterator 的 next() 虽然也是 O(1),但涉及对象方法调用。然而,这种微小的差异在绝大多数业务场景中不会对整体性能产生显著影响。

立即学习“Java免费学习笔记(深入)”;
在哪些情况下 Iterator 或 for-each 会比索引 for 循环更优
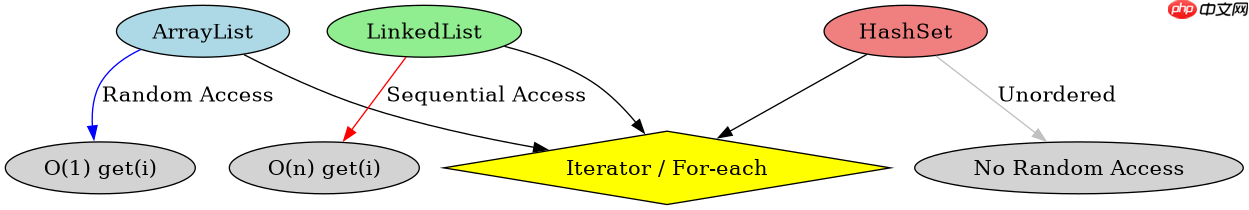
虽然索引 for 循环在 ArrayList 上可能略快,但 Iterator 和 for-each 循环具有更好的通用性和安全性。它们适用于所有实现了 Iterable 接口的集合,包括 LinkedList、HashSet、TreeSet 等。对于 LinkedList,由于 get(i) 操作需要从头遍历到指定位置,时间复杂度为 O(n),因此使用索引 for 循环会导致整体性能急剧下降至 O(n^2)。而 Iterator 的 next() 操作在 LinkedList 中是 O(1) 的,因此在这种情况下,Iterator 或 for-each 循环明显优于索引 for 循环。此外,Iterator 允许在遍历过程中安全地删除元素,而不会引发 ConcurrentModificationException,这是索引 for 循环无法做到的。
import java.util.LinkedList;
import java.util.List;

public class LinkedListPerformanceTest {
    public static void main(String[] args) {
        List<String> linkedList = new LinkedList<>();
        for (int i = 0; i < 10000; i++) {
            linkedList.add("Element " + i);
        }

        long startTime = System.nanoTime();
        // 使用 Iterator
        for (String s : linkedList) {
            // do nothing
        }
        long endTime = System.nanoTime();
        System.out.println("LinkedList For-each time: " + (endTime - startTime) + " ns");

        startTime = System.nanoTime();
        // 使用索引 for 循环
        for (int i = 0; i < linkedList.size(); i++) {
            linkedList.get(i);
        }
        endTime = System.nanoTime();
        System.out.println("LinkedList Index-based for time: " + (endTime - startTime) + " ns");
    }
}
运行上述代码,你会发现 LinkedList 使用 for-each 循环的速度远快于索引 for 循环。这证明了在选择遍历方式时,应根据集合的具体类型来决定,而不是一味追求所谓的“更快”的方式。对于不支持随机访问的集合,Iterator 或 for-each 循环是更优的选择。
在使用 Iterator 遍历时移除元素需要注意什么
在使用 Iterator 遍历时,如果需要移除元素,必须使用 Iterator 提供的 remove() 方法,而不能直接调用集合的 remove() 方法。否则,会触发 fail-fast 机制,抛出 ConcurrentModificationException 异常。这是因为集合内部维护了一个 modCount 变量,用于记录集合结构被修改的次数。每次通过 Iterator 的 remove() 方法移除元素时,modCount 会被正确更新,而如果直接调用集合的 remove() 方法,modCount 的更新时机可能与 Iterator 的预期不一致,从而导致异常。因此,为了安全地移除元素,应始终依赖 Iterator 的 remove() 方法。



















