








i += 1 与 i = i + 1 在编译时有什么区别
java 中的 += 赋值运算符会自动进行隐式类型转换,而 = 结合 + 则不会。这意味着在使用 i += 1 时,即使右侧表达式的结果类型比左侧变量宽,编译器也会自动插入强制类型转换,而使用 i = i + 1 时如果存在精度丢失风险(如 int 加 long),则会直接报错。
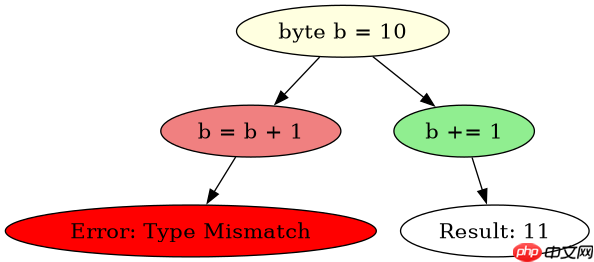
public class Test { public static void main(String[] args) { byte b = 10; // b = b + 1; // 编译错误:可能损失精度 b += 1; // 编译通过,等价于 b = (byte)(b + 1); System.out.println(b); } }上述代码中,b = b + 1 会触发编译错误,因为 1 是 int 类型,b + 1 的结果也是 int,不能直接赋给 byte。而 b += 1 之所以能通过,是因为 Java 编译器将其视为 b = (byte)(b + 1),自动进行了窄化原始转换。
为什么 += 需要隐式转换而 + 不需要
这种设计主要是为了简化开发者的日常操作,避免在频繁的类型混合运算中编写大量的强制类型转换代码。根据 JLS(Java Language Specification)第 15.26.2 节的规定,复合赋值运算符 E1 op= E2 等价于 E1 = (T) (E1 op E2),其中 T 是 E1 的类型。这一规则确保了操作的原子性和类型安全性,同时减少了样板代码。

立即学习“Java免费学习笔记(深入)”;
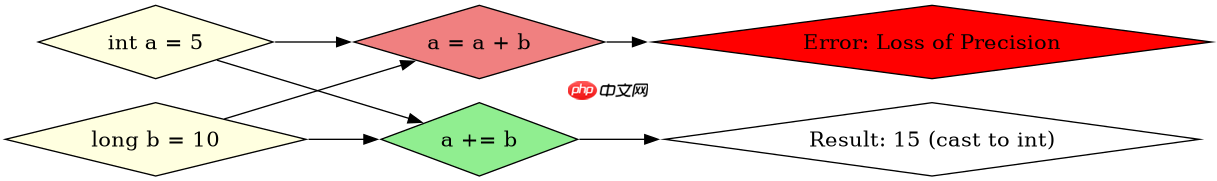
public class Test2 { public static void main(String[] args) { int a = 5; long b = 10; // a = a + b; // 错误:无法从 long 转换为 int a += b; // 正确:等价于 a = (int)(a + b); System.out.println(a); } }在第二个示例中,a 是 int,b 是 long。a + b 的结果是 long,如果尝试用 a = a + b 赋值,编译器会报错,因为存在从 long 到 int 的潜在精度丢失。而 a += b 会自动将结果强制转换为 int,从而允许代码编译通过。这种行为虽然方便,但也可能导致意外的数据截断,开发者在使用时应注意潜在的精度问题。
+= 在处理字符串时的行为是什么
当 += 用于字符串连接时,它同样遵循隐式转换的规则,但这里的“转换”是指将非字符串类型转换为字符串类型。具体来说,s += obj 等价于 s = s + String.valueOf(obj)。这与数值类型的隐式强转不同,字符串连接涉及的是类型到字符串的转换,通常通过调用 toString() 或 String.valueOf() 实现。



















