








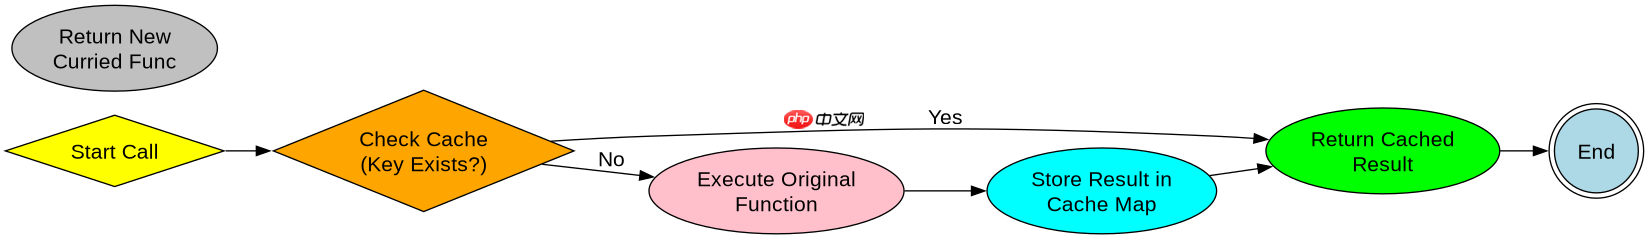
javascript 中函数柯里化实现缓存,核心在于利用闭包将计算结果存储在外部作用域中,并在每次调用时优先检查该存储区域。具体做法是创建一个包装函数,内部维护一个 map 或普通对象作为缓存容器;当被柯里化的函数被调用时,先根据传入的参数生成唯一的键(key),若键已存在则直接返回缓存值,否则执行原函数并将结果存入缓存后返回。这样做能确保相同输入在多次调用时避免重复计算,显著提升性能。
如何编写支持多参数缓存的通用柯里化高阶函数
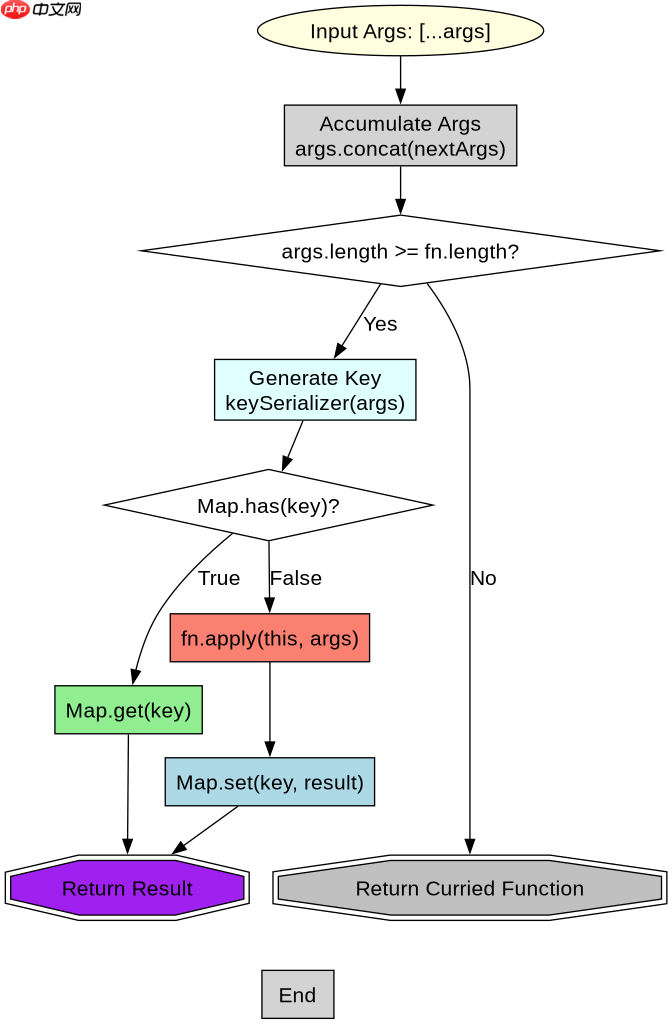
要实现通用的缓存型柯里化,需要处理两个关键问题:一是参数的累积与拼接,二是缓存键的唯一性生成。我们通常定义一个 `curryWithCache` 函数,它接收原始函数 `fn` 和可选的序列化策略。在内部,我们使用一个闭包变量 `cache` 来存储结果。柯里化的过程是通过返回一个新函数来实现的,这个新函数接收部分参数,并判断是否已经收集到了所有必需的参数。如果参数不足,它返回一个新的函数继续等待剩余参数;如果参数已满,它生成键、查缓存、执行或存缓存。
function curryWithCache(fn, keySerializer = JSON.stringify) {
  const cache = new Map();

  function curried(...args) {
    // 判断是否参数已收集齐全
    if (args.length >= fn.length) {
      // 生成唯一缓存键
      const key = keySerializer(args);

      // 检查缓存
      if (cache.has(key)) {
        console.log(`Hit cache for key: ${key}`);
        return cache.get(key);
      }

      // 执行原函数并缓存结果
      const result = fn.apply(this, args);
      cache.set(key, result);
      return result;
    } else {
      // 参数不足,返回新的柯里化函数
      return function(...nextArgs) {
        return curried.apply(this, args.concat(nextArgs));
      };
    }
  }

  return curried;
}
上述代码展示了一个基础的实现。`fn.length` 用于获取函数声明时的形参个数,以此判断何时触发执行。`keySerializer` 允许自定义键的生成方式,默认使用 `JSON.stringify` 将参数数组序列化为字符串。例如,对于加法函数 `add(a, b)`,调用 `curriedAdd(1)(2)` 时,第一次会执行加法并存入缓存,第二次调用 `curriedAdd(1)(2)` 时,会直接从 Map 中取出结果。需要注意的是,这种简单的基于 `fn.length` 的判断在处理可变参数或默认参数时可能不够健壮,但在固定参数场景下非常有效。
立即学习“Java免费学习笔记(深入)”;

如何处理复杂对象参数导致的缓存键冲突
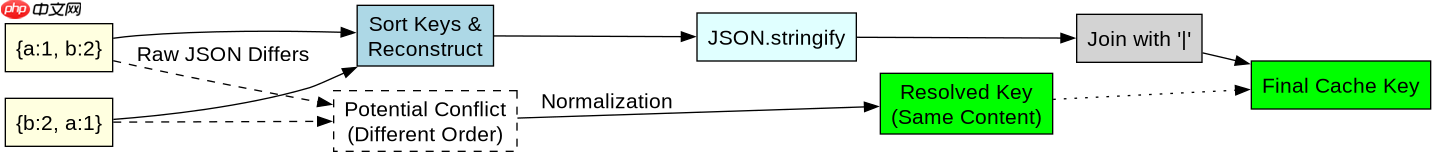
当函数的参数包含对象、数组等引用类型时,直接使用 `JSON.stringify` 可能会产生意外的缓存命中或冲突。例如,`{a: 1, b: 2}` 和 `{b: 2, a: 1}` 在 JSON 序列化后字符串不同,但逻辑上可能被视为相同输入;或者两个不同的对象实例具有相同的属性值。为了解决这个问题,我们需要更精细的键生成策略,或者限制缓存仅适用于可哈希的基本类型参数。在实际工程中,常引入第三方库如 `lodash.memoize` 来处理这些边缘情况,或者手动实现深度比较的键生成器。
// 改进版:针对对象参数的简单哈希键生成
function getSafeKey(args) {
  return args.map(arg => {
    if (typeof arg === 'object' && arg !== null) {
      // 对对象进行排序后的 JSON 序列化,减少顺序带来的差异
      return JSON.stringify(Object.keys(arg).sort().reduce((obj, key) => {
        obj[key] = arg[key];
        return obj;
      }, {}));
    }
    return String(arg);
  }).join('|');
}

// 使用示例
const expensiveCalc = (config) => {
  console.log('Calculating...');
  return config.a * config.b;
};

const cachedExpensiveCalc = curryWithCache(expensiveCalc, getSafeKey);

console.log(cachedExpensiveCalc({a: 1, b: 2})); // 计算并缓存
console.log(cachedExpensiveCalc({b: 2, a: 1})); // 命中缓存(假设键生成一致)
通过自定义 `getSafeKey` 函数,我们可以对对象参数进行规范化处理,比如按键名排序后再序列化,从而降低因属性顺序不同导致的缓存未命中。同时,使用分隔符 `|` 连接各参数的键,确保整体键的唯一性。这种方式比单纯的 `JSON.stringify(args)` 更具可控性。然而,对于极其复杂的嵌套对象,深度比较依然昂贵,此时应考虑是否真的需要缓存,或者使用 LRU(最近最少使用)缓存策略来限制内存占用,因为上述简单实现中的 `Map` 会无限增长。
基于特定输入条件如何验证缓存是否生效
为了验证缓存机制是否按预期工作,我们可以构造一组明确的输入,观察控制台输出和返回值。以之前的 `curryWithCache` 为例,我们定义一个简单的乘法函数,并分别进行首次调用和重复调用。通过对比两次调用的耗时或日志输出,可以直观地看到缓存的效果。此外,还可以测试不同输入下的缓存隔离情况,确保互不干扰。
const multiply = (x, y) => x * y;
const cachedMultiply = curryWithCache(multiply);

// 首次调用:应触发实际计算
const res1 = cachedMultiply(3)(4);
console.log(res1); // 输出: 12

// 第二次调用相同参数:应命中缓存
const res2 = cachedMultiply(3)(4);
console.log(res2); // 输出: 12

// 调用不同参数:应触发新计算
const res3 = cachedMultiply(5)(6);
console.log(res3); // 输出: 30

// 再次调用之前不同但已缓存的参数:应命中缓存
const res4 = cachedMultiply(5)(6);
console.log(res4); // 输出: 30
运行上述代码,第一次 `cachedMultiply(3)(4)` 会在 `curried` 函数中执行 `fn.apply`,并将结果存入 `cache`。第二次调用时,`cache.has(key)` 返回 true,直接返回存储的值,不会进入 `fn.apply` 分支。同理,`(5, 6)` 的组合也会经历一次计算后被缓存。这种验证方式清晰地展示了缓存的生命周期:查询、缺失则计算并存储、命中则直接返回。开发者可以通过修改 `keySerializer` 或输入参数类型,进一步测试边界情况,确保缓存逻辑的鲁棒性。


















