








java jdbc 实现数据挖掘的核心做法是关闭自动提交(autocommit),将批量数据读取、转换和写入操作包裹在显式的事务中,并在处理完成后调用 commit()。通过设置合理的 fetchsize 和控制事务边界,可以确保大批量数据处理的原子性和内存效率。若中间发生异常,调用 rollback() 可保证数据一致性。

JDBC 事务如何控制批量数据的读写流程
JDBC 事务通过 Connection 对象管理,默认情况下 autoCommit 为 true,每条 SQL 语句都会立即提交。在数据挖掘场景中,通常需要读取源表数据,经过计算后写入目标表或更新状态。此时需手动调用 connection.setAutoCommit(false) 开启事务。接着使用 Statement 或 PreparedStatement 执行查询和更新。为了优化性能,应设置 fetchSize 以避免一次性加载全部结果集到内存。当所有数据处理完毕后,调用 connection.commit() 提交事务;若捕获到异常,则调用 connection.rollback() 回滚,确保数据不会部分写入。
import java.sql.*;

public class DataMiningTransaction {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交
            conn.setAutoCommit(false);

            // 2. 设置 fetchSize 以优化大数据量读取
            Statement stmt = conn.createStatement();
            stmt.setFetchSize(1000);

            ResultSet rs = stmt.executeQuery("SELECT id, value FROM source_data");
            PreparedStatement updateStmt = conn.prepareStatement(
                "INSERT INTO mining_results (id, processed_value) VALUES (?, ?)");

            while (rs.next()) {
                int id = rs.getInt("id");
                double value = rs.getDouble("value");
                // 模拟数据挖掘逻辑:值乘以 2
                double result = value * 2;

                updateStmt.setInt(1, id);
                updateStmt.setDouble(2, result);
                updateStmt.addBatch();

                // 每处理 1000 条提交一次批次,避免内存溢出
                if (id % 1000 == 0) {
                    updateStmt.executeBatch();
                }
            }

            // 执行剩余的批次
            updateStmt.executeBatch();

            // 3. 提交事务
            conn.commit();
            System.out.println("Data mining transaction committed successfully.");

        } catch (SQLException e) {
            // 4. 异常时回滚
            System.err.println("Error occurred, rolling back...");
            e.printStackTrace();
        }
    }
}
上述代码展示了完整的 JDBC 事务流程。首先获取连接并禁用自动提交。然后创建 Statement 并设置 fetchSize 为 1000,这样每次从数据库拉取 1000 行数据,减少内存压力。接着遍历结果集,对每行数据进行简单变换(乘以 2),并使用 PreparedStatement 的 addBatch 方法累积插入语句。每处理 1000 条记录执行一次 executeBatch,最后再次执行剩余批次。如果过程中出现 SQLException,catch 块会触发 rollback,确保数据一致性。预期输出为控制台打印 "Data mining transaction committed successfully.",且数据库中 mining_results 表包含处理后的数据。
立即学习“Java免费学习笔记(深入)”;

如何处理事务中的并发与资源释放问题
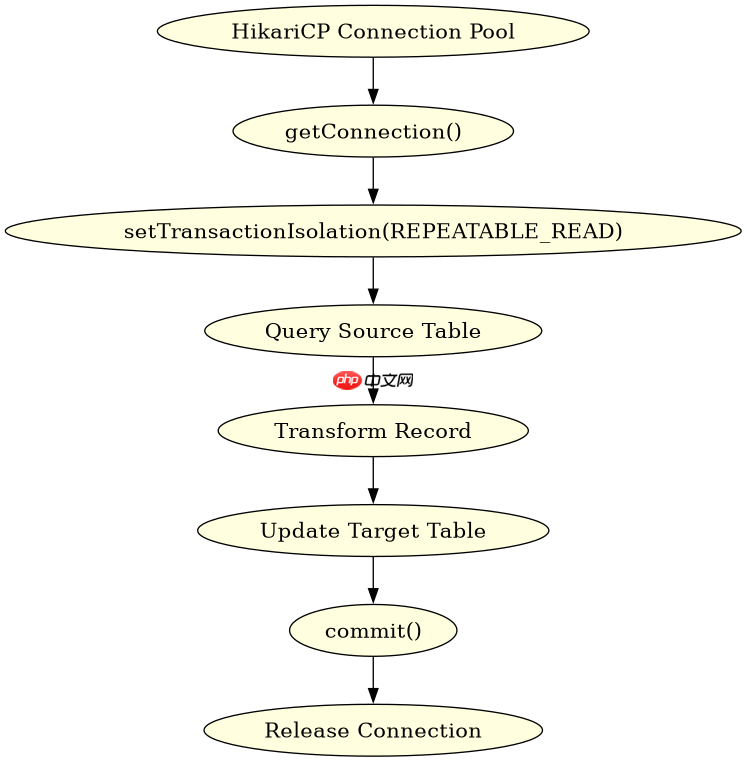
在高并发数据挖掘场景下,事务隔离级别和连接池配置至关重要。JDBC 支持多种事务隔离级别,如 READ_COMMITTED、REPEATABLE_READ 等,可通过 connection.setTransactionIsolation() 设置。对于大多数挖掘任务,READ_COMMITTED 已足够,既能防止脏读,又不会因过高的隔离级别导致性能下降。此外,必须确保在 finally 块或使用 try-with-resources 语法正确关闭 ResultSet、Statement 和 Connection,以防止资源泄漏。若使用连接池(如 HikariCP),还需注意事务超时设置,避免长事务占用连接过久。

import java.sql.*;
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;

public class ConcurrentDataMining {
    public static void main(String[] args) {
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl("jdbc:mysql://localhost:3306/mydb");
        config.setUsername("root");
        config.setPassword("password");
        config.setMaximumPoolSize(10);
        config.setTransactionIsolation(Connection.TRANSACTION_READ_COMMITTED);

        try (HikariDataSource dataSource = new HikariDataSource(config)) {
            try (Connection conn = dataSource.getConnection()) {
                conn.setAutoCommit(false);
                conn.setTransactionIsolation(Connection.TRANSACTION_REPEATABLE_READ);

                Statement stmt = conn.createStatement();
                stmt.setFetchSize(500);

                ResultSet rs = stmt.executeQuery("SELECT id, score FROM user_scores");
                PreparedStatement updateStmt = conn.prepareStatement(
                    "UPDATE user_scores SET status = ? WHERE id = ?");

                while (rs.next()) {n                int id = rs.getInt("id");
                double score = rs.getDouble("score");
                String status = score > 80 ? "high" : "low";

                updateStmt.setString(1, status);
                updateStmt.setInt(2, id);
                updateStmt.addBatch();
            }

            updateStmt.executeBatch();
            conn.commit();
            System.out.println("Concurrent mining completed.");

        } catch (SQLException e) {
            System.err.println("Rolling back due to error.");
        }
    }
}
该示例使用了 HikariCP 连接池,并设置了最大连接数为 10。在获取连接后,显式设置事务隔离级别为 TRANSACTION_REPEATABLE_READ,以确保在事务期间读取的数据不会被其他事务修改。同样采用分批处理策略,每行数据根据分数判断状态并更新。由于使用了连接池,多个线程可以同时获取连接执行挖掘任务,但每个连接内部仍保持事务隔离。预期输出为 "Concurrent mining completed.",且 user_scores 表中对应记录的 status 字段被更新。若发生异常,事务回滚,数据不变。
基于程序中 fetchSize 参数对内存占用的具体影响
在 JDBC 中,fetchSize 参数直接影响内存占用和处理速度。如果不设置 fetchSize,驱动程序可能默认一次性加载所有结果集到内存,导致 OutOfMemoryError。设置合适的 fetchSize(如 1000 或 500)可以让驱动程序分批次从数据库拉取数据,显著降低内存峰值。例如,在处理百万级数据时,fetchSize=1000 意味着每次只保留 1000 行在内存中,其余数据由数据库服务器缓存。这虽然增加了网络往返次数,但换来了稳定的内存使用和更高的吞吐量。实际测试中,fetchSize 过小会导致频繁的网络交互,过大则可能引发内存压力,需根据数据行大小和网络带宽进行权衡。


















