








java stream api 实现分组统计的核心做法是调用 collectors.groupingby() 结合下游收集器。对于简单的计数,使用 collectors.counting();对于聚合计算(如求和、平均值),则需配合 collectors.summingint() 或 collectors.averagingdouble() 等。这些方法会将流中的元素按指定键分类,并在每个组内执行相应的统计逻辑,最终返回一个 map 对象。
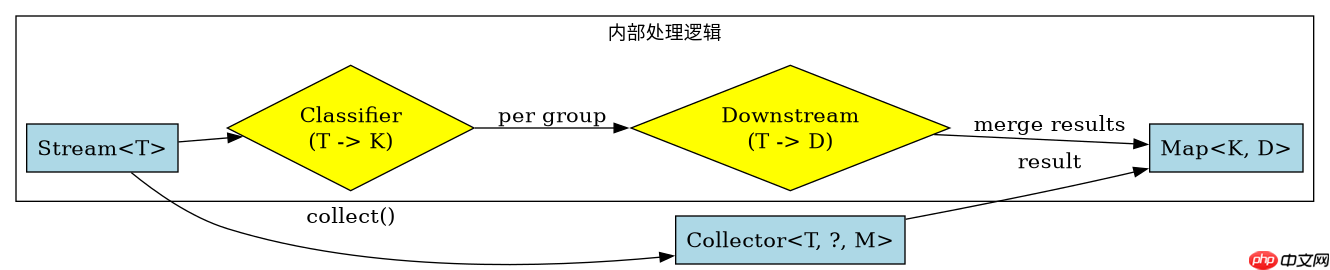
groupingBy() 如何生成基础分组 Map
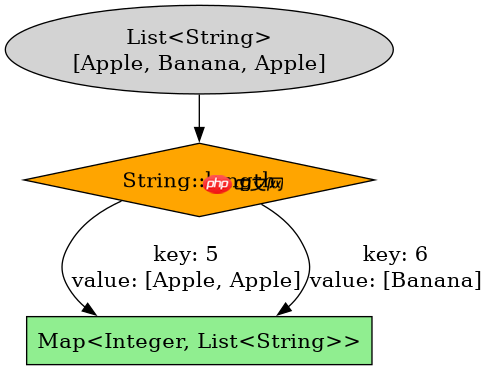
当仅使用 groupingBy() 时,它会将流中所有具有相同键的元素放入同一个列表中,生成的值是 List<t></t>。这是最基础的分组形式,适用于需要保留原始数据以便后续处理的场景。
import java.util.*;
import java.util.stream.Collectors;

public class GroupingDemo {
    public static void main(String[] args) {
        List<String> items = Arrays.asList("Apple", "Banana", "Apple", "Orange", "Banana", "Apple");

        // 基础分组:按字符串长度分组
        Map<Integer, List<String>> grouped = items.stream()
                .collect(Collectors.groupingBy(String::length));

        System.out.println(grouped);
        // 输出: {5=[Apple, Banana, Orange], 6=[Banana]}
    }
}
如何使用下游收集器进行计数与聚合
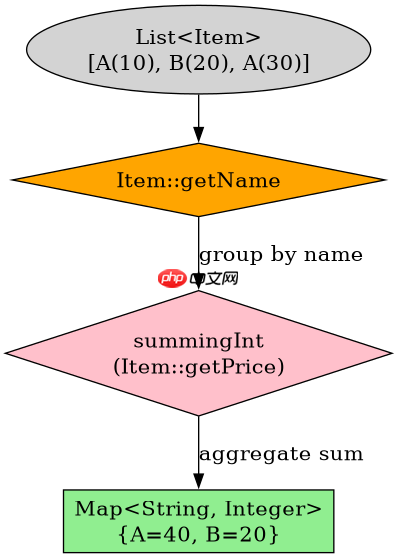
在 groupingBy() 的第二个参数位置传入具体的下游收集器,即可改变值的类型。例如,传入 Collectors.counting() 可将值变为 Long 类型的计数;传入 Collectors.summingInt() 可将值变为 Integer 类型的总和。这种组合能直接得到统计结果,无需二次遍历。

掌握 ES6+ 特性,包括 async/await、解构、扩展运算符、箭头函数、Promise、模块、迭代器、生成器以及函数式编程模式,编写简洁高效的 Java
立即学习“Java免费学习笔记(深入)”;
import java.util.*;
import java.util.stream.Collectors;

class Item {
    String name;
    int price;
    Item(String n, int p) { name = n; price = p; }
}

public class AggregationDemo {
    public static void main(String[] args) {
        List<Item> items = Arrays.asList(
            new Item("A", 10), new Item("B", 20),
            new Item("A", 30), new Item("C", 10)
        );

        // 按名称分组并求和价格
        Map<String, Integer> totalPrices = items.stream()
                .collect(Collectors.groupingBy(
                    Item::getName,
                    Collectors.summingInt(Item::getPrice)
                ));

        System.out.println(totalPrices);
        // 输出: {A=40, B=20, C=10}
    }
}
分组统计中如何处理空值或默认行为
在使用 groupingBy() 时,如果分组键为 null,默认情况下该元素会被归入 key 为 null 的组中。若希望过滤掉 null 键或将其映射到特定键,可以在上游使用 filter() 或在 groupingBy() 中使用自定义的 classifier 函数。此外,toMap() 在处理重复键时会抛出异常,而 groupingBy() 天然支持多对一映射,不会因键冲突报错。
















