








java中大文件读写优化的核心在于避免一次性将文件加载到内存,转而使用缓冲机制配合固定大小的缓冲区进行分块处理。具体做法是结合bufferedinputstream或bufferedreader与底层字节流/字符流,通过循环读取指定长度的数据块并写入输出流,从而控制内存占用在kb级别。这种基于流的管道式处理模式,能够确保在处理gb级大文件时不会引发outofmemoryerror异常。
如何高效实现大文件的复制操作
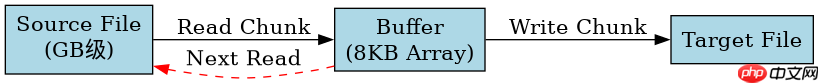
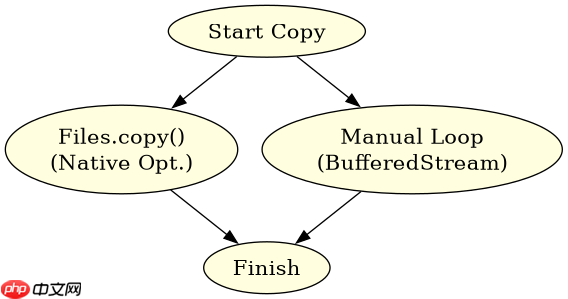
要实现大文件的高效复制,应使用Files.copy()方法并传入StandardCopyOption.REPLACE_EXISTING参数,或者手动构建带有缓冲区的输入输出流对。推荐使用java.nio.file.Files中的工具方法,因为它内部已经针对大文件进行了优化,通常采用零拷贝技术或直接内存映射(取决于JVM和OS支持)。若需自定义逻辑,则创建一个足够大的缓冲区数组(如8KB),在while循环中调用read()直到返回-1,并将每次读取的数据写入目标流。
import java.io.*;
import java.nio.file.*;

public class LargeFileCopier {
    public static void main(String[] args) throws IOException {
        Path source = Paths.get("large_input.txt");
        Path target = Paths.get("large_output.txt");

        // 方式一:使用NIO Files.copy (推荐)
        Files.copy(source, target, StandardCopyOption.REPLACE_EXISTING);

        // 方式二:手动缓冲流处理
        try (InputStream in = new BufferedInputStream(new FileInputStream(source.toFile()));
             OutputStream out = new BufferedOutputStream(new FileOutputStream(target.toFile()))) {
            byte[] buffer = new byte[8192];
            int bytesRead;
            while ((bytesRead = in.read(buffer)) != -1) {
                out.write(buffer, 0, bytesRead);
            }
        }
    }
}
上述代码展示了两种主流的大文件复制方案。第一种利用Files.copy,其内部实现通常比手动循环更高效,因为它可能利用操作系统的直接I/O特性。第二种展示了底层的缓冲读取逻辑,通过byte[] buffer定义8KB的内存块,反复填充并写出,确保内存峰值始终保持在缓冲区大小附近,而非整个文件大小。
立即学习“Java免费学习笔记(深入)”;

如何处理大文件中的特定编码字符
当需要按行或按字符处理大文本文件时,必须指定正确的字符集以避免乱码,并使用BufferedReader包装InputStreamReader。关键在于设置合适的缓冲区大小,因为默认的字符解码器可能需要多个字节才能确定一个字符,较小的缓冲区可能导致频繁的解码开销。同时,应使用try-with-resources语法自动关闭流,防止资源泄漏。对于超大文件,建议逐行处理而非一次性读取所有行到List中,以保持低内存 footprint。

import java.io.*;
import java.nio.charset.StandardCharsets;
import java.nio.file.*;

public class LargeTextProcessor {
    public static void main(String[] args) throws IOException {
        Path file = Paths.get("large_log.txt");

        // 使用BufferedReader处理UTF-8编码的大文本
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(new FileInputStream(file.toFile()), StandardCharsets.UTF_8))) {
            String line;
            long lineCount = 0;
            while ((line = reader.readLine()) != null) {
                // 处理每一行,例如过滤或计数
                if (line.contains("ERROR")) {
                    System.out.println(line);
                }
                lineCount++;
            }
            System.out.println("Total lines: " + lineCount);
        }
    }
}
该示例演示了如何安全地读取大文本文件。InputStreamReader负责将字节流转换为字符流,并指定StandardCharsets.UTF_8保证编码一致性。BufferedReader进一步提供行读取功能,其默认缓冲区为8KB,可根据需求调整构造函数中的大小参数。这种方式避免了将整个文件内容加载到内存字符串中,适合处理无限增长或极大的日志文件。
当缓冲区大小设置为不同值时对性能有何影响
缓冲区的大小直接影响I/O操作的频率和系统调用的开销。较小的缓冲区(如1KB)会导致更多的read和write系统调用,增加CPU上下文切换的负担;而较大的缓冲区(如64KB或更大)可以减少调用次数,但会增加内存占用和GC压力。通常情况下,8KB到16KB是一个兼顾性能和内存的平衡点,具体最优值取决于操作系统页大小和硬件磁盘转速。在实际测试中,过大的缓冲区并不会线性提升速度,反而可能因缓存命中率下降而带来边际效益递减。

















