








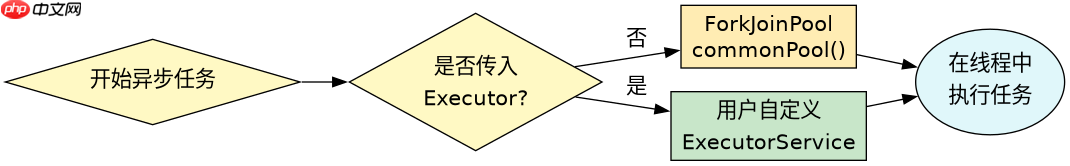
在 java 的 completablefuture 中,指定线程池的核心方法是使用重载版本的异步构建方法,将自定义的 executor 作为参数传入。默认情况下,completablefuture 会使用公共的 forkjoinpool 线程池(即 forkjoinpool.commonpool()),这可能导致任务竞争资源或无法按业务隔离执行。通过显式传入一个配置好的线程池实例,可以精确控制任务的执行环境、线程数量以及异常处理策略。
如何创建并传入自定义线程池进行异步任务提交?
要使用自定义线程池,最直接的方式是在调用 supplyAsync 或 runAsync 时提供第二个参数。这两个方法分别用于有返回值和无返回值的异步操作。开发者需要预先创建一个 ExecutorService 实例,通常推荐使用 Executors.newFixedThreadPool 或 ThreadPoolExecutor 以获得更细粒度的控制,然后将该实例传递给异步方法。这样做后,所有在该上下文中提交的任务都会由指定的线程池调度执行,而不是默认的公共池。
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class Main {
    public static void main(String[] args) {
        // 1. 创建自定义线程池,核心线程数为4
        ExecutorService customPool = Executors.newFixedThreadPool(4);

        // 2. 使用 supplyAsync 并传入线程池
        CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> {
            return "Result from custom pool";
        }, customPool);

        // 3. 获取结果
        try {
            System.out.println(future.get());
        } catch (Exception e) {
            e.printStackTrace();
        } finally {
            // 注意:实际生产中需妥善管理线程池生命周期
            customPool.shutdown();
        }
    }
}
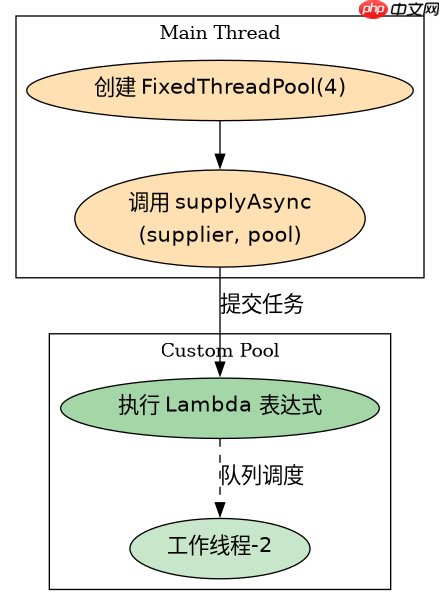
上述代码展示了标准的用法。首先定义了一个包含4个线程的固定大小线程池。接着,在调用 CompletableFuture.supplyAsync 时,第一个参数是 Supplier 函数式接口,第二个参数就是刚才创建的 customPool。当程序运行时,Lambda 表达式中的代码将在 customPool 的某个工作线程上执行。如果省略第二个参数,任务将被提交到 ForkJoinPool.commonPool()。这种机制允许开发者根据任务类型(CPU密集型或IO密集型)配置不同大小的线程池,避免资源争用。
立即学习“Java免费学习笔记(深入)”;

如何在链式调用中保持或使用不同的线程池?
当 CompletableFuture 进行链式调用时,如使用 thenApply、thenAccept 等方法,默认情况下后续任务会在前一个任务的完成线程中执行,或者如果前一个任务是异步完成的,则可能继续由原线程池或公共池调度。为了在链式调用的特定阶段切换线程池,可以使用带有 Executor 参数的版本,例如 thenApplyAsync 或 thenAcceptAsync。这使得开发者可以在流程的不同阶段分配不同的执行资源,比如在前端 IO 操作后切换到 CPU 密集型计算线程池。

import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class ChainExample {
    public static void main(String[] args) {
        ExecutorService ioPool = Executors.newFixedThreadPool(2);
        ExecutorService cpuPool = Executors.newFixedThreadPool(2);

        CompletableFuture<String> step1 = CompletableFuture.supplyAsync(() -> {
            return "Data fetched";
        }, ioPool); // 第一步使用 IO 线程池

        CompletableFuture<String> step2 = step1.thenApplyAsync(data -> {
            return data.toUpperCase(); // 第二步使用 CPU 线程池
        }, cpuPool);

        step2.thenAccept(result -> {
            System.out.println("Final: " + result);
        });

        // 等待完成
        try { step2.get(); } catch (Exception e) {}

        ioPool.shutdown();
        cpuPool.shutdown();
    }
}
在这个例子中,第一步数据获取模拟了 IO 操作,因此使用了较小的 ioPool。随后,通过调用 thenApplyAsync 并传入 cpuPool,将数据处理逻辑切换到了另一个线程池。如果不使用 Async 后缀的方法,thenApply 可能会在当前线程同步执行(如果前一步已完成)或在原异步线程池中执行。使用带 Executor 的 Async 方法确保了明确的线程归属。这种模式对于混合负载非常有用,可以将 IO 等待和 CPU 计算分离到不同的线程池中,提高整体吞吐量。需要注意的是,每个异步步骤都可以独立指定执行器,从而实现复杂的调度策略。
如果未指定线程池,CompletableFuture 默认使用哪个线程?
如果在调用 supplyAsync 或 runAsync 时没有提供 Executor 参数,CompletableFuture 会默认使用 ForkJoinPool.commonPool()。这是一个全局共享的线程池,其大小默认等于机器的可用处理器核心数减一(除非系统属性 java.util.concurrent.ForkJoinPool.common.parallelism 被修改)。这意味着所有未显式指定线程池的异步任务都会竞争这个公共池中的线程资源。
在单节点应用中,如果大量任务都依赖默认池,可能会导致线程饥饿,特别是当这些任务包含阻塞式 IO 操作时,因为公共池的设计初衷是处理非阻塞的 CPU 密集型任务。此外,如果一个任务在公共池中抛出未捕获的异常,它可能会影响其他正在运行的任务。因此,在生产环境中,建议始终为 CompletableFuture 显式指定专用的线程池,以确保隔离性、可控性和可预测的性能表现。通过这种方式,可以避免因默认行为带来的潜在风险,并根据具体业务需求优化资源利用率。



















