








在 linux 中,nginx 的 least_conn 负载均衡策略通过选择当前活跃连接数最少的后端节点来分配请求。当后端节点响应变慢时,该策略会自动将新请求导向其他空闲或负载较低的节点,从而避免单个慢速节点阻塞所有流量。
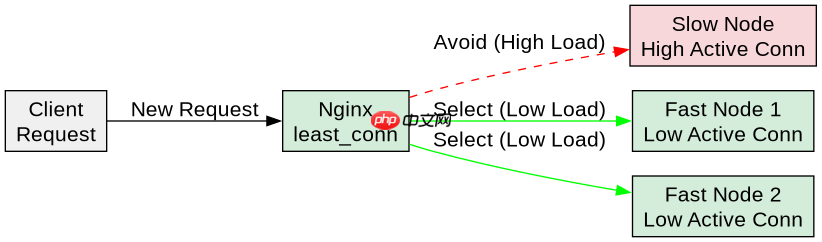
least_conn 如何识别并避开慢速节点
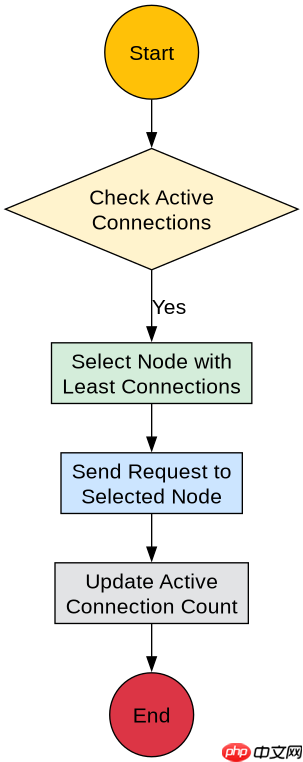
least_conn 算法的核心逻辑是统计每个后端服务器当前的“活跃连接数”(Active Connections)。活跃连接是指从 Nginx 接收客户端请求开始,直到后端服务器完全发送响应数据给 Nginx 为止这段时间内保持的连接。如果某个后端节点处理请求很慢,它的活跃连接数会持续增加,而其他正常节点的连接数保持不变或较低。因此,Nginx 会将新的 incoming 请求分配给那些活跃连接数较少的健康节点,实现自动避让。
upstream backend {
    least_conn;
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    server 192.168.1.12:8080;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
    }
}
在上述配置中,假设 192.168.1.10 因数据库查询缓慢导致响应时间长达 5 秒,而另外两个节点响应时间在 100ms 以内。当并发请求涌入时,192.168.1.10 的活跃连接数会迅速累积至高位,而 192.168.1.11 和 192.168.1.12 的活跃连接数维持在低位。Nginx 的负载均衡器会在每次接收到新请求时,实时比较这三个节点的活跃连接数,并将请求优先发送给连接数最少的那个节点。这种机制确保了即使存在慢速节点,系统整体仍能保持较高的吞吐量和较低的延迟。

结合超时设置优化慢速节点的处理效果
虽然 least_conn 能动态调整流量分布,但如果慢速节点长时间占用连接而不释放,仍可能耗尽资源。因此,必须配合合理的超时参数来限制单个请求的最大等待时间。通过设置 proxy_connect_timeout、proxy_send_timeout 和 proxy_read_timeout,可以确保如果一个节点在指定时间内未能完成响应,Nginx 会主动断开与该节点的连接,并将其标记为暂时不可用(根据 max_fails 和 fail_timeout 设置),从而彻底隔离故障或慢速节点。
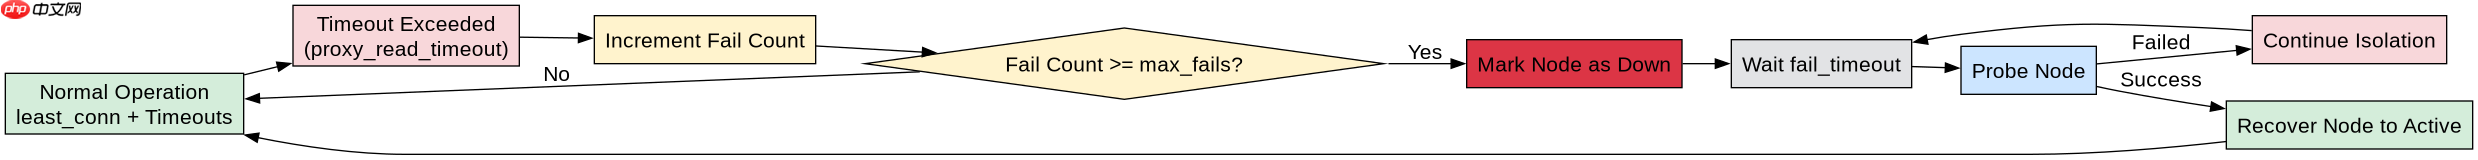
upstream backend {
    least_conn;
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 max_fails=3 fail_timeout=30s;
}

server {
    listen 80;
    location / {
        proxy_pass http://backend;
        proxy_connect_timeout 5s;
        proxy_send_timeout 10s;
        proxy_read_timeout 10s;
    }
}
在上述增强配置中,max_fails=3 表示如果后端节点在 fail_timeout=30s 的时间窗口内连续失败 3 次,Nginx 将在接下来的 30 秒内将该节点从可用列表中移除。同时,proxy_read_timeout 10s 确保如果后端节点在 10 秒内未返回任何数据,Nginx 会终止该请求并尝试下一个节点。这种组合策略不仅利用了 least_conn 的动态负载均衡能力,还通过超时机制防止了慢速节点对系统资源的长期占用,提升了系统的鲁棒性。
慢速节点被隔离后的恢复机制
当慢速节点因超过 max_fails 阈值而被 Nginx 暂时隔离后,其状态会从“active”变为“down”。在 fail_timeout 指定的时间段结束后,Nginx 会尝试向该节点发送一个探测请求。如果探测成功,即节点恢复正常响应速度,Nginx 会将其重新加入负载均衡池,继续参与流量分配。这一自动恢复机制无需人工干预,确保了系统在经历短暂故障或性能波动后能够自我修复,维持服务的连续性。





















