








在 nginx 的 upstream 模块中,`fail_timeout` 参数通过定义一个时间窗口来控制故障转移的判定。它包含两个核心作用:一是统计在该时间段内失败的连接或请求次数;二是当失败次数超过 `max_fails` 设定的阈值时,将该服务器标记为不可用,并在该时间窗口内停止向其转发流量。
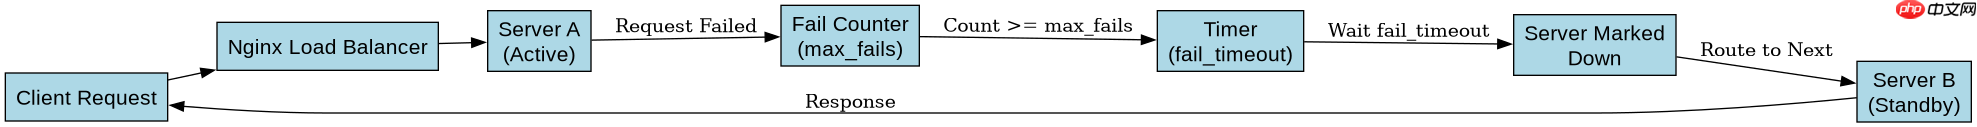
如何配置 fail_timeout 与 max_fails
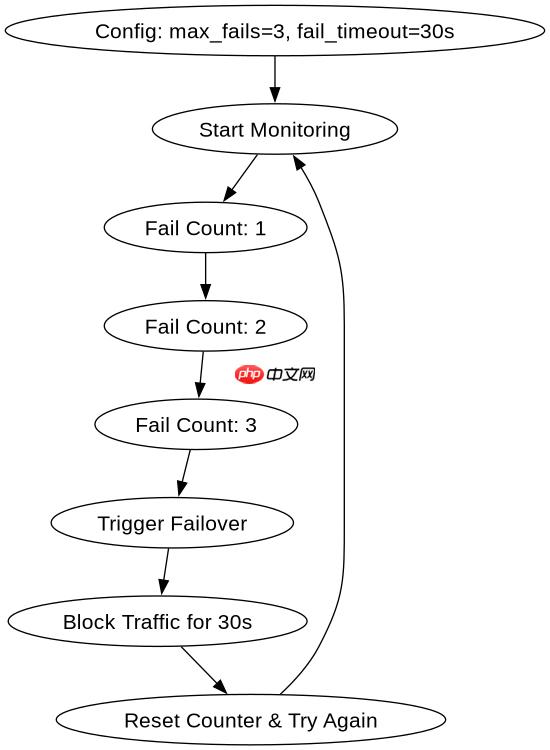
要启用故障转移判定,必须在 upstream 块中同时指定 max_fails 和 fail_timeout。max_fails 定义了在一个 fail_timeout 周期内允许的最大失败次数,而 fail_timeout 则定义了该周期的持续时间(单位为秒)。如果在此时间内失败次数达到上限,Nginx 会将该后端服务器标记为 down,并在下一个 fail_timeout 周期开始时尝试恢复。
upstream backend_pool {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
}
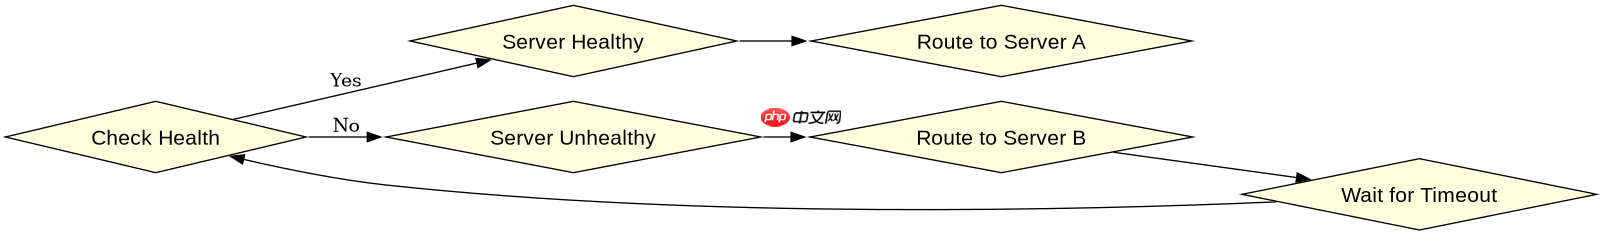
在上述配置中,如果 192.168.1.10 在 30 秒内连续失败 3 次,Nginx 将认为该服务器暂时不可用,接下来的 30 秒内所有新请求都会跳过该节点,直接转发给 192.168.1.11。30 秒后,Nginx 会发送一个探测请求(如果配置了健康检查)或等待下一个实际请求来验证该服务器是否恢复。
fail_timeout 对负载均衡策略的影响
当某个服务器因触发 fail_timeout 被标记为不可用时,Nginx 的负载均衡算法会自动忽略该节点。对于 round_robin(轮询)策略,请求会在剩余的健康服务器间均匀分配;对于 least_conn(最少连接)策略,Nginx 会选择当前活跃连接数最少的健康服务器。这种机制确保了在部分节点故障时,流量能够自动转移到正常运行的节点上,从而维持服务的可用性。

# 模拟客户端请求序列
# 假设后端 A 和 B 初始状态正常
# 请求 1 -> 后端 A (成功)
# 请求 2 -> 后端 B (成功)
# 请求 3 -> 后端 A (失败, 计数 1/3)
# 请求 4 -> 后端 B (成功)
# 请求 5 -> 后端 A (失败, 计数 2/3)
# 请求 6 -> 后端 B (成功)
# 请求 7 -> 后端 A (失败, 计数 3/3) -> 触发 fail_timeout, A 标记为 down
# 请求 8 -> 后端 B (成功, A 被跳过)
# ... 后续 30 秒内的请求均只发给 B
在这个示例中,第 7 个请求导致后端 A 的失败计数达到阈值,触发了故障转移。在接下来的 30 秒内,即使有并发请求,Nginx 也会确保这些请求不会发送到后端 A,直到计时器重置。这种基于时间窗口的判定方式避免了因瞬时网络抖动导致的频繁切换,提高了系统的稳定性。
基于特定输入条件下的故障转移行为
当后端服务器返回 HTTP 5xx 错误时,Nginx 默认将其视为一次失败,计入 max_fails 的统计中。这意味着如果后端应用逻辑出错并返回 500 状态码,Nginx 会认为该服务器故障并触发故障转移。这种行为可以通过 proxy_next_upstream 指令进行精细控制,例如仅在某些特定的错误类型或响应码下才触发故障转移。
upstream backend_pool {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    proxy_next_upstream error timeout http_500;
}
在上述配置中,只有当发生连接错误、超时或后端返回 500 错误时,才会增加失败计数。如果后端返回 502 或 503,且未在这些指令中明确列出,则可能不会被计入失败次数,具体取决于 Nginx 版本和默认行为。这种细粒度的控制允许管理员根据应用的具体错误处理逻辑来调整故障转移的敏感度,避免不必要的流量切换。
















