








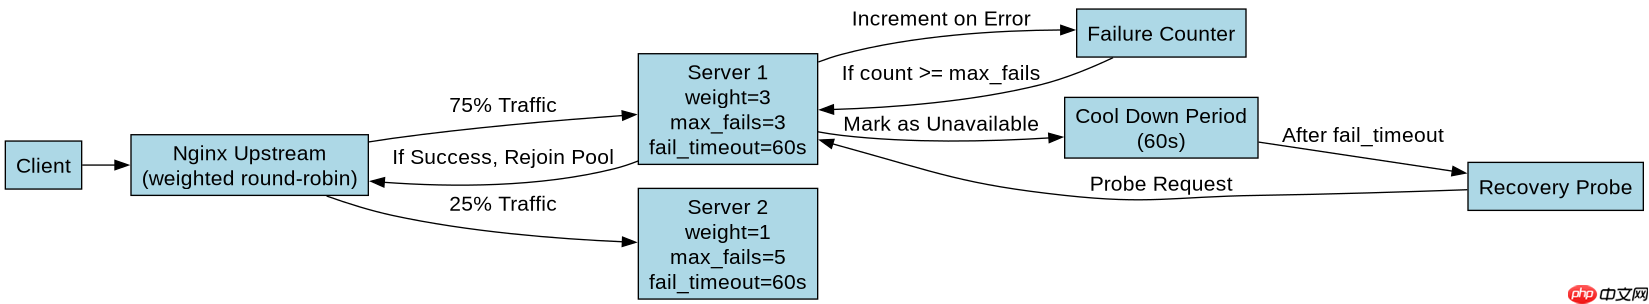
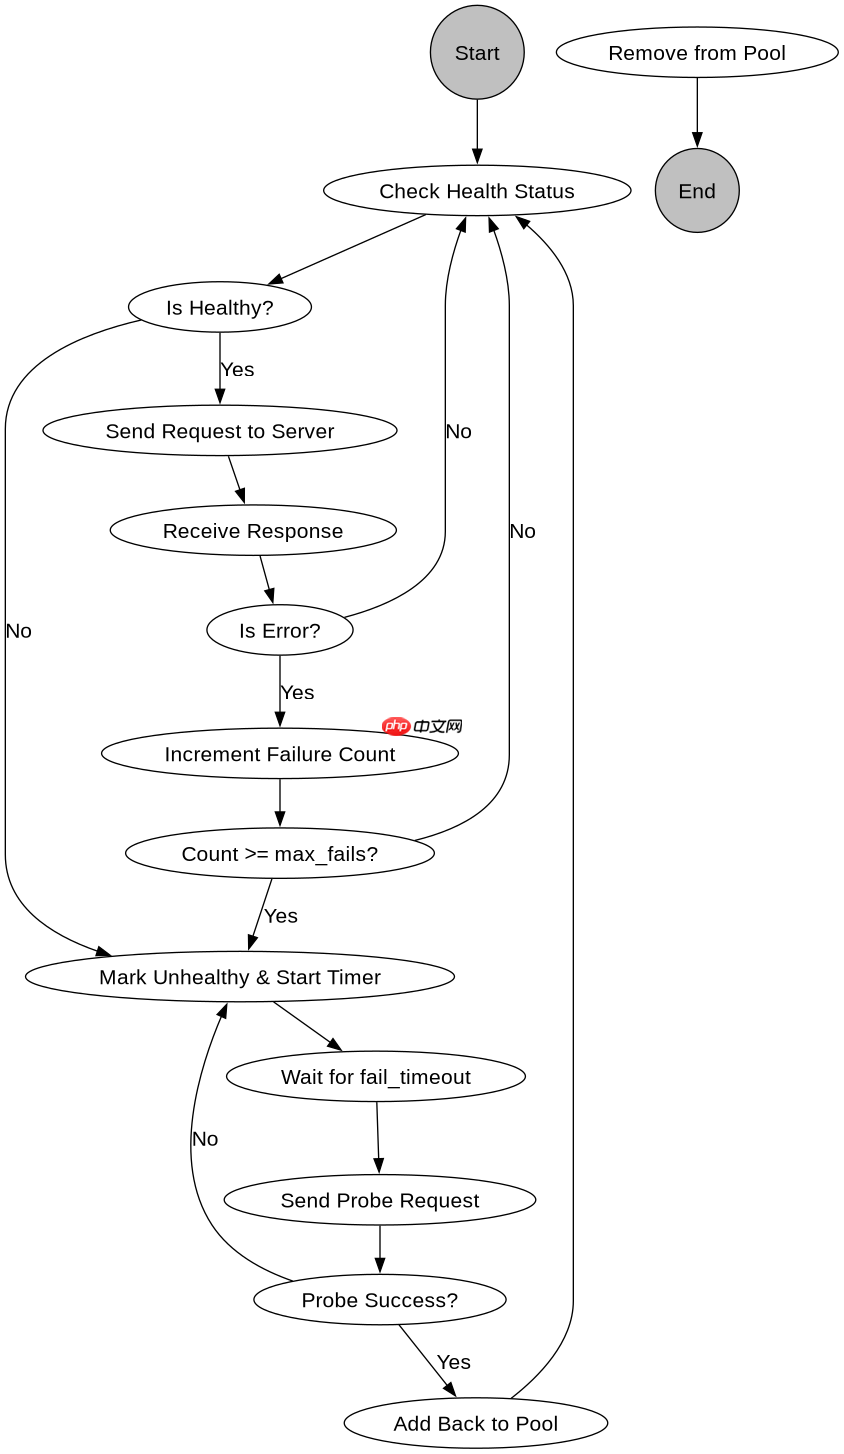
在 nginx 的 upstream 模块中,加权轮询结合 max_fails 和 fail_timeout 使用,可以实现自动剔除故障节点并在恢复后重新加入流量池。具体做法是在 upstream 块内为每个 server 指定权重、最大失败次数及超时时间,nginx 会在指定时间内连续失败超过设定值时标记该节点为不可用,等待超时时间结束后再尝试探测。
如何配置 server 的权重与失败检测参数
配置方法是在 upstream 块的 server 指令中追加 weight、max_fails 和 fail_timeout 三个参数。例如设置主节点权重为 3,备用节点权重为 1,且当主节点在 10 秒内失败 3 次时将其暂时下线。这样配置后,Nginx 会根据权重分配请求,同时实时监控后端健康状态。
upstream backend {
    # 主节点:权重3,10秒内失败3次则暂停服务60秒
    server 192.168.1.10:8080 weight=3 max_fails=3 fail_timeout=60s;

    # 备用节点:权重1,10秒内失败5次则暂停服务60秒
    server 192.168.1.11:8080 weight=1 max_fails=5 fail_timeout=60s;
}
上述配置中,weight=3 表示主节点接收的请求量是备用节点的三倍。max_fails=3 定义了失败阈值,fail_timeout=60s 定义了两个统计周期:max_fails 的计数窗口和节点被标记为不可用后的冷却时间。当主节点连续返回错误(如 502、504 或连接超时)达到 3 次时,Nginx 会在接下来的 60 秒内不再向其发送请求,转而将流量全部分配给备用节点。60 秒后,Nginx 会向主节点发送一个探测请求,如果成功则重新将其纳入轮询池。

不同权重下失败检测对流量分配的影响
当高权重节点触发 max_fails 机制被剔除后,剩余低权重节点将承担全部流量,此时负载压力会显著增加。若所有节点均触发失败检测,Nginx 将根据 least_conn 或其他算法决定最终行为,默认情况下可能返回 502 Bad Gateway。在实际应用中,需确保备用节点具备足够的处理能力以应对突发流量。

# 模拟高权重节点故障后的流量重分布
# 假设初始状态:主节点(3) + 备用节点(1) = 4份流量
# 主节点触发 max_fails 后被剔除
# 新状态:仅备用节点(1) 接收所有流量

location / {
    proxy_pass http://backend;
    proxy_next_upstream error timeout invalid_header http_500 http_502 http_503;
}
在上述场景中,proxy_next_upstream 指令进一步增强了容错能力。当主节点被剔除后,即使备用节点也出现短暂波动,Nginx 也会尝试下一个可用节点(如果有更多节点)。但在此例中仅剩一个备用节点,因此其稳定性至关重要。建议在生产环境中至少部署两个以上节点,并合理设置 max_fails 以避免因网络抖动导致频繁切换。
基于 fail_timeout 期间节点状态的验证问题
在 fail_timeout 规定的冷却期内,被标记为不可用的节点不会接收任何新请求,即使它已经恢复正常。这是为了确保系统稳定性,避免“惊群效应”或反复尝试连接已知的故障源。开发者可通过查看 Nginx 错误日志确认节点状态变化,或使用 nginx -T 检查当前配置生效情况。


















