








dataoutputstream 的 writeutf() 方法用于将字符串以修改过的 utf-8 格式写入底层输出流,它会在数据前自动附加一个表示字符串长度的无符号短整型(2字节),读取时必须使用对应的 datainputstream.readutf()。调用时只需传入目标字符串即可,该方法会自动处理编码转换和长度标记,确保二进制数据的完整性。
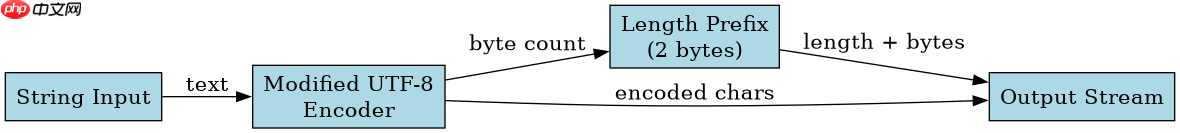
writeUTF() 写入的具体字节结构是什么
该方法写入的数据由两部分组成:前两个字节是字符串的长度(按修改后的 UTF-8 字节数计算),后续字节是实际的编码内容。这种格式不同于标准 UTF-8,它使用 1 到 3 个字节来表示字符,且空字符串长度为 0。在 Java 中,这被称为 Modified UTF-8,主要为了区分空字符和文件结束符。
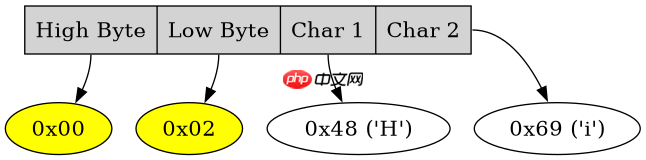
import java.io.*;

public class WriteUtfDemo {
    public static void main(String[] args) throws Exception {
        // 创建内存输出流用于演示
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        DataOutputStream dos = new DataOutputStream(baos);

        String text = "Hi";
        dos.writeUTF(text);
        dos.flush();

        // 查看原始字节
        byte[] bytes = baos.toByteArray();
        System.out.println("Length: " + bytes.length);
        for (byte b : bytes) {
            System.out.printf("%02X ", b);
        }
        // 预期输出:
        // Length: 4
        // 00 02 48 69
    }
}
为什么必须搭配 DataInputStream 读取
由于 writeUTF() 添加了长度前缀,如果使用普通的 FileInputStream 或 BufferedReader 读取,无法正确解析出字符串的实际边界,会导致乱码或截断。只有 DataInputStream 的 readUTF() 方法知道如何先读取 2 字节长度,再读取对应数量的字节并解码为字符串。

立即学习“Java免费学习笔记(深入)”;

import java.io.*;

public class ReadUtfDemo {
    public static void main(String[] args) throws Exception {
        // 模拟之前写入的数据
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        DataOutputStream dos = new DataOutputStream(baos);
        dos.writeUTF("Test");
        byte[] data = baos.toByteArray();

        // 使用 DataInputStream 读取
        ByteArrayInputStream bais = new ByteArrayInputStream(data);
        DataInputStream dis = new DataInputStream(bais);

        String result = dis.readUTF();
        System.out.println(result); // 输出: Test
    }
}
当字符串包含空字符时会发生什么
Modified UTF-8 对空字符(\u0000)有特殊处理,它会将其编码为两个字节 0xC0 0x80,而不是单个字节 0x00。这是为了避免与字符串结束符混淆,因为标准 UTF-8 中空字符就是 0x00。如果直接写入普通 UTF-8 编码器,可能会破坏这种长度检测机制。


















