








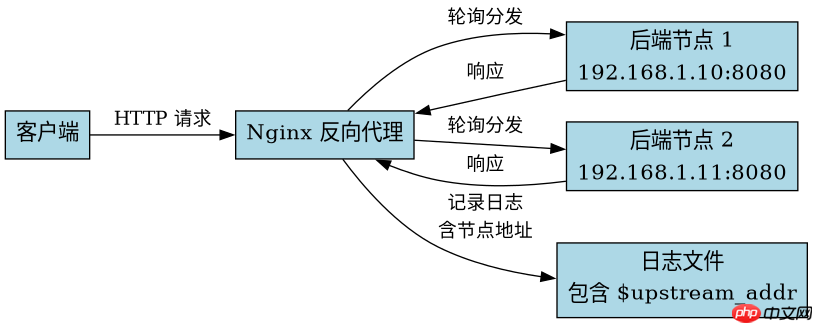
nginx 的轮询策略本身不直接记录每个节点的日志,而是通过 upstream 模块将请求转发给后端节点,由 nginx 的主日志配置统一记录。要实现区分每个节点的访问日志,需要在 upstream 块中定义后端服务器,并在 log_format 中使用变量 $upstream_addr 来标识实际处理请求的后端 ip 和端口。这样,每次请求的日志中都会包含目标节点信息,从而可以按节点筛选和分析。
如何配置 log_format 以包含上游地址
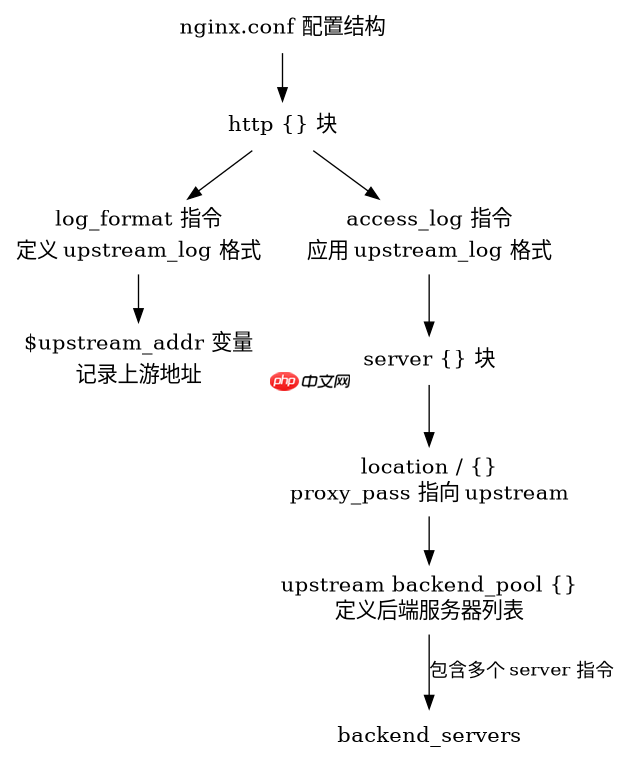
在 nginx.conf 的全局或 http 块中,使用 log_format 指令添加 $upstream_addr 变量。该变量会在请求被转发到后端后填充,记录实际连接的服务器地址。如果使用了多个后端,这个字段会显示最终响应的那个节点地址。结合 access_log 指令应用新的格式,即可生成带有节点信息的日志文件。
log_format upstream_log '$remote_addr - $remote_user [$time_local] '
                        '"$request" $status $body_bytes_sent '
                        '"$http_referer" "$http_user_agent" '
                        'upstream: $upstream_addr';

server {
    listen 80;
    server_name example.com;

    access_log /var/log/nginx/upstream_access.log upstream_log;

    location / {
        proxy_pass http://backend_pool;
    }
}

upstream backend_pool {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
}
上述配置中,log_format 定义了名为 upstream_log 的格式,其中 $upstream_addr 是关键。当请求到达时,Nginx 会根据轮询算法选择 backend_pool 中的一个节点。日志文件中每一行都会显示类似 upstream: 192.168.1.10:8080 的内容,明确指出了处理该请求的后端。如果请求失败或重定向到其他节点,该字段也会反映最终连接的情况。通过这种方式,运维人员可以使用 grep 或日志分析工具按节点 IP 过滤日志,排查特定后端的问题。

轮询策略下各节点日志记录的差异与验证
在默认的轮询(round-robin)策略下,Nginx 会依次将请求分发给 upstream 中定义的各个节点。由于日志是在请求完成后写入的,且 $upstream_addr 记录了实际通信的地址,因此每个节点的日志条目是均匀分布的(假设请求量足够大)。可以通过发送大量请求并检查日志文件来验证这一点。例如,使用 wget 或 curl 循环访问服务,然后统计不同 IP 出现的次数。

# 模拟请求脚本示例
for i in {1..10}; do
    curl -s http://example.com/
done

# 查看日志中各节点的出现频率
grep -oP 'upstream: \K[0-9.]+' /var/log/nginx/upstream_access.log | sort | uniq -c
运行上述命令后,日志文件中应该能看到两个 IP 地址交替出现,且计数大致相等。这证明了轮询策略生效,且日志正确记录了每个请求的目标节点。如果某个节点负载过高或过低,可以调整 weight 参数来改变分配比例,此时日志中的分布也会相应变化。需要注意的是,如果后端节点返回错误,$upstream_addr 仍然会记录尝试连接的地址,即使请求最终可能重试了其他节点。因此,结合 $status 变量可以更准确地分析每个节点的健康状况和错误率。
基于 upstream_addr 变量的具体问题分析
在实际应用中,有时会发现 $upstream_addr 为空或显示为 -。这通常发生在请求未成功转发到任何后端节点时,例如 Nginx 自身配置错误或后端全部宕机。在这种情况下,日志中无法区分是哪个节点出了问题,因为根本没有建立连接。要解决此问题,需确保 upstream 块中的服务器地址正确,且网络可达。另外,如果使用了健康检查模块,Nginx 会自动剔除故障节点,此时 $upstream_addr 只会记录健康节点的信息,从而避免记录无效的连接尝试。




















