








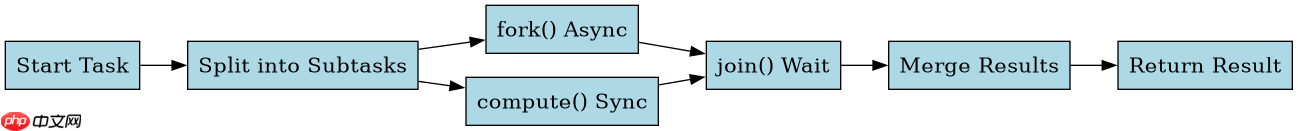
在 java 中,使用 forkjointask 的核心方式是继承其子类 recursivetask<v></v>(有返回值)或 recursiveaction(无返回值),并重写 compute() 方法。具体做法是将大任务拆分为小任务,通过调用 fork() 异步执行子任务,再调用 join() 等待结果并合并。这种模式基于工作窃取算法,能高效利用多核 cpu 处理递归或分治类问题。
ForkJoinPool 如何提交和获取 RecursiveTask 的结果
要提交一个 RecursiveTask 并获取结果,需要实例化自定义的任务类,然后将其提交给 ForkJoinPool 的 invoke() 方法。invoke() 是同步阻塞调用,它会直接返回任务的最终计算结果。如果任务在执行过程中抛出异常,invoke() 会将异常包装为 CompletionException 抛出。关键在于确保任务类的泛型类型与期望的返回值类型一致,这样 invoke() 才能正确返回该类型的对象。

import java.util.concurrent.ForkJoinPool;\nimport java.util.concurrent.RecursiveTask;\n\npublic class SumTask extends RecursiveTask<Long> {\n private static final int THRESHOLD = 10000;\n private long[] array;\n private int start;\n private int end;\n\n public SumTask(long[] array, int start, int end) {\n this.array = array;\n this.start = start;\n this.end = end;\n }\n\n @Override\n protected Long compute() {\n if (end - start <= THRESHOLD) {\n long sum = 0;\n for (int i = start; i < end; i++) {\n sum += array[i];\n }\n return sum;\n } else {\n int mid = (start + end) / 2;\n SumTask leftTask = new SumTask(array, start, mid);\n SumTask rightTask = new SumTask(array, mid, end);\n leftTask.fork();\n long rightResult = rightTask.compute();\n long leftResult = leftTask.join();\n return leftResult + rightResult;\n }\n }\n\n public static void main(String[] args) {\n long[] data = new long[100000];\n for (int i = 0; i < data.length; i++) {\n data[i] = i;\n }\n ForkJoinPool pool = ForkJoinPool.commonPool();\n SumTask task = new SumTask(data, 0, data.length);\n Long result = pool.invoke(task);\n System.out.println("Total: " + result);\n }\n}
RecursiveAction 与 RecursiveTask 在处理无返回值任务时的区别
当任务不需要返回计算结果时,应使用 RecursiveAction 而不是 RecursiveTask<void></void>。RecursiveAction 的 compute() 方法返回类型为 void,适用于执行副作用操作,如修改共享状态、写入文件或并行遍历集合。虽然 RecursiveTask<void></void> 也能实现类似功能,但 RecursiveAction 语义更清晰,且避免了不必要的装箱开销。在实际使用中,两者都遵循相同的 fork-join 拆分逻辑,只是最终结果的聚合方式不同:前者忽略返回值,后者需处理 Void 类型。

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
立即学习“Java免费学习笔记(深入)”;

import java.util.concurrent.ForkJoinPool;\nimport java.util.concurrent.RecursiveAction;\nimport java.util.List;\nimport java.util.ArrayList;\n\npublic class ProcessListAction extends RecursiveAction {\n private static final int THRESHOLD = 1000;\n private List<String> dataList;\n private int start;\n private int end;\n\n public ProcessListAction(List<String> dataList, int start, int end) {\n this.dataList = dataList;\n this.start = start;\n this.end = end;\n }\n\n @Override\n protected void compute() {\n if (end - start <= THRESHOLD) {\n for (int i = start; i < end; i++) {\n String item = dataList.get(i);\n // 模拟处理逻辑\n processItem(item);\n }\n } else {\n int mid = (start + end) / 2;\n ProcessListAction leftAction = new ProcessListAction(dataList, start, mid);\n ProcessListAction rightAction = new ProcessListAction(dataList, mid, end);\n leftAction.fork();\n rightAction.compute();\n leftAction.join();\n }\n }\n\n private void processItem(String item) {\n // 实际业务逻辑\n }\n\n public static void main(String[] args) {\n List<String> data = new ArrayList<>();\n for (int i = 0; i < 100000; i++) {\n data.add("Item-" + i);\n }\n ForkJoinPool pool = ForkJoinPool.commonPool();\n ProcessListAction action = new ProcessListAction(data, 0, data.size());\n pool.invoke(action);\n System.out.println("Processing completed.");\n }\n}当子任务数量超过阈值时 ForkJoinPool 的行为表现
当子任务数量超过阈值时,ForkJoinPool 不会无限创建新线程,而是依赖内部的工作窃取队列和线程池大小进行调度。每个工作线程维护一个双端队列,当线程空闲时会从其他繁忙线程的队列尾部窃取任务。如果所有线程都在忙碌且队列积压严重,新任务可能会被拒绝或延迟执行,具体取决于 ForkJoinPool 的配置。默认情况下,ForkJoinPool.commonPool() 的并行级别等于可用处理器核心数减一,这确保了系统不会因为过多线程上下文切换而性能下降。开发者可以通过设置 JVM 参数 -Djava.util.concurrent.ForkJoinPool.common.parallelism=N 来调整并行度,以适应特定硬件环境。



















