








JDBC 处理大数据量查询的核心策略是什么
使用 statement 或 preparedstatement 时设置 fetchsize 为特定值(如 integer.min_value)以启用流式读取,避免一次性将结果集加载到内存中导致 oom。这种做法会让 jdbc 驱动在遍历 resultset 时按需从数据库拉取数据,从而保持内存占用恒定。
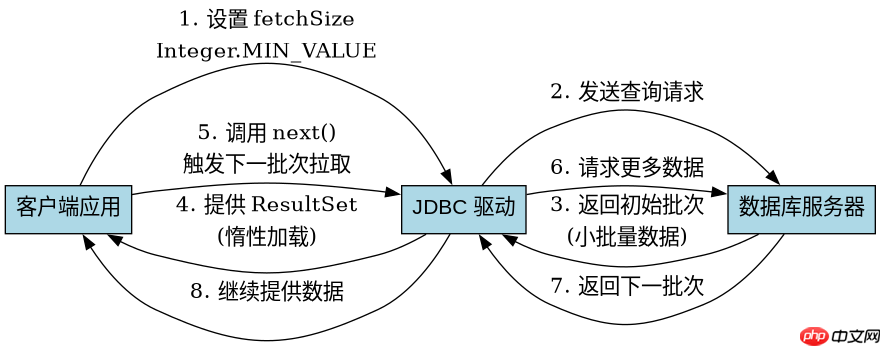
不同数据库驱动的 fetchSize 行为有何差异
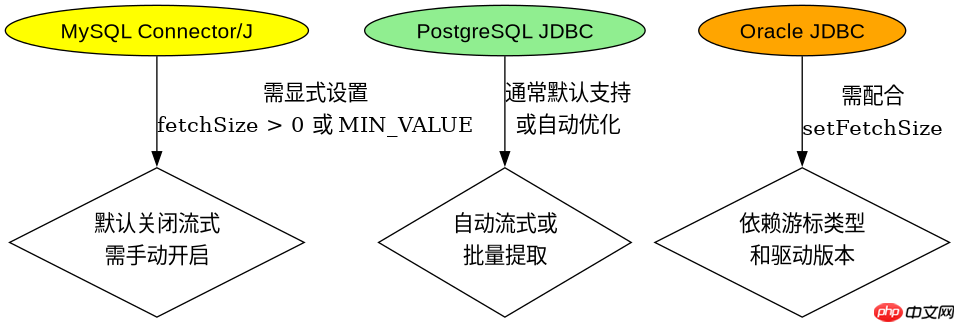
MySQL Connector/J 默认关闭流式模式,必须显式设置 fetchSize 才能生效;而 PostgreSQL 和 Oracle 的驱动对 fetchSize 的支持逻辑不同,PostgreSQL 通常默认支持流式或自动调整,Oracle 则可能需要配合 setFetchSize 和游标类型。理解这些差异能防止在切换数据库时出现性能回退或内存溢出。

javascript-typescript-typescript-scaffold
下载
你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
import java.sql.*;

public class LargeDataQuery {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/testdb";
        String user = "root";
        String password = "password";

        // MySQL 示例:使用 Integer.MIN_VALUE 触发流式读取
        try (Connection conn = DriverManager.getConnection(url, user, password);
             Statement stmt = conn.createStatement(ResultSet.TYPE_FORWARD_ONLY, ResultSet.CONCUR_READ_ONLY)) {

            stmt.setFetchSize(Integer.MIN_VALUE);
            String sql = "SELECT id, name, data FROM large_table";

            try (ResultSet rs = stmt.executeQuery(sql)) {
                while (rs.next()) {
                    // 处理每一行数据
                    int id = rs.getInt("id");
                    String name = rs.getString("name");
                    // 注意:大字段可能需要在循环内单独获取或确保连接未关闭
                    System.out.println(id + ": " + name);
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
基于程序中某个输入、条件或结果的具体问题
当使用流式读取时,如果 ResultSet 中包含 BLOB 或 CLOB 等大字段,且未在遍历过程中立即读取,可能会导致连接长时间持有资源或内存泄漏。因此,必须在 while(rs.next()) 循环内部完成所有字段的读取和处理,确保在处理完当前行后释放相关资源引用。
立即学习“Java免费学习笔记(深入)”;



















