








使用 fetch api 实现请求数据增量更新的核心做法是:在发起网络请求前,先通过 localstorage 或内存变量读取已缓存的数据;请求成功后,将返回的新数据与旧数据进行合并(通常以唯一 id 为键进行覆盖或追加);最后将合并后的完整数据集写回存储并触发视图更新。这样做可以避免全量刷新导致的闪烁和性能损耗,同时保证数据的实时性。

如何设计基于 ID 的增量合并逻辑
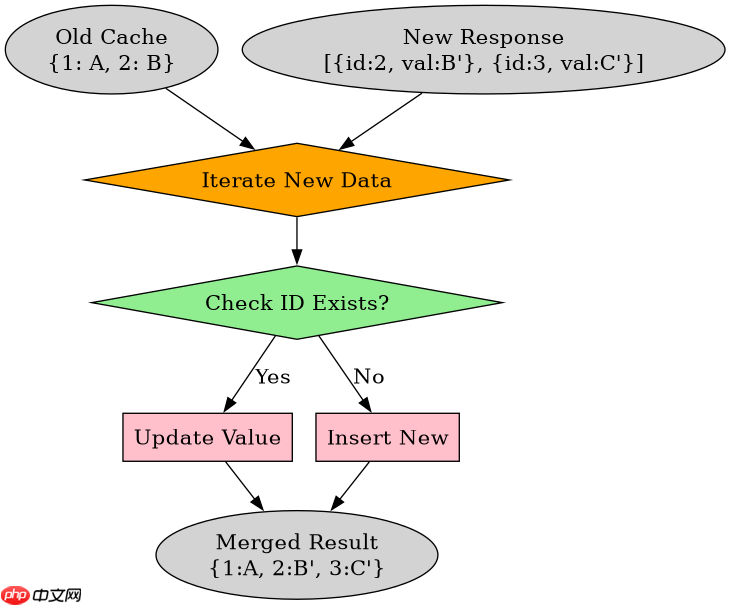
增量更新的关键在于确定哪些数据是“新”的,哪些是“旧”的。最稳健的做法是使用对象映射(Object Map),以数据的唯一标识符(如 id)作为键。当后端返回一组新数据时,遍历这组数据,将其逐个插入到当前缓存的对象中。如果键已存在,则用新值覆盖旧值;如果键不存在,则新增该条目。这种策略天然支持新增、修改和删除(若后端配合返回标记)的场景,且时间复杂度为 O(N),远优于数组的线性查找替换。
// 假设 cacheData 是当前存储的 { id: item } 格式对象
// newData 是 fetch 返回的 [{ id, ... }] 数组
function mergeIncremental(cacheData, newData) {
    const merged = { ...cacheData };
    newData.forEach(item => {
        // 如果 item.id 存在,则覆盖;不存在则新增
        merged[item.id] = item;
    });
    return merged;
}
上述代码展示了核心的合并逻辑。在实际应用中,你需要确保 newData 中的每个对象都包含唯一的 id 字段。如果后端返回的是数组而非对象列表,你需要先将其转换为键值对形式,或者在合并后重新序列化为数组供 UI 渲染使用。这种基于 ID 的合并方式能有效处理数据冲突,避免重复项产生。
立即学习“Java免费学习笔记(深入)”;

你是 TypeScript 项目架构专家,专注于脚手架搭建生产就绪的 Node.js 和前端应用。生成包含现代工具链(pnpm、Vite、Next.js)、类型
如何处理并发请求导致的数据竞争
在快速滚动或频繁触发的场景中,可能会同时发出多个请求。如果直接按顺序合并,后发出的慢请求可能会覆盖先发出的快请求的结果,导致数据错乱。解决这个问题的标准做法是为每次请求分配一个唯一的版本号或时间戳,并在合并前检查当前缓存的版本是否高于请求返回的版本。只有当请求版本 >= 缓存版本时,才执行合并操作。这样可以确保最新的数据始终被应用,而陈旧的数据被忽略。

let currentVersion = 0;

async function fetchDataWithConcurrencyControl() {
    const requestVersion = ++currentVersion;
    try {
        const response = await fetch('/api/data');
        const newData = await response.json();

        // 关键检查:如果当前版本已更新,说明有更新的请求已完成
        if (requestVersion === currentVersion) {
            const mergedData = mergeIncremental(localStorageCache, newData);
            localStorage.setItem('data', JSON.stringify(mergedData));
            updateUI(mergedData);
        } else {
            console.log('Stale request ignored');
        }
    } catch (error) {
        console.error('Fetch failed', error);
    }
}
这段代码演示了如何通过 currentVersion 计数器来防止竞态条件。每次调用 fetchDataWithConcurrencyControl 时,计数器递增,并将当前的计数值绑定到本次异步操作中。当异步回调执行时,它首先检查自己的版本号是否与全局最新版本一致。如果不一致,说明在此期间有新的请求已经完成并更新了状态,因此当前请求的结果被视为过时,直接丢弃。这种方法简单有效,无需引入复杂的锁机制或 Promise 队列。
基于 localStorage 持久化时的具体序列化问题
在使用 localStorage 进行增量更新时,必须注意其只支持字符串存储的特性。每次合并后,都需要将新的对象结构通过 JSON.stringify() 序列化并存入存储;每次读取时,则需要通过 JSON.parse() 反序列化。如果在合并过程中遗漏了序列化步骤,或者在读取后未正确解析为对象,会导致后续合并逻辑失败,例如将字符串当作对象处理引发类型错误。此外,对于大型数据集,频繁的序列化/反序列化可能带来性能瓶颈,此时应考虑使用 IndexedDB 或内存缓存替代。


















