








拦截cve-2026-109618的关键在于识别并阻断包含特定multipart边界字符串的http请求。该漏洞利用特定的边界标识符进行注入或越权操作,因此通过waf规则或应用层代码匹配边界值b7kqpoc618即可有效防御。

如何检测并拦截包含特定边界的恶意请求
拦截的核心是提取HTTP请求体中的Content-Type头以定位边界字符串,然后检查该字符串是否与已知的攻击特征B7kQpoc618完全匹配。一旦检测到该字符串出现在multipart数据中,应立即拒绝请求或触发告警。这种方法直接针对漏洞利用的特征,无需解析整个文件结构即可实现高效拦截。
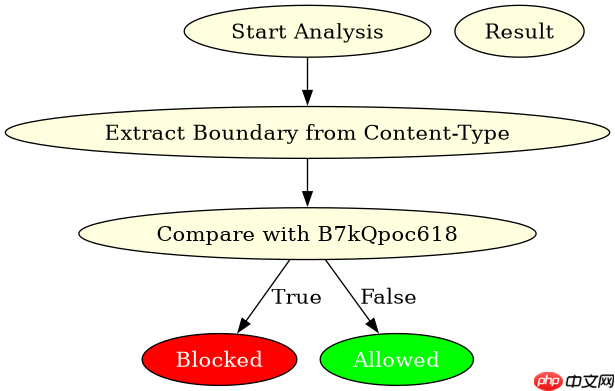
import re

def check_multipart_boundary(content_type, body):
    # 提取boundary参数
    match = re.search(r'boundary=(.*)', content_type)
    if not match:
        return False
    boundary = match.group(1).strip()

    # 检查是否为已知恶意边界
    if boundary == 'B7kQpoc618':
        return True
    return False

# 模拟请求
content_type = 'multipart/form-data; boundary=B7kQpoc618'
body = '--B7kQpoc618
...malicious content...
--B7kQpoc618--'

if check_multipart_boundary(content_type, body):
    print("Blocked: Malicious boundary detected")
else:
    print("Allowed")
为什么自定义边界字符串能绕过常规校验
常规的文件上传校验通常只关注文件扩展名或MIME类型,而忽略了multipart协议中动态生成的边界字符串。攻击者通过设置非标准的边界值如B7kQpoc618,可以构造出符合multipart格式但内容异常的请求。这种边界值在正常业务场景中极少出现,因此将其作为黑名单特征可以有效区分正常流量与攻击流量。
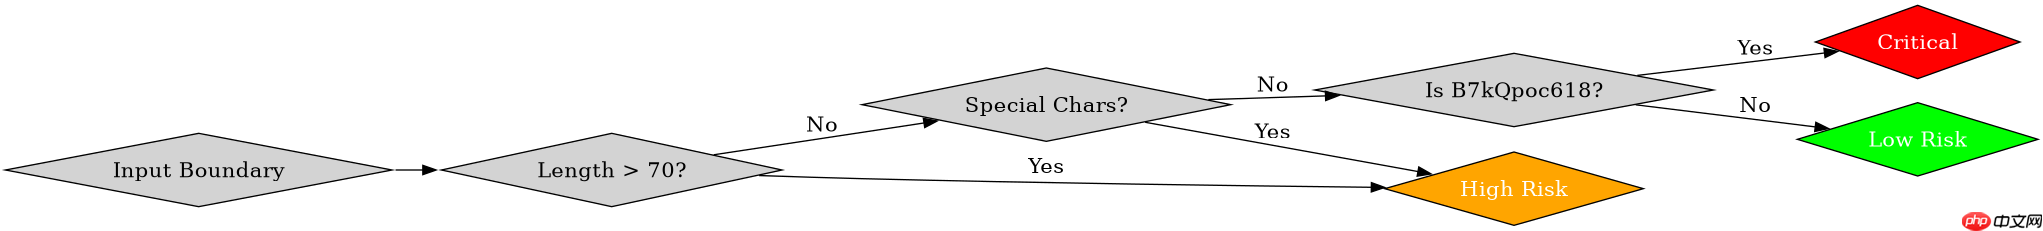
def analyze_boundary_risk(boundary):
    # 检查边界是否包含特殊字符或过长
    if len(boundary) > 70:
        return "High Risk: Boundary too long"
    if re.search(r'[<>"\]', boundary):
        return "High Risk: Special characters found"
    if boundary == 'B7kQpoc618':
        return "Critical: Known CVE boundary"
    return "Low Risk"

print(analyze_boundary_risk('B7kQpoc618'))
基于程序中某个输入、条件或结果的具体问题
当程序接收到包含边界B7kQpoc618的请求时,如果未进行严格过滤,可能会导致后续的文件处理逻辑被误导。例如,某些框架可能根据边界字符串来分割数据块,若该字符串被用于生成临时文件名或路径,可能会引发路径遍历或覆盖风险。因此,必须在解析前对边界字符串进行白名单校验或强制替换为随机生成的安全边界。

















