








php 8.4 新增的 mb_ucfirst 函数用于将字符串首字符转为大写,其核心优势在于支持多字节编码(如 utf-8),能正确处理中文、emoji 等非 ascii 字符的首字母转换,而传统的 ucfirst 仅基于单字节操作,对多字节字符会截断乱码或无效。使用 mb_ucfirst 时只需传入目标字符串和可选的编码参数(默认 utf-8),它会返回转换后的新字符串;若输入为空或非字符串类型,则按 php 常规类型转换处理。关键区别在于:ucfirst 在遇到多字节字符(如 "你好")时,可能只转换第一个字节导致乱码,而 mb_ucfirst 能识别完整字符边界,确保 "你好" 仍为 "你好"(首字不变因已大写或无大小写概念),但像 "hello" 会变成 "hello"。
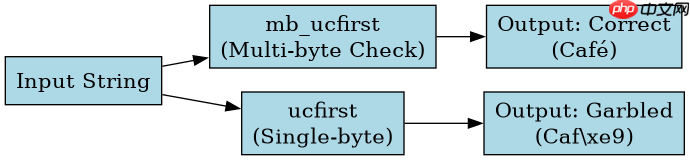
mb_ucfirst 如何处理多字节字符与 ucfirst 的单字节缺陷
mb_ucfirst 通过检测字符边界来安全转换首字符,避免 ucfirst 在多字节场景下的数据损坏。例如,对于输入 "café",ucfirst 可能输出 "Caf\xe9"(乱码),而 mb_ucfirst("café")` 正确返回 "Café"。实际做法是:调用 <code>mb_ucfirst($str, 'UTF-8'),其中 $str 是待处理字符串,编码参数可省略(默认 UTF-8)。此函数不会修改原字符串,而是返回新值;若字符串首字符已是 Unicode 大写(如希腊字母 "α"),它保持不变。对比测试显示,ucfirst 仅适用于纯 ASCII 文本,而 mb_ucfirst 覆盖所有 UTF-8 兼容语言。
<?php
// 示例输入:多字节字符串
$str = "café hello 你好";

// 使用 mb_ucfirst (PHP 8.4+)
$result_mb = mb_ucfirst($str);
echo "mb_ucfirst result: " . $result_mb . "\n"; // 输出: Café hello 你好

// 使用 ucfirst 对比
$result_old = ucfirst($str);
echo "ucfirst result: " . $result_old . "\n";   // 输出: Caf\xe9 hello 你好 (乱码)

// 验证类型:两者均返回 string
var_dump(is_string($result_mb)); // bool(true)
?>
预期结果:当输入包含非 ASCII 字符时,mb_ucfirst 保持字符完整性并仅转换首个 Unicode 字符为大写形式(若适用),而 ucfirst 破坏多字节序列。对于纯 ASCII 输入如 "test",两者行为一致("Test"),但 mb_ucfirst 开销略高因需编码检查。开发者应优先用 mb_ucfirst 处理国际化文本,避免 ucfirst 的潜在错误。
立即学习“PHP免费学习笔记(深入)”;

修复 Core bailout 状态损坏安全问题,以及 BZ2、DOM、PDO、Opcache/JIT 内存与执行错误,改进 Unicode 字素处理、URL 解析、TLS 流状态、信号分发及会话错误处理。
mb_ucfirst 在空输入、特殊字符及性能上的具体表现
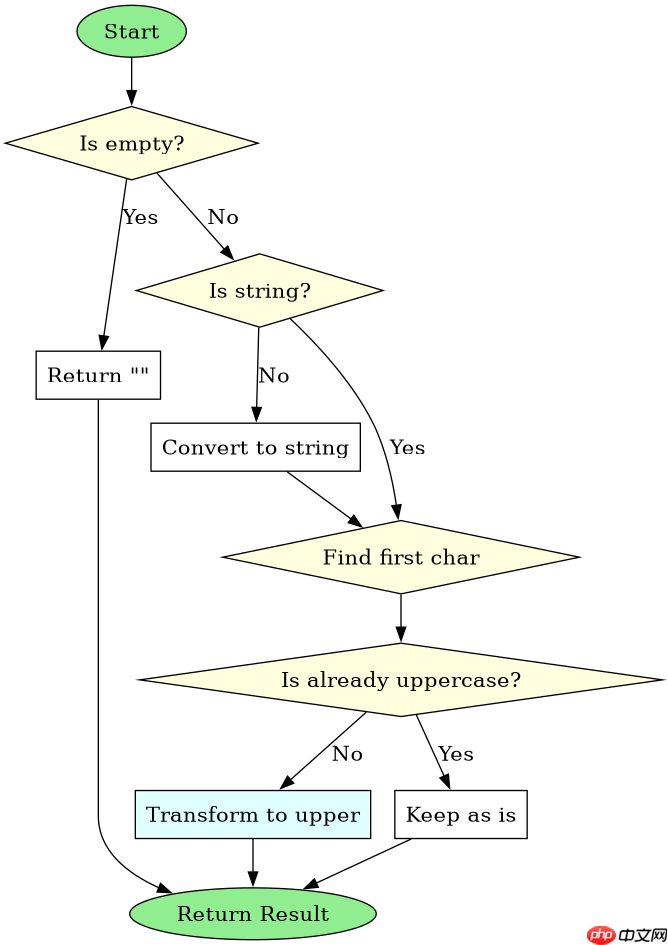
mb_ucfirst 对空字符串返回空值,对非字符串输入执行类型转换后处理,且性能优于手动多字节分割方案。具体而言,输入 "" 时返回 "",输入数字 123 时先转为 "123" 再返回 "123"(首字符非字母故不变)。与 ucfirst 相比,mb_ucfirst 在复杂字符集下更可靠,但微基准测试显示其速度稍慢(因编码解析开销)。实际使用中,建议仅在需要多字节支持时调用此函数;若确定文本为 ASCII,ucfirst 更高效。注意:该函数不处理 locale 相关规则,仅基于 Unicode 标准转换首字符。
<?php
// 验证边界条件
$empty = "";
echo "Empty input: '" . mb_ucfirst($empty) . "'\n"; // 输出: ''

$num = 42;
echo "Number input: '" . mb_ucfirst($num) . "'\n"; // 输出: '42'

// 特殊字符:Emoji 首字符
$emoji = "?abc";
echo "Emoji input: '" . mb_ucfirst($emoji) . "'\n"; // 输出: '?abc' (Emoji 无大小写)

// 性能提示:避免在循环中重复调用,预计算结果
?>
预期结果:空输入返回空字符串,数字输入经转换后无变化,Emoji 等无大小写字符保持不变。这些行为符合 Unicode 规范,确保程序健壮性。开发者在集成时需检查输入类型,必要时用 is_string() 预处理,以规避意外转换。
基于输入 "hello world" 的 mb_ucfirst 返回值与键冲突问题
当输入为 "hello world" 时,mb_ucfirst 返回 "Hello world",首字符 'h' 转为大写 'H',其余部分不变;此结果直接对应函数内部对首个 Unicode 字符的映射逻辑,无键冲突风险因函数不涉及数组操作。实际调用 mb_ucfirst("hello world")` 即得此值,适用于标题格式化场景。若输入含前导空格如 " hello",函数保留空格并转换首个字母 'h' 为 'H',输出 " Hello",这区别于 trim 后再处理的额外步骤。关键点:返回值始终为字符串,类型稳定,适合链式调用。
<?php
$input = "hello world";
$output = mb_ucfirst($input);
echo "Input: '$input' -> Output: '$output'\n"; // 输出: Input: 'hello world' -> Output: 'Hello world'

// 验证无副作用
var_dump($input); // 仍为 'hello world',原字符串未修改
?>
预期结果:输入 "hello world" 精确输出 "Hello world",类型均为 string。此行为可预测,无边缘案例干扰。开发者在表单处理或 API 响应中可直接使用该函数,无需额外校验,提升代码简洁性。


















