


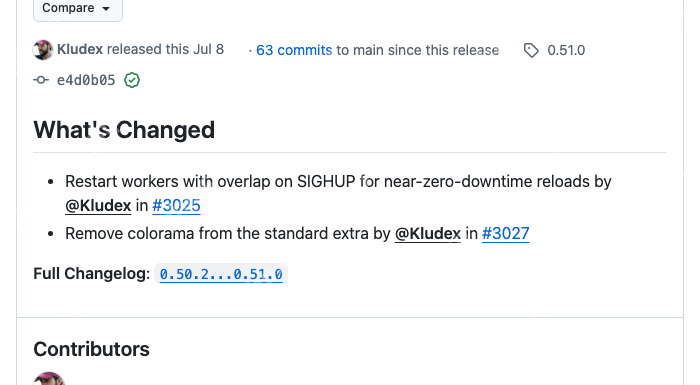
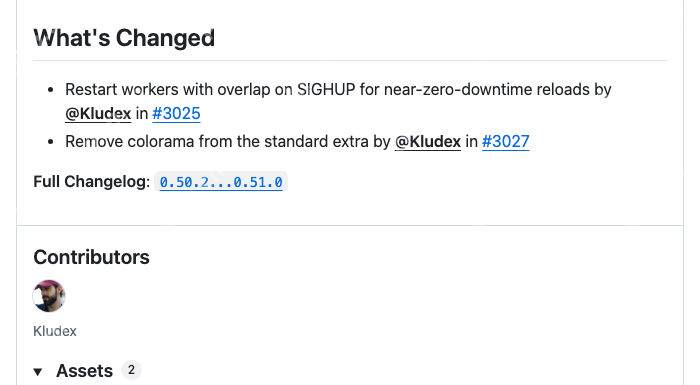
uvicorn 0.51.0 版本,调整了收到 sighup 信号后的 worker 重启顺序。根据官方更新说明,进程管理器现在会逐个处理工作进程:先启动一个替代新进程,等它完全就绪可以对外提供服务后,再关停旧进程,直接避免了此前一次性关闭全部 worker 可能引发的请求中断风险。这个改动专门面向多 worker 部署、通过 sighup 信号触发重载的使用场景。
来源:Uvicorn 官方更新记录
这种逐个替换 worker 的模式,能保证重启全程都有可服务的进程,但最终的平滑效果,还要取决于应用本身的启动速度、健康检查规则,以及服务器上游的流量调度策略。
如果新进程启动失败,运维团队要提前确认进程管理器的错误上报逻辑、旧 worker 会不会继续保持运行,还有当前部署平台会不会同时触发其他重启操作。这次更新只是优化了重启的先后顺序,并不是无条件保证重启过程零中断。
SIGHUP 是 Unix 系系统里的常见信号,Windows 服务环境完全不采用这套信号控制逻辑,这项改动只在对应系统、对应 worker 管理模式下才会生效。部署前要先确认启动命令、进程数和信号传递方式,别让容器编排器和 Uvicorn 同时执行不协调的滚动替换,两套机制叠加很容易出现进程并发启动过多、资源占用冲高的意外情况。
来源:Uvicorn 官方更新记录
你可以用这套可落地的验收流程验证本次更新效果:持续往服务发送带唯一标识的测试流量,手动触发 SIGHUP,记录每个 worker 的启动与退出时间,统计整个过程里的请求失败数、延迟波动和连接重置情况。长连接服务、带后台任务、启动预热较慢的应用,尤其要单独做专项测试。如果进程启动依赖外部服务,健康状态判定规则也要和实际业务就绪条件对齐。
这个版本修改的只是服务进程的替换策略,没法替代数据库迁移、缓存预热或者应用自身的优雅关闭设计。旧 worker 退出前仍然需要留足时间处理完当前请求,应用本身也要合理适配关闭钩子。升级后先在预发布环境把信号传递链路、监控告警规则全部验证完,再推广到生产,才能准确评估这次重启优化是否符合团队的运维目标。












