


一站式ai数字人桌面应用aigcpanel正式发布v2.5.0版本,将此前仅限云端、令无显卡用户望而却步的语音能力,真正深度集成至本地桌面环境。本次更新逻辑极为清晰:只需在ai模型页面的“其他模型”入口中,填入火山引擎豆包语音或阿里云百炼dashscope的api key,即可即时启用云端语音合成能力——即便本地零显卡,也能稳定输出高质量语音。
填入Key的操作被大幅简化与验证前置。软件会在保存前自动调用一句标准试听语:“你好,这是一段语音试听。”仅当该请求成功返回有效音频时,才允许保存配置,彻底规避用户后期在任务日志中反复排查接口失败的低效操作。其底层支撑是一张由主进程统一维护的语音Provider注册表:任一厂商只需将其HTTP接口适配为标准soundTts调用协议,即可快速接入。例如,豆包语音采用X-Api-Key鉴权机制,响应为多段JSON拼接的单向流,客户端需按分片解析并合并为完整音频;而阿里云DashScope则通过qwen-tts模型返回音频直链或base64编码数据。未来若新增服务商,仅需编写一个provider定义文件即可完成接入。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
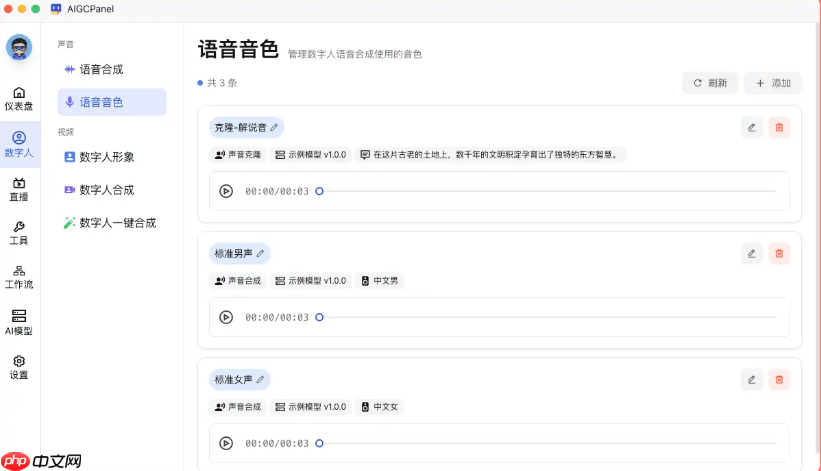
真正的架构升级在于——“声音”终于告别碎片化配置,升维为一套可统一纳管、按场景隔离的音色治理体系。在数字人模块中称为“语音音色”,在直播模块中则称“直播音色”,二者各自拥有独立音色库,均支持添加语音合成或声音克隆音色,并可在保存前实时试听。两套音色数据物理隔离、互不共享:声音克隆所需的参考音频须重新录制或上传,并绑定对应文本标注,不再复用数字人侧已有的音色资源——过去常被诟病的“克隆音色被跨场景误用导致失真”的混乱问题,自此根除。添加弹窗右侧同步嵌入使用指引:克隆模式明确提示录音规范,合成模式则提供分步操作引导。
底层由VoiceService工厂驱动,配合SoundVoice与LiveVoice两个专属存储标识。每条音色记录完整保存类型、模型ID、参数配置及参考音频路径;试听与直播实时合成共用同一套synthesize()调用链,确保效果完全一致。更值得称道的是直播端音色切换的解耦设计:客户端对外仅暴露带Voice:前缀的provider名称,其余路由逻辑由内部自动处理。这意味着未来新增音色时,直播端无需任何代码改动。直播配置优先采用用户选定的音色,若未指定,则自动回退至原有声音驱动配置,保障老用户历史设置零失效。
立即进入“豆包AI人工智官网入口”;

立即学习“豆包AI人工智能在线问答入口”;
直播控制台此次也迎来智能化升级。顶部新增“模型控制”区域,支持一键启停直播专用模型,并实时显示运行状态;旁设“模型日志”按钮,点击即展开滚动日志流。若尚未导入直播模型,界面将主动提示,并提供一键跳转至AI模型页的快捷入口。过去需在多个页面间反复切换才能确认“直播模型是否已启动”,如今所有关键信息集中呈现,实现上亦未重复造轮子:直接从全局模型列表中筛选具备直播能力的记录,状态徽标与日志查看功能复用现有UI组件。
界面细节全面优化。弹窗内容高度自适应,小尺寸窗口下不再溢出屏幕;左侧导航栏当前选中项改用品牌蓝浅色底块高亮,暗色模式同步提亮对比度;禁用态按钮统一调整为浅灰背景+中灰文字,显著提升可读性。若干顽固缺陷也被彻底修复:通用模型任务在进程异常退出时曾被错误标记为“成功”,现改为严格校验最终输出结果是否存在;英文界面下错误提示残留中文的问题已修正;新版Windows系统因wmic命令执行失败引发的报错亦同步清除。
借此次v2.5.0发布,几个持续迭代的老功能也值得新用户重点关注。“可视化工作流”自v2.0.0起即支持拖拽式节点编排,可将大模型、脚本、工具箱无缝串联为自动化流水线,并支持断点续跑,复杂流程无需写代码;v2.4.0上线的“绿幕视频替换背景”与“歌曲翻唱”功能,分别实现精准抠像换背景与人声风格迁移,是上线后用户咨询最频繁的两大亮点;v2.3.0推出的“API服务与接口”,使同一条工作流不仅可通过界面触发,还可通过标准HTTP接口调用,便于深度集成至自有业务系统。从v2.0.0的工作流引擎、20+轻量工具与CLI支持,到v2.2.0的文生图/文生视频能力、v2.3.0的开放API、v2.4.0的绿幕与翻唱,再到v2.5.0对云端语音与音色体系的整合收口,AIGCPanel的发展脉络愈发清晰:让模型只装一次,让声音随时可调、随处可用。













