


很长一段时间以来,openai与anthropic始终游离于ai领域的价格竞争之外。
在中国市场,模型调用费用持续走低,一轮又一轮下探;而硅谷头部厂商却仍将主战场锚定在模型能力的比拼上——高昂定价反而成为其技术前沿性的象征。
但今年夏天,风向悄然逆转。
据《华尔街日报》披露,OpenAI正酝酿大幅下调Token单价,意图从Anthropic手中争夺更多客户。更值得玩味的是,OpenAI之所以提前布局降价,正是预判Anthropic将采取相似策略。
从最新一轮被冠以“地表最强”的模型对决来看,这场价格博弈已初露锋芒。
当理想主义撞上成本逻辑
7月24日,Anthropic亲手为自家最昂贵的公开模型,推出了一款“半价替代方案”。
全新发布的Claude Opus 5,输入端每百万Token定价5美元、输出端25美元,恰好为Fable 5报价的一半。尤为关键的是,降价并未伴随性能缩水——Anthropic明确强调,Opus 5可在“一半价格下逼近Fable 5的顶尖智能水平”。
Anthropic公布的实测数据显示:在编程能力基准CursorBench 3.2中,两者最高分仅差0.5%,而Opus 5单任务成本仅为Fable 5的一半;在操作系统交互基准OSWorld 2.0中,它甚至以约三分之一的成本,就超越了Fable 5的最佳表现。
一个多月前,Fable 5还是Anthropic力捧的“理想型”标杆。
该模型在多项核心评测中领跑,尤其在处理超长文本与高复杂度任务时优势显著;其定价也毫不掩饰高端定位:每百万Token输入10美元、输出50美元,是Opus 4.8的整整两倍。
为让更多用户体验这款高价模型,Anthropic曾限时将其纳入Pro、Max及Team等订阅套餐。即便模型中途下架,7月1日恢复上线后,相关权益仍被多次延期。
然而几天之后,OpenAI发起了一场精准的性价比突袭。
7月9日,OpenAI正式发布GPT-5.6,旗舰模型Sol保持上一代GPT-5.5的价格体系——输入5美元/百万Token、输出30美元/百万Token;但对比Fable 5,其输入成本仅为后者一半,输出成本亦低出四成。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
▲GPT-5.6公布远低于Claude定价后的网络热图
发布过程中,OpenAI几乎全程以Fable 5为参照系:不仅比拼基准分数,更反复测算同一任务所需的Token量、耗时及最终支出。
价格标签之外,战线已蔓延至订阅体系。OpenAI几乎每新增100万用户即重置一次调用额度,并宣布该额度可累积使用;Anthropic则顶着算力压力,继续延长Fable 5在各套餐中的服务周期。
随后Anthropic祭出Opus 5,首轮正面交锋就此拉开帷幕。
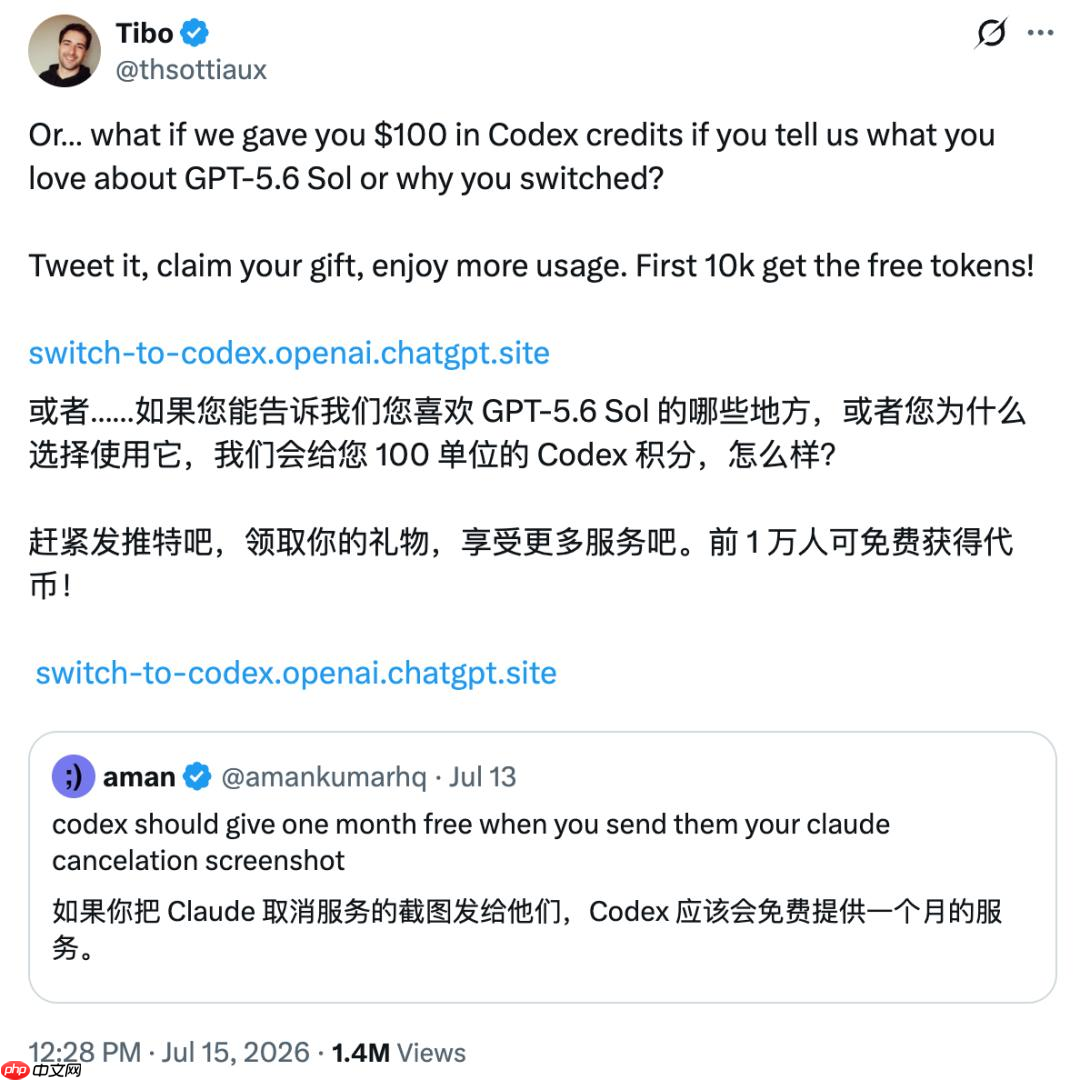
▲Codex负责人Tibo回应社交媒体评论,只需发文称赞Codex,即可直接领取100美元额外用量
OpenAI紧盯Fable 5计算单位任务成本,Anthropic则将接近Fable 5的能力,下放至原有Opus的价格区间。当两家代表前沿技术的头部公司,不约而同开始主动论证“值不值”,这显然早已超出常规促销范畴。
为何顶尖玩家也开始拼性价比?
价格突然跃升为主角,源于大模型采购逻辑的根本性转变。
当Agent深度嵌入业务流程,模型需持续执行多步任务,Token消耗便直接转化为企业的运营成本。
随着“Token军备竞赛”趋于平缓,企业开始重新审视不断膨胀的AI投入,并发现大量支出难以与实际产出挂钩。广告巨头WPP CEO辛迪·罗斯坦言,公司部署的Agent数量已超过员工总数,许多AI开销甚至未纳入原有预算体系;Uber CTO普拉文·尼帕利·纳加也曾透露,公司在短短四个月内就耗尽全年AI预算。
企业选型标准,也因此由“谁跑分更高”,转向“谁能在更低成本下完成同等任务”。
OpenAI在GPT-5.6发布前后反复强调“Useful Intelligence per Dollar”,即每一美元究竟换来了多少真正可用的智能产出。
这固然带有厂商为自身定价背书的意味,却也切中了Agent时代更具现实意义的衡量标尺:单次成功任务的成本。
与此同时,头部模型之间的能力鸿沟,也愈发难以支撑长期溢价。
对于大量日常编程、文档处理与办公协同类任务,市场上已并存多款“足够好”的模型。a16z于2025年对100位企业CIO的调研显示,37%的受访企业已同时接入五款以上模型,较上年的29%明显上升。
可见,模型正加速演变为一种可拆解、可混用、可比价的生产资料;单一模型的性能领先,越来越难转化为用户的长期黏性。
模型厂商的焦虑也由此滋生:用户接入前切换门槛极低;接入后迁移成本却陡然升高。

一旦模型深度嵌入企业代码库、数据接口、内部评测体系与权限管理流程,更换模型便不再只是修改一个API地址,还需重构提示词工程、安全策略与协作流程。谁能赶在市场格局尚未固化前,以更优价格抢占入口,谁就更可能成为未来默认选择。
因此,这场价格博弈的本质,实则是工作流入口之争。
过去,OpenAI借ChatGPT主导消费级市场,Anthropic则深耕企业与开发者生态;Claude Code走红后,双方已实质性进入同一赛道。Ramp数据显示,今年6月,Anthropic的企业付费采用率为42.4%,OpenAI为39.5%。
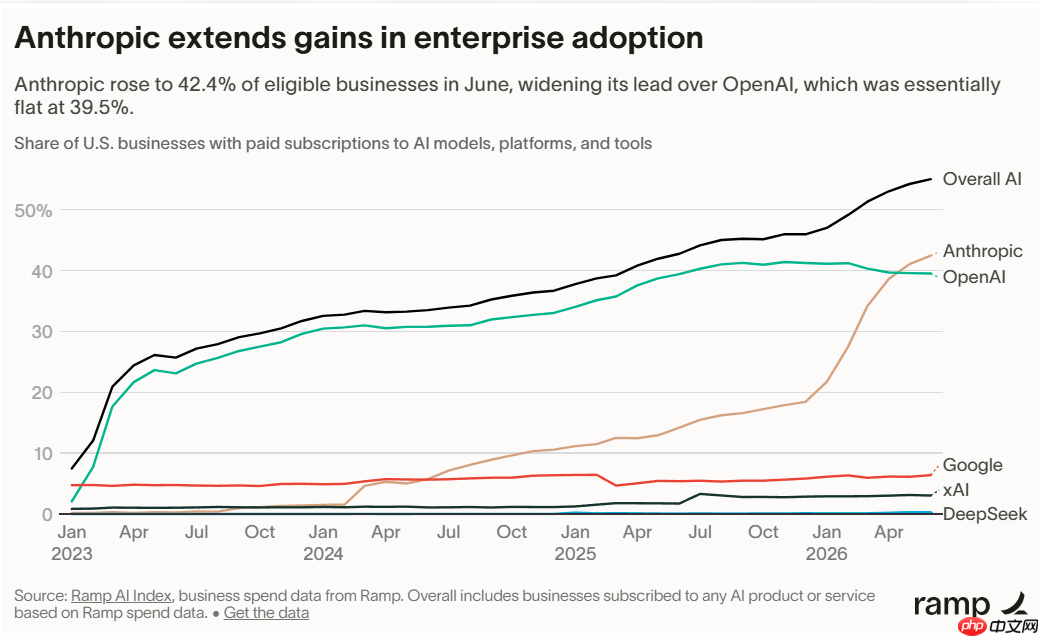
▲数据源:Ramp AI Index
此外,中国大模型也在持续压低硅谷的价格锚点。
例如近期引发广泛关注的Kimi K3,在代码生成、数学推理等关键任务上的表现已跻身全球第一梯队,其API定价仅为输入约3美元/百万Token、输出约15美元/百万Token,显著低于OpenAI与Anthropic旗舰模型的现行报价。
当然,价格战得以爆发,还依赖一个更底层的前提:模型推理成本本身正在快速下降。
据斯坦福AI Index统计,达到GPT-3.5水平的推理成本,在2022年11月至2024年10月间降幅超280倍;同期,AI硬件成本年均下降约30%。模型架构优化、芯片利用率提升、量化压缩、缓存机制与批处理技术的进步,共同释放出可观的降价空间。
不过,推理成本降低只是为厂商提供了“开战弹药”,并不意味着成本凭空消失。价目表上被抹去的部分,终究需要有人承担。
降价的AI,昂贵的战争
毋庸置疑,价格战最直接的受益者是终端用户。
单看每百万Token几美元的价差或许微不足道,但当调用量累计至数百亿级别时,便会转化为真实可观的成本节约。对资金紧张的初创团队与独立开发者而言,这笔节省甚至可能决定一款产品能否顺利落地。
当同等预算可兑换更多Token,应用方就能让高性能模型专注处理复杂任务,让轻量模型承接常规工作,也能支持Agent进行更多轮次尝试。过去因推理成本过高而搁置的智能客服、自动化编程、科研辅助与流程自动化等场景,正逐步回归商业可行性边界。
因此,价格战赋予应用层的,远不止是成本下降,更是更宽裕的试错余地。模型这种“数字原料”越廉价,能在此之上构建的产品形态就越丰富。
但价目表上消失的成本,并未真正蒸发,而是被模型厂商默默接进了自己的账本。
据《The Information》报道,OpenAI的推理支出在2025年激增四倍,调整后毛利率由40%下滑至33%;另据《华尔街日报》消息,OpenAI已将截至2030年的预估算力投入上调至近7500亿美元。
这意味着,模型价格每下调一轮,厂商都必须迎接一次更严苛的规模经济考验:唯有调用量增速快于价格降幅,且推理效率持续提升,降价带来的收入缺口才有可能被更大的体量所弥合。
短期来看,OpenAI与Anthropic呈现攻守易势。
在GPT-5.6带动下,Codex与ChatGPT Work的活跃用户总和已突破千万大关。若模型能顺利嵌入企业代码库、数据接口、权限系统及内部流程,低价吸引来的用户便有望沉淀为长期资产。
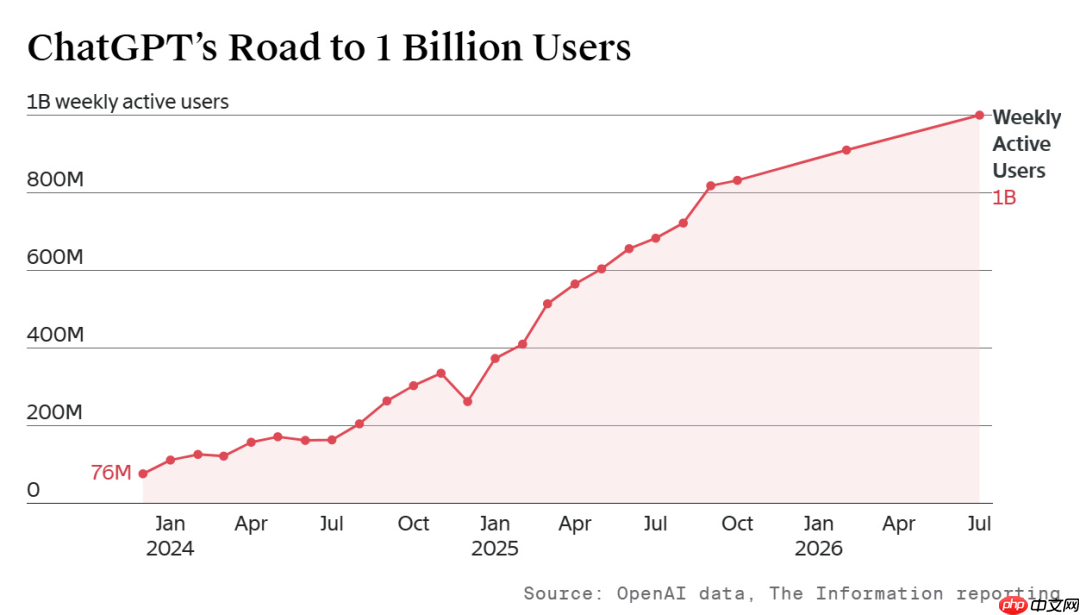
▲ChatGPT周活跃用户达10亿,较原计划推迟半年 图源:The Information
但这笔交易未必稳赚。倘若用户忠诚度薄弱、边际毛利承压,新增调用量或将主要放大算力开支,而非沉淀为可持续收益。
价格战由此演化为一场资本耐力的较量。
这也是其更深层影响:它降低了使用智能的门槛,却抬高了研发前沿智能的壁垒。
与此同时,越来越多的通用能力正加速走向基础设施化。
前沿模型仍可通过复杂编程、长上下文理解与高阶推理维持阶段性溢价,但这种溢价窗口正日益收窄:一项新能力甫一问世,很快就会下沉至更经济的模型,或被对手迅速追平。
近期流传的DeepSeek投资者交流纪要中,梁文锋亦提出一个判断:不同厂商的模型能力难以长期维持显著差距,终局竞争将聚焦于成本控制、迭代速度与用户体验;随着基础模型利润率持续承压,行业格局也将从当前的群雄并起,逐步收敛至少数几家头部玩家。
那么对模型厂商而言,留在牌桌上的每一天,只会愈发昂贵。
本文来自微信公众号“降噪NoNoise”,作者:刘诗雨,36氪经授权发布。















