


今年的菲尔兹奖被广泛称为「最后一届纯血」—— 或许未来的重大数学突破,将越来越多地依赖 ai 与人类智慧的协同完成。
这一转向的速度,可能远超预期:就在菲尔兹奖发布会现场,有记者问及获奖者、加拿大数学家 Jacob Tsimerman 接下来的研究计划,他坦言已正式转向 AI 安全方向,并即将入职 OpenAI 安全部门。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
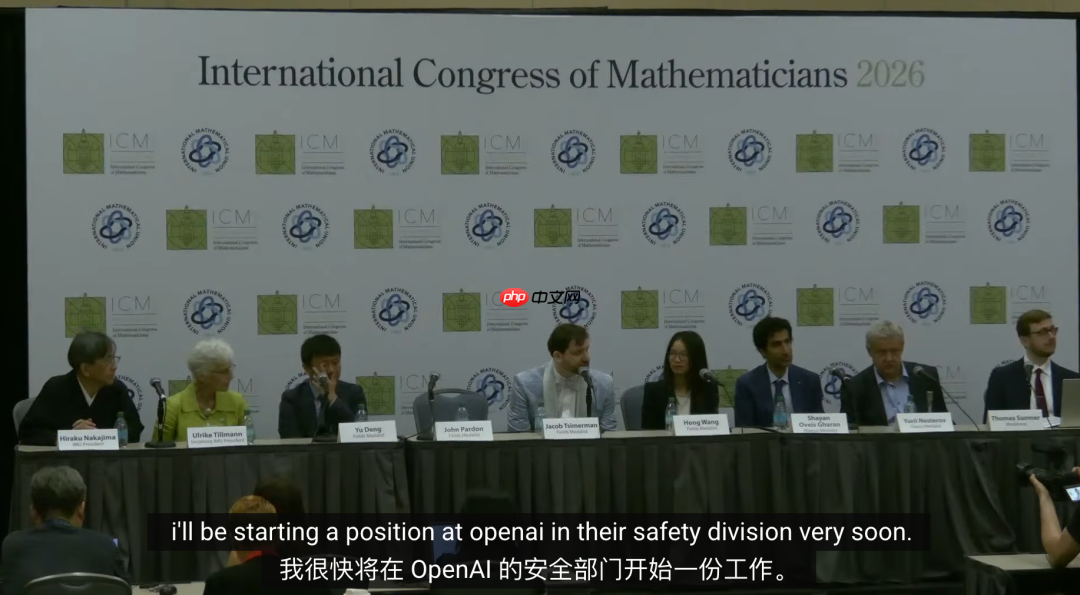
几乎在同一时刻,OpenAI 首席研究主管 Mark Chen 在社交平台公开表示热烈欢迎。
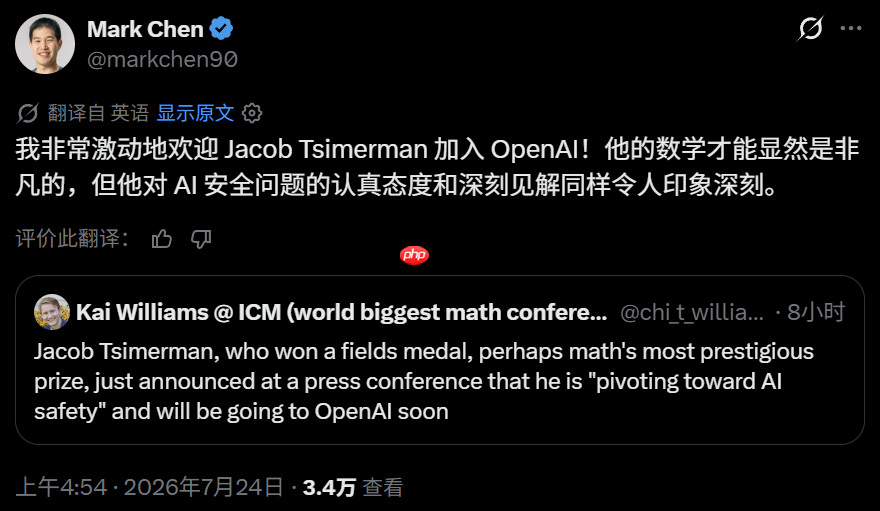
站在知识前沿的学者,正将顶尖 AI 实验室视作实现科学抱负的关键舞台。近来,大批跨学科顶尖人才加速向头部大模型公司汇聚——不仅限于计算机科学家,还包括数学家、理论物理学家、结构生物学家等。仅 2024 年上半年,诺贝尔化学奖得主 John Jumper、宏观经济学家 Chad Jones、分析哲学家 Harvey Lederman 等已陆续加入 Anthropic。
而这些公司也同步调整战略重心:不再仅把科学家当作外部顾问,而是直接请进核心研发一线。AI 与基础科学的深度耦合,正从“可选动作”升级为“必经之路”。
国内大厂亦迅速响应。本周四,字节跳动 Seed Edge 团队正式推出 Seed STEM 科学家计划,首批开放 100 个合作席位,面向数学、物理、化学、生命科学等基础学科领域的科研人员及博士生,邀请他们与 Seed 共同探索尚未被攻克的科学难题。据公开信息显示,这是国内首个系统性、规模化投入 AI 加速基础科学发现的专项计划。
大模型下半场,较量早已超越跑分
在当前以“天”为单位迭代的 AI 竞争节奏中,深耕底层 AI 基础研究,远不如优化工程细节、刷高各类 Benchmark 分数来得立竿见影:后者能快速兑现为产品体验提升与商业回报,而 AI 赋能科学发现的路径漫长、反馈滞后、不确定性极高。
但反过来看,一旦在此类长周期、高难度方向取得实质性突破,其所引发的范式迁移效应,将远超常规功能升级或版本迭代。
姚顺雨曾与团队分享过一个观点:大模型训练没有玄学,真正的难点在于把最基础、最确定该做对的事做到极致。这一判断,也与 Anthropic CEO Dario Amodei 的长期主张高度一致——驱动 AI 演进的核心变量始终是算力规模、高质量数据量、训练时长与可扩展目标函数的设计,“所有精巧技巧,其实作用有限”。
回望 Claude、Seedance 这些真正处于 SOTA 水平的模型,其背后并无捷径可循:无一不是早早锚定方向后,在数据清洗、架构设计、训练策略等底层环节持续重投入。
Anthropic 将资源高度聚焦于模型代码能力构建,通过强化学习驱动模型在反复试错中自主理解编程逻辑、生成鲁棒代码,并基于真实用户行为反馈形成自我增强的进化闭环。
而在多数厂商仍难以稳定推进的视频生成领域,Seedance 则凭借原创模型结构与精细化的数据治理,成功将 AI 视频生成从“抽卡式”的随机实验,转变为具备可控性与可复现性的工业级生产流程。
由此可见,决定模型能力天花板的,从来不是技巧的堆叠,而是数据质量的扎实程度、底层架构的稳健性,以及是否敢于设定长期目标、保持战略耐心与执行定力。
在当下浮躁氛围中坚持走这条路并不容易,但我们欣喜地看到,越来越多中国大模型团队正选择沉下心来,攻坚这类“难而正确”的命题。
今年,DeepSeek 发布的 mHC(流形约束超连接)架构,被视为大模型基础结构领域的重要进展。它作为 DeepSeek V4 的关键升级之一,全面替代了传统残差连接,贯穿整个模型设计。值得注意的是,mHC 的研究明确引用了字节跳动 Seed 团队此前提出的 Hyper-Connections(HC)工作。
在此之前,残差连接作为 Transformer 的默认骨架,已被业界沿用多年;HC 则率先打破单一流向范式,在几乎不增加计算开销的前提下,显著提升了模型的特征建模能力。从 HC 的原创提出,到 mHC 的工程落地,成为中国 AI 团队在底层架构创新上的标志性缩影——这在此前的大模型发展史中实属罕见。
去年初,字节 Seed 特别组建 Edge 团队,专注开展不确定性高、短期难见成果的基础性课题研究。为保障研究人员心无旁骛,团队甚至重构了绩效机制:中期不设考核节点,成果产出后再统一评估。
该团队长期保持低调,近期却在 X 平台发布超长程智能体评测集 EdgeBench,首次在真实交互环境中系统定义 Agent 学习规律,发现环境学习维度的新 Scaling 定律,引发业内广泛关注与讨论。
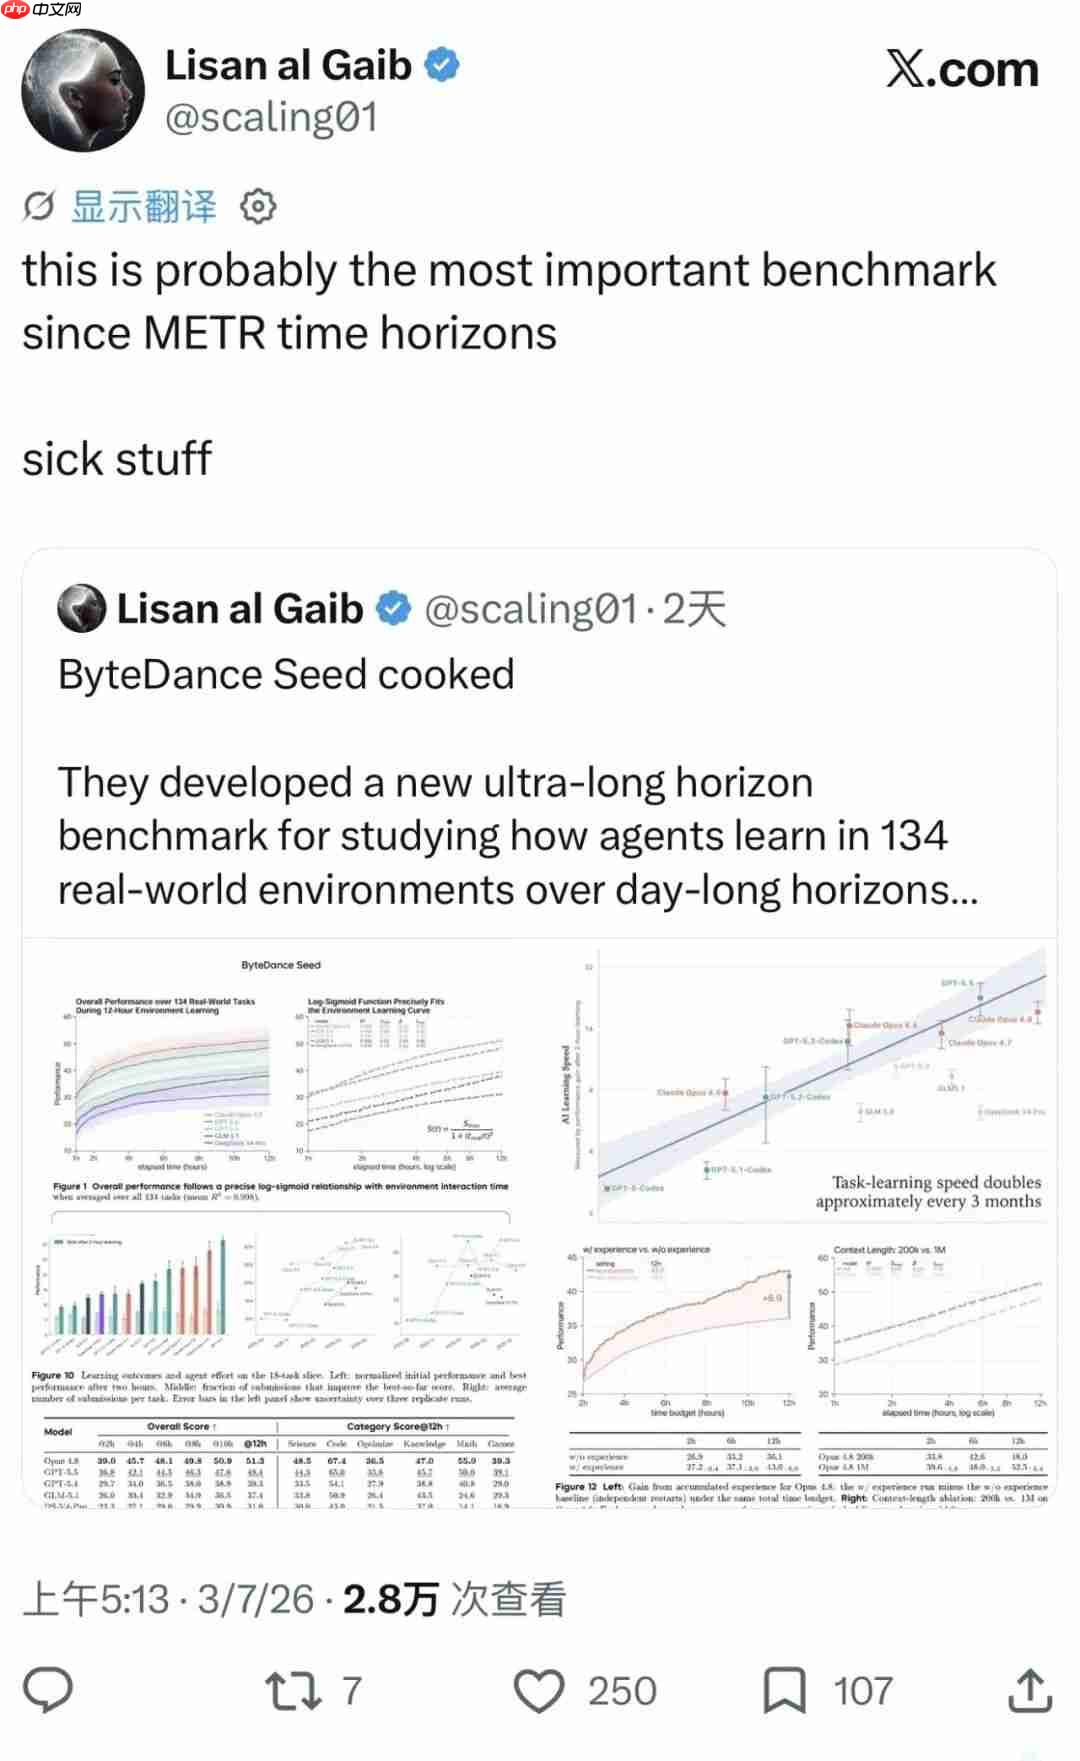
据悉,OpenAI 已开始接入该评测集,用于测试自家模型的长程任务处理能力。
在 AI 领域,公众目光多聚焦于模型本身,而构建高质量 Benchmark 实则需投入大量时间与人力。为前沿 AI 能力设计并开源基准测试,不仅是衡量自身进展的标尺,更是通过确立行业共识、暴露模型短板,推动整个领域走向更透明、更可靠、更可验证的发展轨道。顶尖 AI 实验室对此类基础设施建设的投入,毫不逊色于模型研发本身。
OpenAI 开源的 Evals 框架,已成为评估大语言模型及 LLM 应用系统的事实标准。针对特定前沿能力,他们还构建了 SimpleQA、BrowseComp、MLE-bench 等一系列专用评测套件。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
Anthropic 则围绕 SWE-bench 深耕代码能力评测,并发布 Terminal-Bench,专门评估 Agent 在真实命令行环境下执行复杂链路任务的表现。
这些评测体系与各家模型能力优势之间的强关联,并非巧合。
可见,全球前沿 AI 团队对技术演进路径的认知正在发生深刻转变:大模型能力跃迁已越过单纯依靠参数与数据堆叠的预训练红利期;下一阶段的增长引擎,必将来自模型在真实开放世界中的持续感知、交互、反馈与自主演化。
而基础科学所处的前沿阵地,恰恰是开放未知场景的最高形态。字节此次推出的 Seed STEM 科学家计划,正是为了携手科学家共同识别关键科学问题、设计突破路径,系统探索 AI 加速科学发现的可行范式。科学家带来的不只是具体题目,更是问题意识、判断尺度与反馈机制。
为何全球顶尖 AI 公司
都在竞相招募领域科学家?
答案很简单:如今主流评测中的“题”,对大模型而言已不够难。
当前主流模型评测体系,大多围绕封闭式、有标准答案的任务展开——解法唯一、评价明确、提升路径清晰。但真实的科学研究截然不同:它没有标准答案,缺乏固定解法,需要研究者主动提出假说、设计验证逻辑、应对噪声与异常、推演深层机制,全程充满探索、试错与不确定性。
真实世界的复杂任务,才是检验 AI 终极能力的终极考场。继预训练 Scaling、测试时 Scaling 之后,业界普遍认为,“在真实开放环境中持续交互学习”是最具潜力的下一阶段 Scaling 方向。
因此,全球领先 AI 团队在研发下一代模型时,已不再满足于内部闭门调优,而是主动引入各学科顶尖专家,让真实的领域挑战成为模型能力进化的牵引力。
在北美,高校科研力量正加速向产业界流动。7 月初,加州大学伯克利分校 EECS 系主任 Jelani Nelson 宣布进入学术休假,并加入 Anthropic。今年以来,已有至少 22 位来自斯坦福、伯克利、哈佛等顶尖高校的教授或研究员,暂时减少或暂停教职,转入 OpenAI、Anthropic、DeepMind 与 Meta。这四家公司目前聚集的现任或前任大学教授已超 80 人。
人才流动背后,更有成体系的机制支撑。
OpenAI 的 Residency 项目已成为其年度常态化高端人才引进通道,明确面向“当前研究方向非 AI”的跨学科专家。参与者自入职首日即进入前沿应用与研究一线,开展实战协作。该项目堪称“加速版博士训练”,帮助非 AI 背景专家高效完成学科融合。ImageGPT、Codex 等里程碑项目中,均可见驻场研究员的深度参与;GPT 系列在数学推理、生物机制建模等科研能力上的跃升,亦离不开此类跨学科人才的持续注入。
Anthropic 的 STEM Fellows Program,则在 2026 年完成系统化扩容,专为物理、生物、数学、经济等领域专家设立。项目为期数月,邀请各学科顶尖学者携带本领域未解难题或复杂工作流,直接使用尚未发布的 Claude 模型及内部评估工具进行攻关。
材料科学家为 Claude 构建相图稳定性推理专属评测流程,气候科学家将专业大气模拟工具与模型深度集成。驻场期间,超 80% 的研究员产出了高水平学术成果,这些来自真实学科场景的反馈,直接转化为模型训练信号,有力推动了 Claude 在科研推理、复杂工具调用等维度的能力进化。
此类项目的深远意义早已超越单一科研项目本身。顶尖 AI 公司已将争夺领域科学家,置于与争夺算力同等重要的战略位置。
对科学界而言,合作价值同样巨大。大模型正逐步成为新型科研基础设施:从公式推导、数值仿真,到海量文献与实验数据挖掘,AI 正在重塑科研范式,使过去受限于人力与算力而停滞的课题重获突破可能。
受邀进入大模型团队开展驻场研究,其意义不亚于天文学家获得新一代太空望远镜的独家观测权。这类合作不仅能提供充沛算力与前沿模型访问权限,更能让科学家借助 AI 作为“外脑”,将宝贵精力聚焦于问题定义本身。
对涌入 Anthropic 与 OpenAI 的科学家而言,这种深度融合既是科研效率的倍增器,也是撬动新发现的支点。而当我们把目光转向国内,会发现 AI 与基础科研交叉领域的空白,正由字节 Seed 率先填补。
AI 的终局
比拼的是长期主义
当菲尔兹奖得主选择加入 OpenAI,当越来越多 STEM 科学家走进模型研发一线,AI 下一阶段的竞争焦点,正从短期产品优化、榜单排名与单点任务突破,转向更长期、更复杂、更本质的基础性命题。
科学研究之所以关键,正因为它始终立于人类认知边疆。若 AI 能在如此高维、开放、不确定的环境中站稳脚跟,便意味着它真正具备了参与现实世界复杂任务的能力。
这条路注定缓慢、沉重、充满未知。但也正因如此,它才最能检验一个团队是否真正愿意沉潜于基础、扎根于前沿。
大模型最终要交出的答卷,不是在多少榜单上拿第一,而是能否与人类一道,去攻克那些尚未被回答的问题。
科学进步需要长期主义,AGI 的实现,亦如是。
本文来自微信公众号 “机器之心”(ID:almosthuman2014),作者:泽南,36氪经授权发布。














