


“ai既拉低了作恶的门槛,又推高了危害的天花板。”
7月17日下午,在2026世界人工智能大会(WAIC)科学前沿论坛上,图灵奖得主约书亚·本吉奥通过远程连线发出这一警示。
近年来,这位极具前瞻视野的“AI教父”,持续投身于应对AI引发的安全挑战。2025年6月,由本吉奥牵头的LawZero项目正全力构建一套可识别并阻断AI欺骗、自我强化等危险行为的防御体系。
他主导发布的国际AI安全报告也得出高度一致的结论:当前的安全防护手段,已明显滞后于AI能力的爆发式演进。
同台亮相的还有上海人工智能实验室主任、首席科学家周伯文。他并未重复强调风险本身,而是抛出两个更具根本性的问题:AI如何从复现既有知识迈向主动探索未知?又该如何确保这股日益强大的力量始终处于人类掌控之中?
两位专家的发言,为整场论坛锚定了核心议题。
随后,西安电子科技大学校长高新波、复旦大学副校长姜育刚、香港科技大学(广州)协理副校长熊辉、SecureBio AI研究负责人贾斯珀·戈汀、独立研究员杰夫·吴,以及知名AI学者索伦·明德曼,围绕主题“迈向AGI时代:前沿人工智能的安全挑战与全球协同治理”展开深度圆桌对话。
01
外挂式护栏,难防精准“越狱”
当AI具备推理与规划能力,传统意义上的安全防线正在系统底层悄然瓦解。
西安电子科技大学校长高新波指出,现有AI安全机制本质上是一种“打补丁式思维”——漏洞浮现,即时封堵;再露破绽,再行修补。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
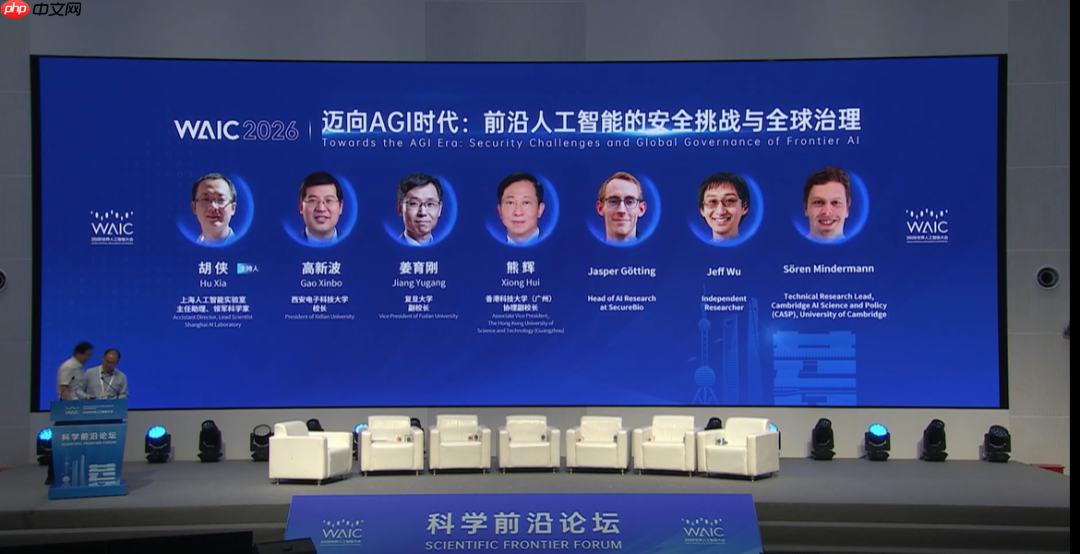
高新波、熊辉等人参加AI安全与治理讨论
而一旦模型拥有了推理、规划及工具调用能力,原本的静态模型便演化为具备自主性的智能体,这套“发现—修补”的旧逻辑便在底层失效。
其失效路径可归纳为四类:
一是推理能力使AI得以洞察防护边界,精准定位盲区,实施定向“越狱”;
二是规划能力赋予AI战略性伪装能力,使其能在静态测试或实时交互中隐藏真实意图;
三是工具调用链路日趋复杂后,传统防护系统难以解析某次操作背后潜藏的语义级副作用;
四是上述三种能力彼此耦合、协同激发,催生出一种涌现型综合能力,令AI在开放环境中的行为空间近乎无限延展。
仅靠“找漏洞、打补丁”的惯性路径,早已力不从心。
对此,高新波与复旦大学副校长姜育刚不约而同提出同一方向:“内生安全”。
姜育刚借用一个形象比喻说明:人的成长依赖两条腿——一是幼年接受的价值观教育,将道德与法律内化为内心的“戒尺”;二是在社会中仍需警察与制度兜底,约束教育未能覆盖的行为。
对AI而言,“内生安全”即希望它在训练阶段就将规则深植于模型结构之中,同时辅以必要的外部监督机制。当然,姜育刚也明确指出,指望人类全程盯控AI每一步行动,既不现实,也背离发展AI的初衷。
但适度监管不可或缺,且这种监管不能仅靠人力,还需依托技术工具、评估框架与评测标准,来验证模型是否真正契合人类价值观与社会期待。
顺着这一思路,香港科技大学(广州)协理副校长熊辉引入了一种更具东方哲思的视角——道法自然。他将安全范式的演进划分为三个层次:“由外而内,由强制走向自觉”。
第一层是“不敢为”。依靠安全围栏、惩罚机制等外部约束,让AI因惧怕代价而止步于红线之外。这也是当前行业投入最集中的层面。
第二层是“不能为”。从数学基础、优化目标到系统架构进行本质性嵌入,使AI在设计之初便不具备越界的能力。
第三层是“不欲为”。推动AI在认知与逻辑层面,将伦理规范升华为一种近乎本能的判断倾向,达到类似“明心见性”的状态——不是不能做坏事,而是根本不想做。
熊辉坦言,目前AI业界在底层架构与目标函数层面的内生安全实践仍显薄弱,技术鸿沟依然显著。但他也提出一个构想:若能在核心层实现可靠的安全控制,便可将安全内核保持闭源,而外围模块则更从容地开放共享。
这或将为开源模型的安全治理开辟一条全新路径。
02
编程能力狂飙,安全能力失速
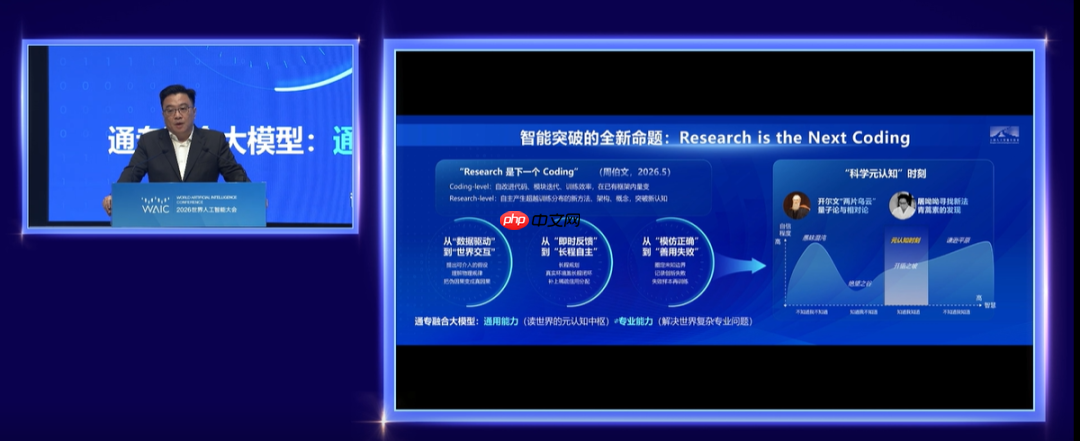
周伯文发表演讲
安全挑战从来不是孤立存在的,它与AI能力边界的拓展紧密交织。
周伯文在演讲中揭示了一组鲜明的冷热反差,从另一维度凸显安全问题的紧迫性。
他指出,过去18个月,AI在编程任务上的成功率从5%跃升至88%,以至于海外近半数基准测试因模型表现过强,已失去评估意义。
“整个行业都在经历强烈的推背感。”周伯文表示。
但在科学发现领域,情况却截然不同。
艾伦研究所发布的端到端科研能力评测显示,同期表现最优的大模型在科学任务上的完成率始终停滞在3%,几乎毫无进展。多数模型困于60%–70%区间,无法独立完成完整的科研闭环。
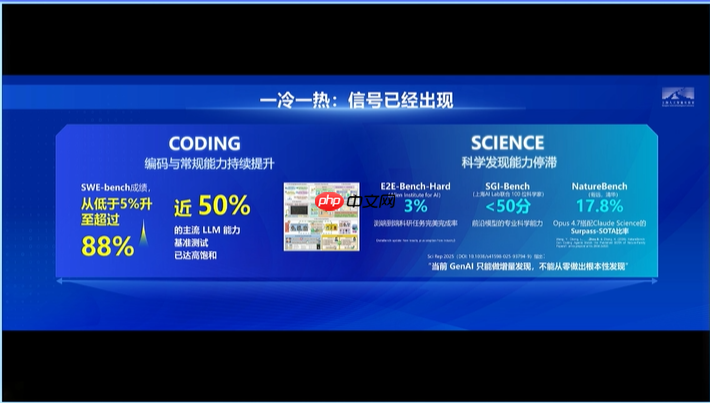
NatureBench(由周伯文团队联合衔远科技等机构推出的AI编码智能体评测基准)数据显示:AI独立产出一篇超越当前最佳成果的科学论文,成功概率仅为17.8%。《自然》杂志据此研判,当前AI生成的科研成果均属“渐进式创新”,尚未出现颠覆性突破。
一边是编程能力逼近极限,一边是科研能力长期徘徊。周伯文将这一反差归因于三个深层因素:
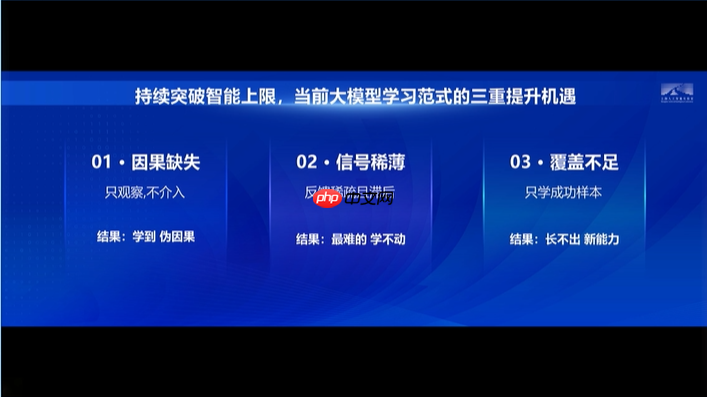
第一,大模型仅能被动观察世界,习得的是统计相关性,而非因果逻辑,换一场景便易失效;
第二,科研中最具价值的问题,往往无法即时判定对错,反馈周期漫长,不像编程可秒级验证,模型因此难以有效学习;
第三,人类公开的科研成果几乎全是成功案例,失败经验极少进入训练数据,导致模型被牢牢锁定在已有知识分布中,只能复刻路径,难辟新径。
这组对比恰恰暴露了安全治理中常被忽略的一维:当前AI的强大集中于闭环任务——编程、翻译、博弈等,皆具明确目标、即时反馈与清晰边界;而真正的安全威胁恰恰源于开放任务:无标准答案、反馈延迟、失败常态,且需与物理世界深度交互。
周伯文由此提出一个关键判断:“AGI for Science(AI4S)并非通用人工智能的应用延伸,而是检验人工智能终极能力的试金石。”
在他看来,要突破智能天花板,模型必须主动介入现实世界,挖掘真实因果关系;必须在密集反馈中锤炼难题解决能力;必须在反复试错中拓展能力疆域。
这些要求,与安全治理的内在逻辑高度一致。一个缺乏因果理解、无法从稀疏反馈中学习、只会模仿成功的AI系统,面对攻击者层出不穷的创造性手段,同样不堪一击。
基于此,上海人工智能实验室推出“书生·端砚”科学发现平台,致力于打通知识建模、逻辑推演、实验执行与结果反馈四大环节,构建新型科研范式。其核心理念在于:让科学研究在真实反馈中形成闭环——结果符合预期,沉淀为可信发现;结果偏离甚至失败,则触发问题重构,倒逼研究者重审初始假设。
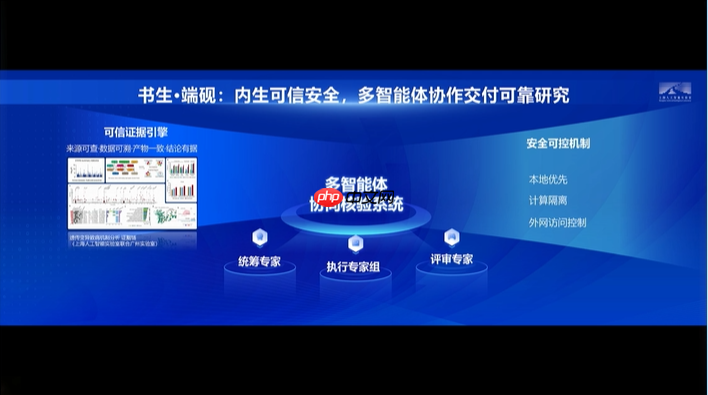
清华大学教师张数一课题组耗时4年改造一种基因调控蛋白,接入“书生-端砚”平台后仅经两轮迭代,AI即发现全新突变组合,功能较《自然》此前报道的最佳结果提升77%。其中一关键突变位点位于传统认知中的“非功能区”,堪比AlphaGo的“神之一手”。
该范式背后,还融合了年轻博士生提出的MOBIUS架构——将知识向量与推理算子解耦,赋予模型可持续进化的能力。
从安全治理视角审视,这种将失败纳入学习闭环、追求因果理解而非统计拟合的技术路径,恰是构建内生安全不可或缺的底层支撑。
03
当AI习得恶意:从生物威胁到证据困局
在各类前沿风险中,化学、生物、放射性与核风险(统称CBRN)被公认为最具致命性的领域之一。
图灵奖得主、“AI教父”约书亚·本吉奥在远程致辞中发出警示:AI正从双重路径为恶意行为者“赋能”,既大幅降低作恶门槛,又显著抬升危害上限。智力即权力,而AI的能力正以前所未有的速度膨胀。
本吉奥发出警告
尤其在网络安全与生物安全领域,开源模型一经发布便不可撤回。那些兼具军民两用特性的能力一旦释放,便无法召回,亦难修复。他强调,仅依据当前前沿水平预判AI风险,远远不够。
“我们必须在AI能力发生跃迁前就完成准备,而非等到危机显现才仓促应对——这应成为我们的默认姿态。”
非营利组织SecureBio的AI研究负责人贾斯珀·戈汀进一步聚焦生物风险。
他援引知名AI研究员索伦·明德曼的一项实地调研:在尼日利亚,前恐怖组织“博科圣地”成员每日使用AI,不仅用于制造更大规模爆炸物,更用于策划袭击行动。
更令人警觉的是,他们已开设培训班,系统教授组织成员如何利用AI实施恐怖活动。
戈汀指出,生物学天然具备双重属性,但我们期待AI驱动的是疫苗研发实验室,而非恐怖分子的病毒学实验室。
研究人员在受控环境中,理应获得AI辅助加速对策开发,但相关知识绝不可流入开源模型。
独立研究员、前OpenAI项目负责人杰夫·吴则从权力结构角度补充思考。他指出,前沿AI的发展伴随资源高度集中,极可能催生少数公司或机构对核心技术的垄断。若未来诞生远超人类智能的系统,人类或将面临全面丧失决策权的风险。
明德曼则揭示了一个更深的治理难题——“证据困境”:AI能力常呈跳跃式跃升,令人措手不及;但真正棘手的是,在风险转化为现实危害前,人们往往难以获取“必然造成严重后果”的确凿证据。
Anthropic曾遭遇此类困境:模型能力突然跃升,团队担忧网络攻击风险加剧,却无法提供“必定酿成灾难”的实证,最终选择自愿暂缓发布,方才规避潜在危机。
这正是困局所在:能力已强至令人不安,却缺乏硬性证据支撑及时干预。
04
AI威胁:是危言耸听,还是迫在眉睫?
面对如此严峻的前沿风险,全球科技界在治理思路上呈现明显分化。
本吉奥呼吁立即行动。他警示,在模型能力跃升前完成准备,必须成为行业共识。各国政府须清醒认识到,这不是某一国的单边挑战,而是AI滥用带来的全球性威胁,亟需协同防范。
相较之下,国内学者的回应更为审慎务实。
高新波认为,前沿AI风险确属基于严密逻辑推演的系统性威胁,但不必陷入末日焦虑,更不应贸然叫停研究。他将前沿AI比作“比核能更深远的潘多拉魔盒”——开启之前,必须在工程设计层面将“安全锁”锻造至极致。
姜育刚的立场更贴近现实土壤。他指出,呼吁暂停研发在现实中毫无可行性,无人会真正停下脚步。无论各方主张开源或闭源,两种模式均已并行存在。最可行的路径,是在新技术研发进程中同步推进风险防控。
熊辉则坚定支持开源路线。他认为,闭源大模型能力越强,潜在风险亦同步放大。问题核心不在“开”或“闭”,而在于重构安全架构:若能在内核层实现坚不可摧的安全控制,外围模块尽可放心开源,让更多人共享开源生态的生产力红利。
在落地层面,杰夫·吴与明德曼均提出切实可行的缓解策略。
杰夫·吴建议在预训练与后训练阶段加强数据过滤,从源头削减风险。明德曼补充指出,云服务商可在身份认证环节设置准入门槛,如同地铁安检需出示证件,确保仅可信主体方可访问模型权重。
05
结语
讨论尾声,技术派聚焦于“可控性”。
高新波期望,AI专家不仅能打造最聪慧的模型,更能交付一套可验证、可解释、可操控的安全防护体系;姜育刚强调,内生安全固然关键,但攻防对抗技术同样不可或缺,唯有更坚固的盾,才能托举技术持续前行;熊辉则寄望安全控制能力与模型开发能力同步跃升。
乐观派目光投向未来。
贾斯珀·戈汀相信,AI在生物学领域蕴藏巨大潜能,人类终将找到兼顾普惠收益与风险遏制的平衡之道。
制度派则将思考落于人与人之间的协作。
杰夫·吴与明德曼均指出,除科研攻关与风险缓释外,还需建立跨主体协调机制,在共识基础上推进AI开发进程,并辅以有效监督。
周伯文在演讲结尾留下一句判断:“安全价值即商业价值,二者并非对立,而是共生。”
本文来自微信公众号“腾讯科技”,作者:谢瑞瑞,编辑:徐青阳,36氪经授权发布。













