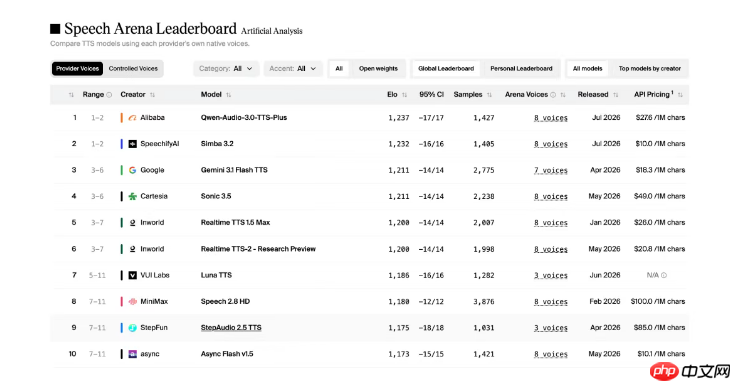
近日,阿里通义千问团队正式推出全新一代实时语音合成模型——qwen-audio-3.0-tts,标志着语音合成技术正从“能发声”加速迈向“懂情感、善表达”的新阶段。其plus版本已在国际权威评测平台artificial analysis推出的speech arena榜单中荣登全球榜首,整体性能表现超越gemini 3.1 tts、elevenlabs v3等当前主流语音合成系统。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
本次发布的模型涵盖两个差异化版本:Flash版专注极致实时性,首包延迟低至约300毫秒,专为智能客服、实时对话助手等对响应速度要求严苛的交互场景优化;Plus版则聚焦高保真语音生成,在自然度、韵律连贯性与音色还原精度方面实现显著提升。
核心技术能力达成四大关键跃升:
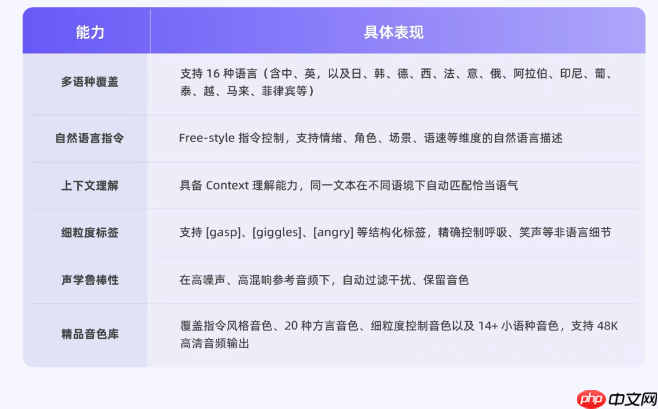
一、多语言及方言支持能力全面增强。模型可覆盖16种主流语种,其中Plus版在全部16种语言上的平均说话人相似度达82.75%,稳居行业首位;同时原生支持20种中文方言,有效破解以往TTS系统中“方言韵味流失”“地域特征模糊”等难题,语音表达更贴近真实母语使用者习惯。
二、首创Free-style自然语言指令控制机制。用户无需掌握专业标注语法,仅需输入如“亲切耐心的银行客服口吻”“热情洋溢的直播带货风格”等日常化描述,即可精准驱动模型生成匹配语境与角色的语音输出。

三、提供细粒度声学标签调控能力,支持[gasp](喘息)、[angry](愤怒)、[laugh](轻笑)等结构化语义标签,可灵活操控呼吸节奏、情绪微表情、语气停顿等非文本语音要素,高度适配游戏NPC配音、有声读物演播等强表现力需求场景。
四、具备卓越的复杂声学环境鲁棒性。即使输入的参考音频存在严重背景噪声、强混响或录音失真,模型仍可自主完成噪声抑制与音色保真,确保合成语音清晰稳定、风格一致。
配套上线的精品音色库涵盖通用指令音色、方言专属音色、小语种特色音色等多元类型,并全面支持48KHz高清音频输出(预计于7月24日正式开放),单次可处理最长3分钟的连续文本。目前,Qwen-Audio-3.0-TTS已全面接入阿里云百炼平台,面向广大开发者开放调用,诚邀共同探索下一代智能语音交互的无限可能。