


近期,deepseek 正在大规模扩充团队,招聘岗位覆盖算法、研发、产品、运维、数据工程及职能支持等多个方向。
与此同时,DeepSeek V4 正式版预计将于本月中旬正式发布。在其此前公开的 DeepSeek V4 论文作者名单中,我们注意到一位熟悉的名字——清华大学 2021 级博士生、2025 年研究生特等奖学金得主顾煜贤(Yuxian Gu)。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
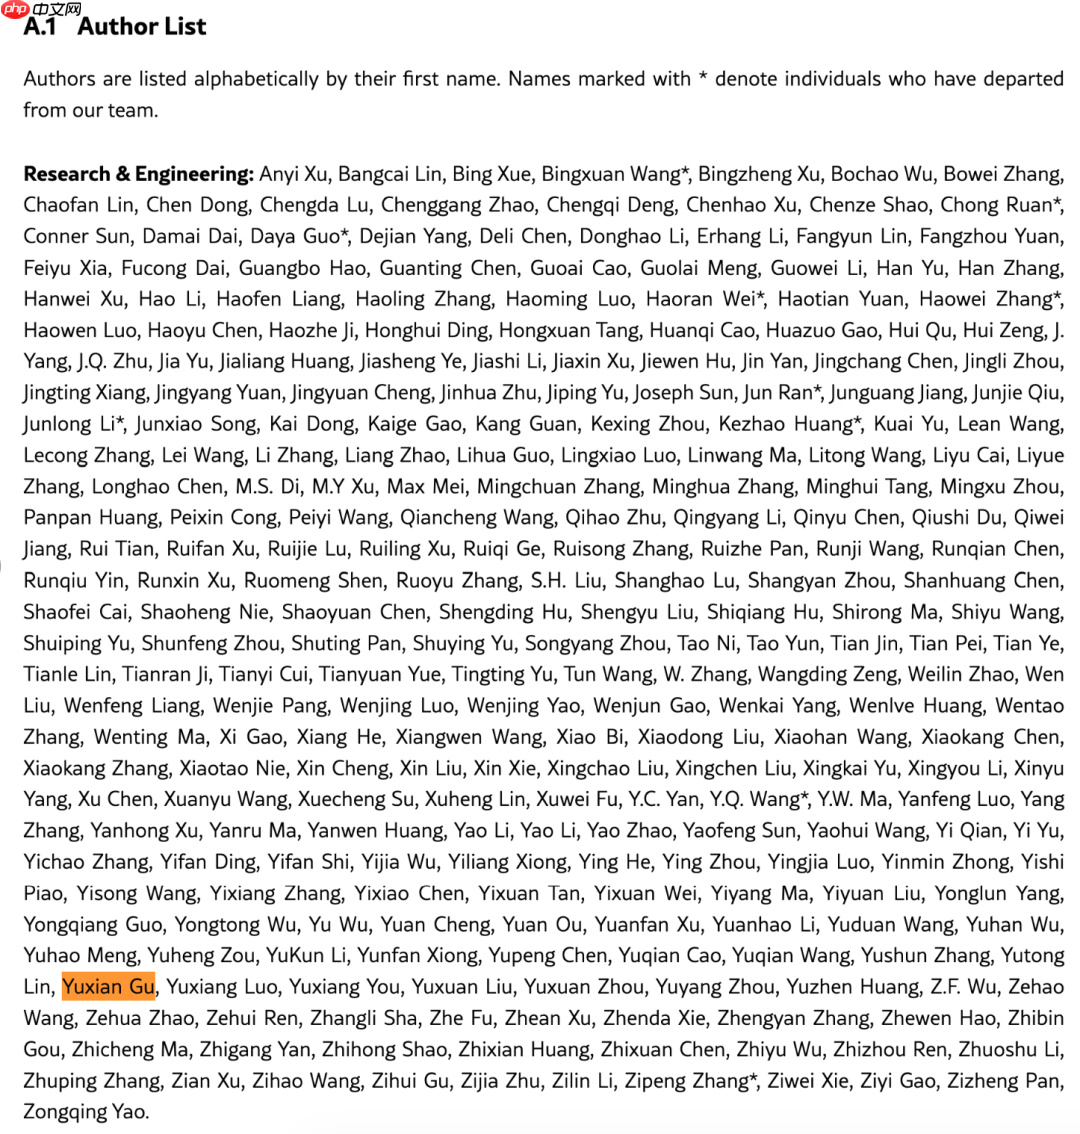
据多方确认,顾煜贤目前已正式加入 DeepSeek。
此外,他还曾荣获 2025 年苹果博士奖学金及蚂蚁集团 In-Tech 奖学金。
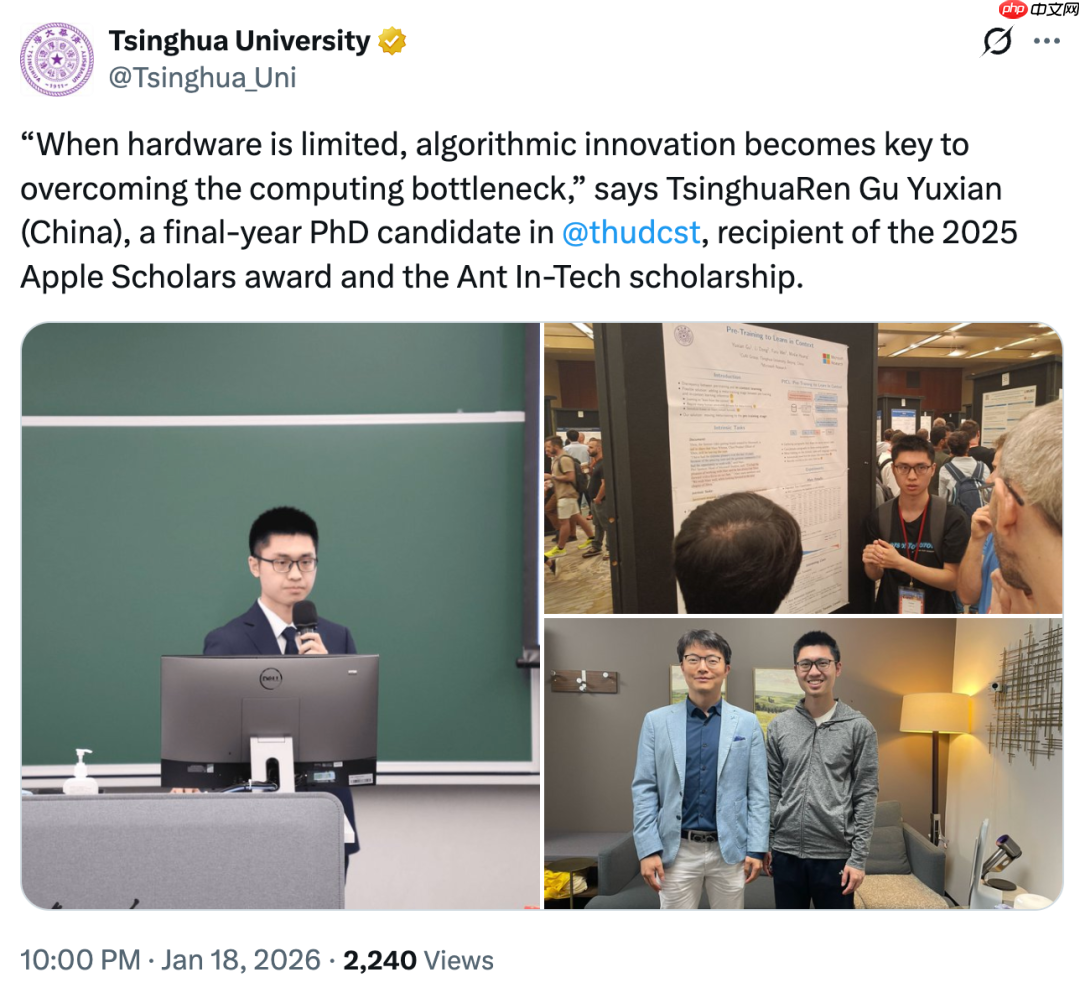
“当硬件资源受限时,算法层面的突破往往成为跨越算力瓶颈的核心路径。”作为清华大学计算机系应届博士毕业生、本科亦毕业于清华的顾煜贤如是说。
其个人主页显示,他师从黄民烈教授,隶属于清华大学交互式人工智能课题组(Conversational AI, CoAI)。
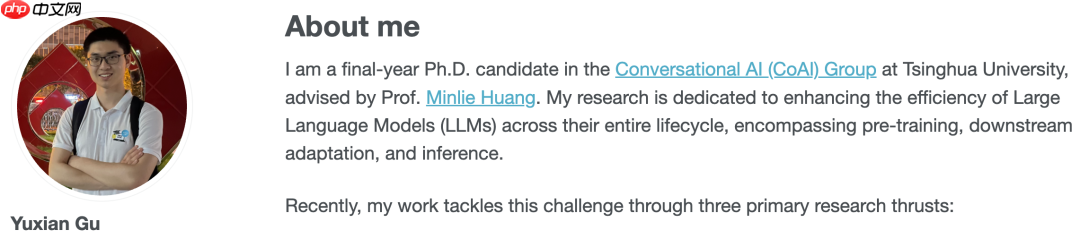
个人主页链接:https://www.php.cn/link/330ed495de3b92a521c187d5477ae927
他的研究聚焦于大语言模型全生命周期的效率优化,贯穿预训练、下游适配与推理等关键环节,并围绕以下三大方向持续深耕:
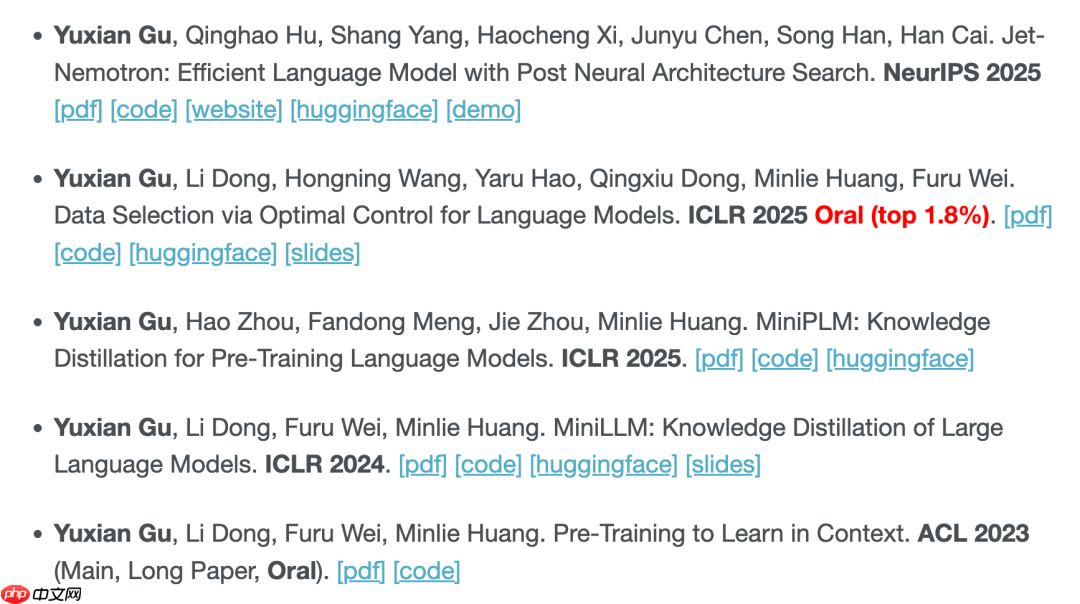
预训练数据筛选:构建兼具理论支撑与实践可行性的算法框架,提升大模型训练阶段的数据选择质量,助力更高效、更强性能模型的构建。代表性成果包括 PDS、Instruction Pre-training 和 Learning Law。
知识蒸馏驱动的模型压缩:提出新型蒸馏策略,实现大模型知识向轻量级模型的高质量迁移。代表工作有 MiniLLM 和 MiniPLM。
高效模型架构设计:探索兼顾计算成本与性能表现的新一代模型结构,相关成果涵盖 Jet-Nemotron 系列。
在 Google Scholar 上,顾煜贤的论文总引用已逼近 5000 次,其中两篇引用超千次,分别为《Pre-trained models: Past, present and future》与《MiniLLM: Knowledge distillation of large language models》。
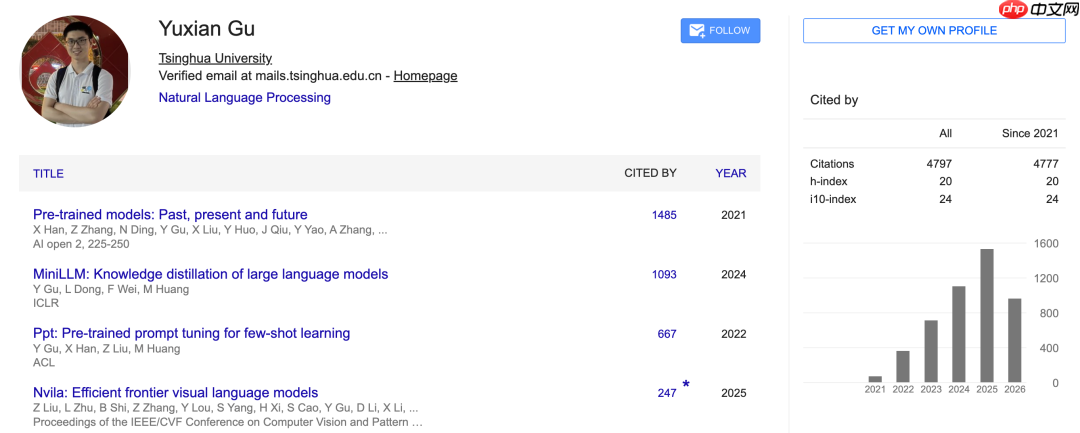
他以第一作者身份多次在 NeurIPS、ICLR、ACL 等国际人工智能顶级会议发表研究成果。

使用AIsa生成图像与视频。仅需一个API密钥即可调用Gemini 3 Pro Image(图像)和Qwen Wan 2.6(视频)。
机器之心曾在去年报道过「Jet-Nemotron」——一种融合多种先进技术的新型混合架构语言模型系列,在保持全注意力模型最先进精度的同时,显著提升了运行效率。
Jet-Nemotron 的核心创新主要体现在两个方面:
后神经架构搜索(Post Neural Architecture Search,PostNAS):一种面向任意预训练 Transformer 模型的高效后训练架构发现与自适应方法。
JetBlock:一种原创性线性注意力模块,实测性能优于 Mamba2 等主流设计方案。
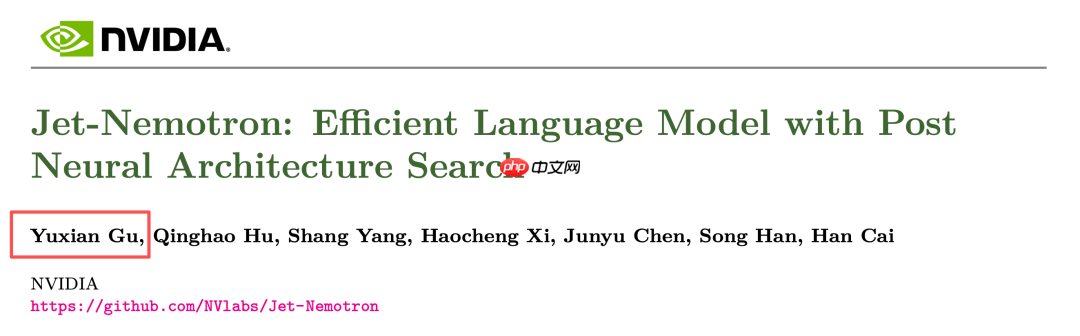
论文原文:https://www.php.cn/link/bfe671b7d65b8143e5a5e13d2415ec2c
数据显示,仅 2B 参数规模的 Jet-Nemotron 即可超越 Qwen3、Qwen2.5、Gemma3 和 Llama3.2 等当前最强开源全注意力模型,并在 H100 GPU 上实现最高达 53.6 倍的生成吞吐量加速(上下文长度 256K,最大 batch size)。
在 MMLU 和 MMLU-Pro 基准测试中,其准确率甚至超过部分参数量更大的 MoE 全注意力模型(如 DeepSeek-V3-Small 和 Moonlight)。
早在 2024 年,顾煜贤与其合作者便提出一种面向大语言模型的知识蒸馏新范式:用反向 Kullback-Leibler 散度(KLD)替代传统正向 KLD 目标,并据此推导出一套稳定高效的优化方案。
该方法产出的学生模型被命名为「MiniLLM」。大量指令遵循任务实验表明,MiniLLM 不仅回答更精准、整体质量更高,还展现出更低的曝光偏差、更强的校准能力以及更优的长文本生成能力。
目前,谷歌、阿里巴巴、英伟达等多家头部开源社区与工业界平台均已集成并应用该技术。
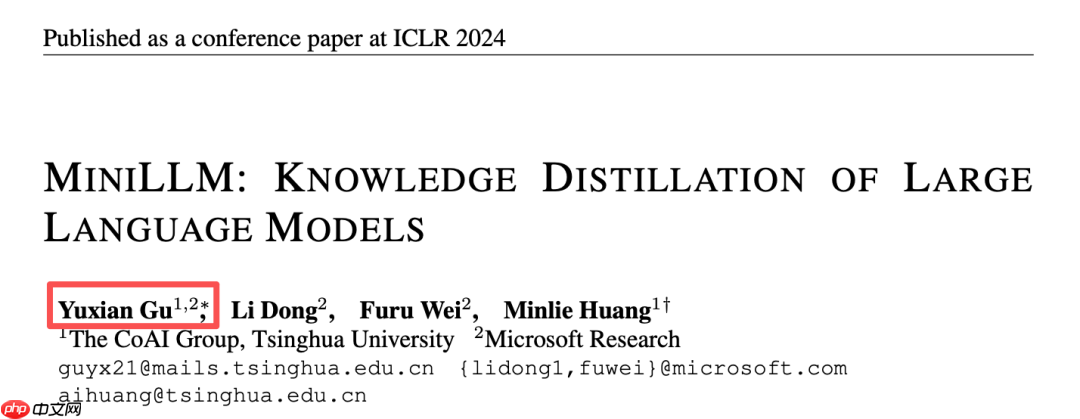
论文原文:https://www.php.cn/link/5a4bc6dc8ecfdba359ba0ebf03e90bd6
我们也热切期待顾煜贤在人生下一程「DeepSeek」之旅中,持续产出更具影响力的研究成果与技术突破。
本文源自微信公众号“机器之心”(ID:almosthuman2014),作者:关注AI人才的机器之心,36氪经授权转载。














