


模型搞不出起色,小扎开始盯上基础设施了。
起因是Meta接连遭遇多重挫折:Gemini模型访问受限、小扎公开承认AI agent研发进度滞后于预期、员工士气跌至二十年来最低点……
总之真是流年不利。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
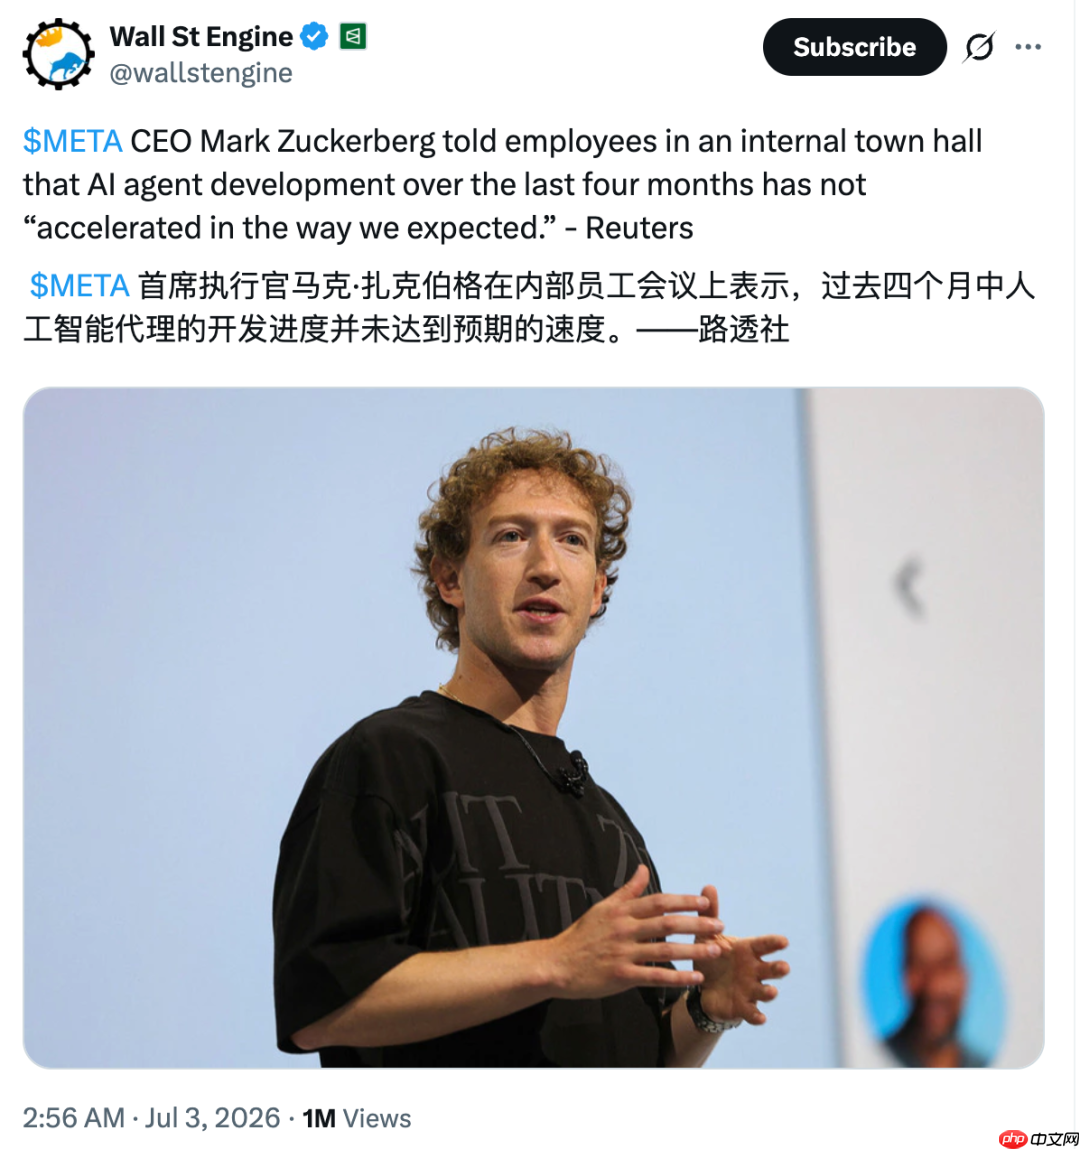
但没关系,小扎灵机一动,迅速启动Plan B。
既然自研模型一时难见突破,那不如干脆卖GPU!
据彭博社消息,Meta正筹划推出名为Meta Compute的云服务项目,计划将旗下庞大的AI算力基础设施向外部客户开放。
好家伙,果然还是卖铲子更稳当……
Meta要卖GPU了
既然要卖铲子,那Meta手里的“铲子”到底有多少?
根据SemiAnalysis最新披露,Meta不仅没有放缓数据中心与算力采购节奏,反而正加速扩张。
仅2026年前六个月,Meta已在云服务与托管数据中心领域签下超5GW容量协议——这还尚未计入其正在紧锣密鼓推进的自建数据中心项目。
目前,Meta正在建设的两大核心数据中心园区,合计承载能力已达2.5GW。
而自2024年初至今,Meta签署的数据中心及算力相关合约总量已逼近10GW。
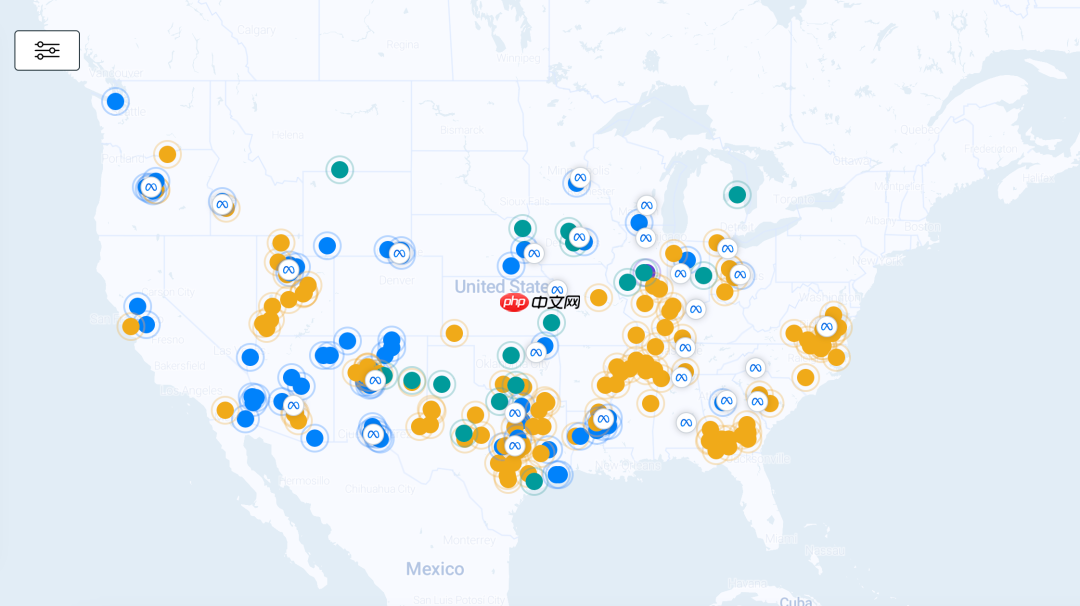
地图上这些密集分布的节点,正是小扎对外出租算力的底气所在。
这批算力主要流向四大方向:
第一,持续支撑自家大模型迭代,包括MSL团队已发布的Muse Spark,以及正在高强度训练中的下一代模型Watermelon。
第二,深度赋能广告推荐系统。SemiAnalysis指出,Meta或有意将广告系统的建模复杂度提升十倍,借助更多训练与推理资源拉升广告变现效率。
第三,效仿SpaceX模式开展neocloud算力租赁,以高价向第三方客户出租部分闲置算力。
参照SpaceX同类高规格租赁合同标准,每GW年收入可达约500亿美元。
仅需释放200MW算力,Meta即可实现年入100亿美元,且毛利率极高。
啧啧,这笔账确实很香~
值得一提的是,SpaceX开创的弹性合作机制——三年期合同但允许双方在90天内无条件终止——实质等同于“三个月一签、自动续期”。
这意味着Meta可随时收回算力,优先保障MSL内部模型训练需求。
第四,托管第三方闭源模型。
SemiAnalysis研判,Meta正与Anthropic展开最终阶段谈判,有望获得Claude私有实例部署权限。
未来,Meta将构建类似Amazon Bedrock、Microsoft Foundry、Google Vertex的统一模型服务平台。
即:将Claude等第三方模型部署于自身基础设施之上,再打包面向企业客户销售。
对Meta而言,此举至少具备三层价值:
第一,满足内部调用需求。
Google刚刚收紧Meta对Gemini的使用权限,而Meta很可能迅速转向Claude作为替代方案。
毕竟其AI项目亟需大量高质量token,而Claude当前正是全球顶尖模型之一。
第二,对外提供商业化服务。Meta可如亚马逊Bedrock一般,推出Claude-as-a-Service。
客户无需自行对接Anthropic、部署运维,只需通过Meta平台调用API即可。
第三,打造垂直行业解决方案。依托自身广告生态,Meta或将集成前沿AI Agent能力,推出销售与营销类SaaS产品。
SemiAnalysis预测,Meta或将很快官宣相关合作,Anthropic极可能是首个签约方,但OpenAI或Google亦存在潜在合作可能。
一旦Meta算力业务落地,它的竞争对手将不再局限于OpenAI、Anthropic、Google等模型厂商。

使用AIsa生成图像与视频。仅需一个API密钥即可调用Gemini 3 Pro Image(图像)和Qwen Wan 2.6(视频)。
它还将直接切入AWS、Azure、Google Cloud,以及CoreWeave、Nebius等AI云服务商的竞争赛道。
消息传出后,资本市场反应迅速:
Meta股价单日飙升近9%,而CoreWeave、Nebius等neocloud企业则遭遇大幅抛压。
华尔街显然读懂了小扎的新叙事逻辑:
模型虽未赢,GPU先赚钱!
为啥要卖算力:搞模型太烧钱
小扎从模型攻坚转向基础设施变现,最根本动因在于:
模型研发,实在太烧钱了!!!
Meta官方公布的2026年资本开支指引已上调至1250亿–1450亿美元。
作为参照,Meta今年一季度资本开支已达198.4亿美元。
反观模型进展,却令人略感焦虑:
Llama系列开源影响力巨大,但商业转化仍待突破;
最新自研模型Muse Spark虽已上线,尚不足以助Meta重返技术第一梯队。
眼下,Meta内部正全力训练下一代模型Watermelon(西瓜),据称算力投入较Avocado高出一个数量级。
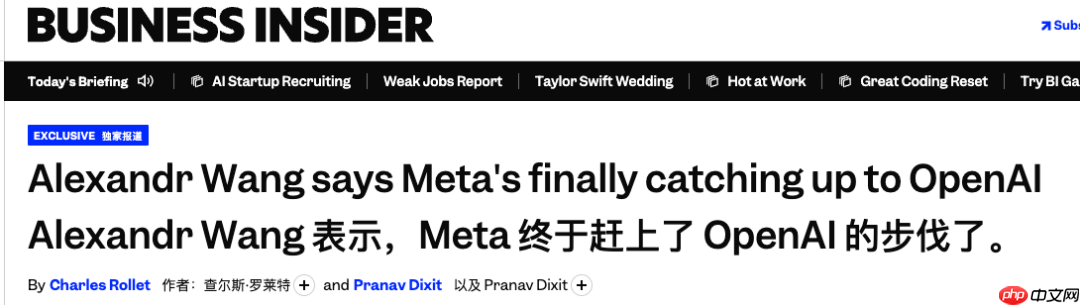
亚历山大王透露:目前Watermelon性能已追平GPT-5.5。
与此同时,Muse Spark新版也即将发布,在编程能力与智能体功能方面将迎来显著跃升。
当被问及何时能推出媲美Claude Opus的模型时,王回应道:
很快就会了!
(小王你别光说,赶紧发啊)
归根结底,Meta的AI战略始终锚定一个朴素目标:
追上OpenAI、Anthropic和Google。
为此,小扎不惜重金投入——芯片、数据中心、顶尖人才,全部按顶配规格配置。
但现实是,资金到位了,Meta却尚未真正赢得开发者与客户的广泛信任,让他们确信自家模型已跻身行业最前沿。
当模型进展难以短期兑现,算力就成了华尔街最容易估值的硬资产。
因为GPU与数据中心本身具备明确标价能力。
这些资源既能出租、托管模型、售卖API,也能服务广告主、支撑AI Agent SaaS,还能持续优化广告推荐系统。
就像原本Meta在讲一个遥远的故事:
相信我,我们会造出超级智能。
而现在这个故事变得更实在了:
即便超级智能还没到来,这些GPU绝非沉没成本。
当然,卖算力绝不等于放弃模型自研。小扎的Plan A仍是通往ASI的终极征途。
继续抢人、继续堆卡、继续训练更大模型、继续追赶“御三家”。
在通向通用人工智能的路上,小扎永不言退!
只不过,前沿模型竞赛不确定性太高,中途适度灵活调整,也是务实之举。
参考链接:
[1]https://www.php.cn/link/587b7f5fe70b6ee17ec29beb9f57ccc0
[2]https://www.php.cn/link/c14342b678b4a4f245687aa47fc7769d
本文来自微信公众号“量子位”,作者:听雨,36氪经授权发布。













